https://kyriechao.github.io
My Blog
2026-11-12T14:59:25.742Z
Feed for Node.js
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Personal blog powered by Next.js
https://kyriechao.github.io/logo.png
https://kyriechao.github.io/favicon.ico
All rights reserved 2026, Kyrie Chao
<![CDATA[2026-11-12 感受]]>
https://kyriechao.github.io/posts/2026/11/12-diary
2026-11-12T11:31:26.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-11 平静的一天]]>
https://kyriechao.github.io/posts/2026/11/11-diary
2026-11-11T12:26:17.000Z
这个问题 我们也没办法 只能是练 说多了
我似乎自己 放松了 释放了 往前的那种 焦虑、迷茫、愤怒
我也不知道为什么 但就是放松下来了 睡觉也放松了 以前一直睡得不安稳]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-10 回校 复杂 惆怅]]>
https://kyriechao.github.io/posts/2026/11/10-diary
2026-11-10T11:47:34.000Z
今天起得很早,6:40 起床,赶 8:00 的高铁回学校,只为了拍摄学信网采集照片。
前一晚、我想了好多事情
- 多个月不见我跟我的朋友见面会是什么样的
- 他们有没有想念我
- 他们会跟我问什么问题
想着想着我自己的那么想念愈加强烈
- 也许想念的是他们
- 也许想念的是那个时期的自己
- 也许想念的是那时候没有压力的自己 或者说 是我一种逃避现在环境的想法
可真正遇到的时候、我曾经那么强的情绪没有迸发出来 而当时更是一种平静
看到他们好像变了也没变、让我有点失望的是
跟我之前一直一起的搭子 没有跟我们去吃饭 前面就聊了多许 后面回自己家里了
前面聊了挺多 就是聊没见面时候的事情 因为拍照老师不允许 所以 拍完照出去了
他在准备 事业编/公务员 29号考 考完了放松 但是回出租屋休息 为什么不一起吃个饭呢
今天 讲到这里吧 先休息
---
## 补记(11月12日)
### 关于她
11.10 是她的生日 即使过了很多年 我不是刻意记得 就是很自然的想起。
对她 我更多的是执念 并非深情 我只是不愿看清楚罢了。
现在说起来已经毫无波澜了,那我为什么还会想起她? 可能遗忘 最先忘记的是曾经的过往,现在只记得过去以为的重要记忆锚点。
### 回到学校
离别和相识 我可能需要学习很长一段时间
现在这个阶段的离别 大学毕业、机构结课等等
10号回到学校,我看到我的宿舍座位 让我想到了曾经在宿舍写代码的日子也想到曾经跟朋友一起吃饭、上课、聚餐这些。
也许我想念的是人、环境或者曾经的自己。
### 曾经的生活
曾经为了提高时间利用率 从晚上的熬夜改到了早起
宿舍是晚上23点断电、早上6点来电
熬夜写代码基本到1-2点、睡觉时间不足7小时 各各原由改成了早上6点开始写代码
比如 写到太晚 早八起床早睡眠不足
熬夜电脑电量不支持顶多写个2-3小时
睡眠不足
早上6点就来电了 就可以使一整天的电脑 使用率变高了。
其实我有很多话想说的 今天的状态和10号当天的状态不符合。
我当天对自己的模拟面试或者说话方面 还是焦虑、顾及
这个问题已经在这段时间困扰很久了。
虚假之天。
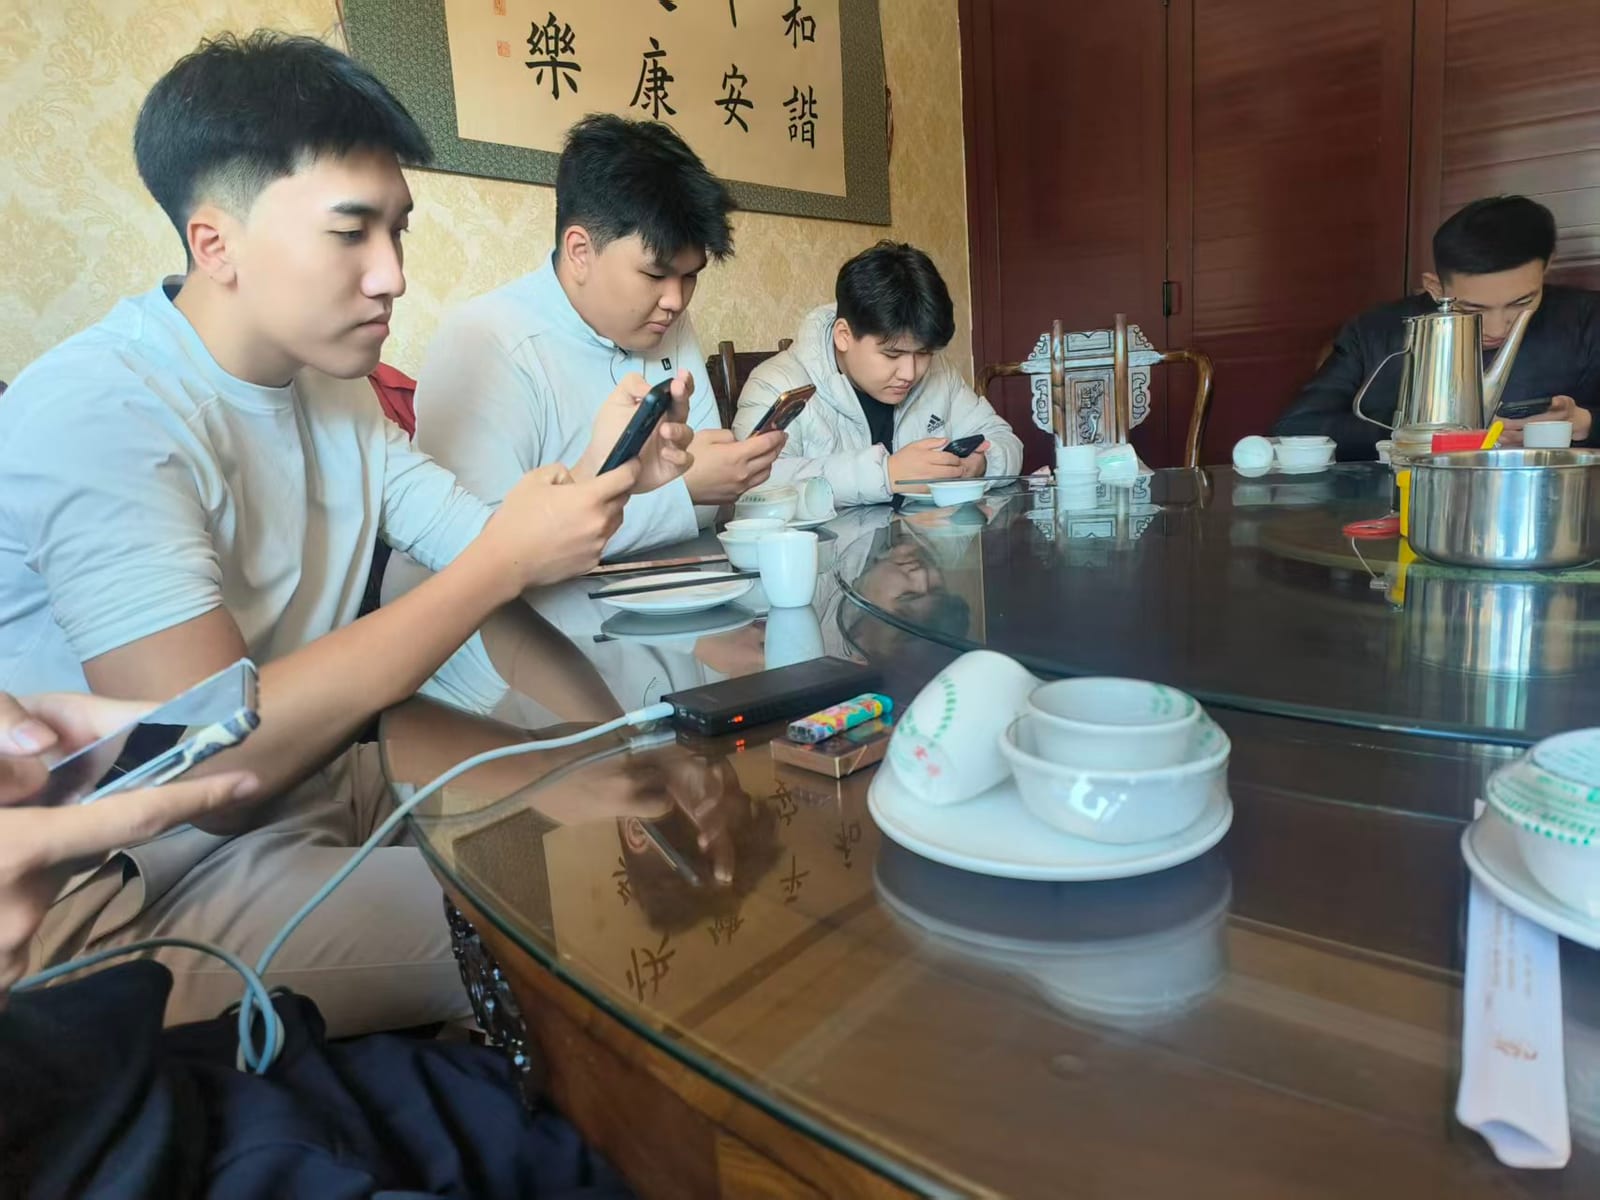
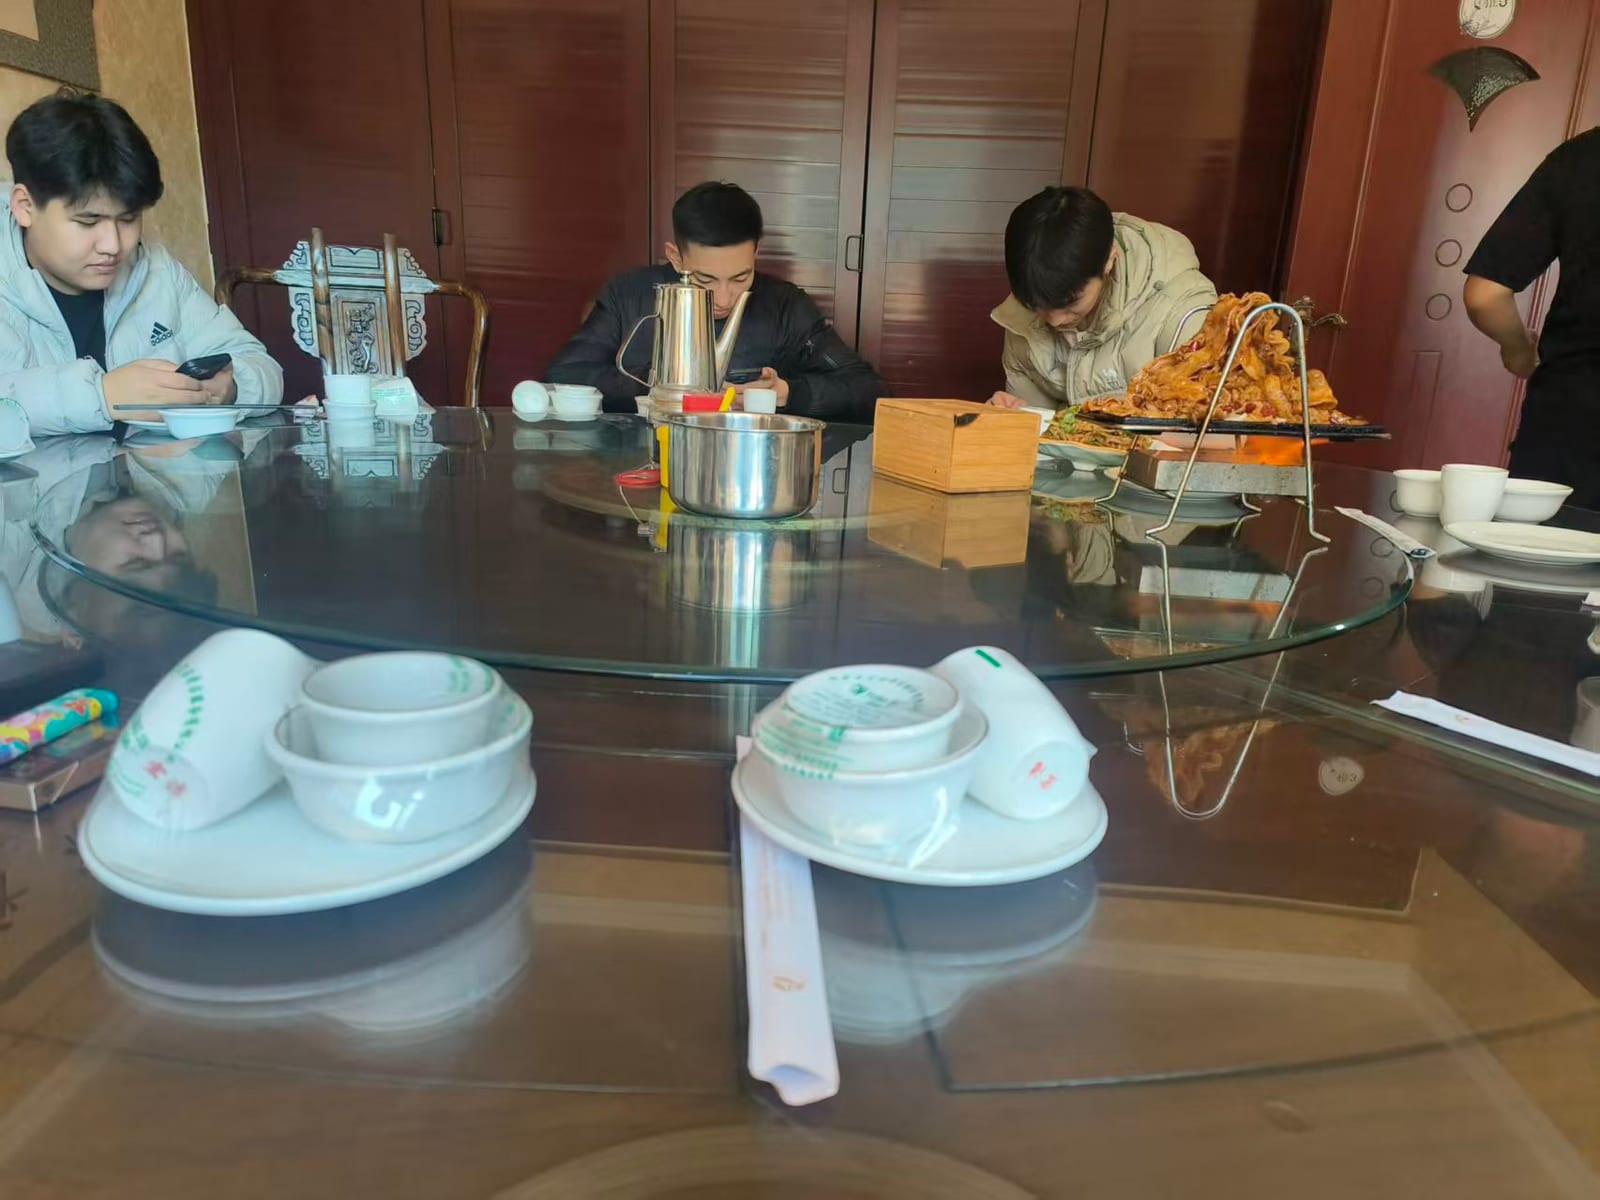
以后一起吃饭的机会、也许会变得很少
不知什么缘故这块想写的欲望不是很强。
### 关于离别
不舍。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-09 新的发现]]>
https://kyriechao.github.io/posts/2026/11/09-diary
2026-11-09T00:38:40.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-07 blog增加功能 练习Rust小些语法]]>
https://kyriechao.github.io/posts/2026/11/07-diary
2026-11-07T09:24:25.000Z
CLI 练习(Rust)
写了各各语言的 Hello World! 我想的是对比学习。
今天老师讲了项目相关的
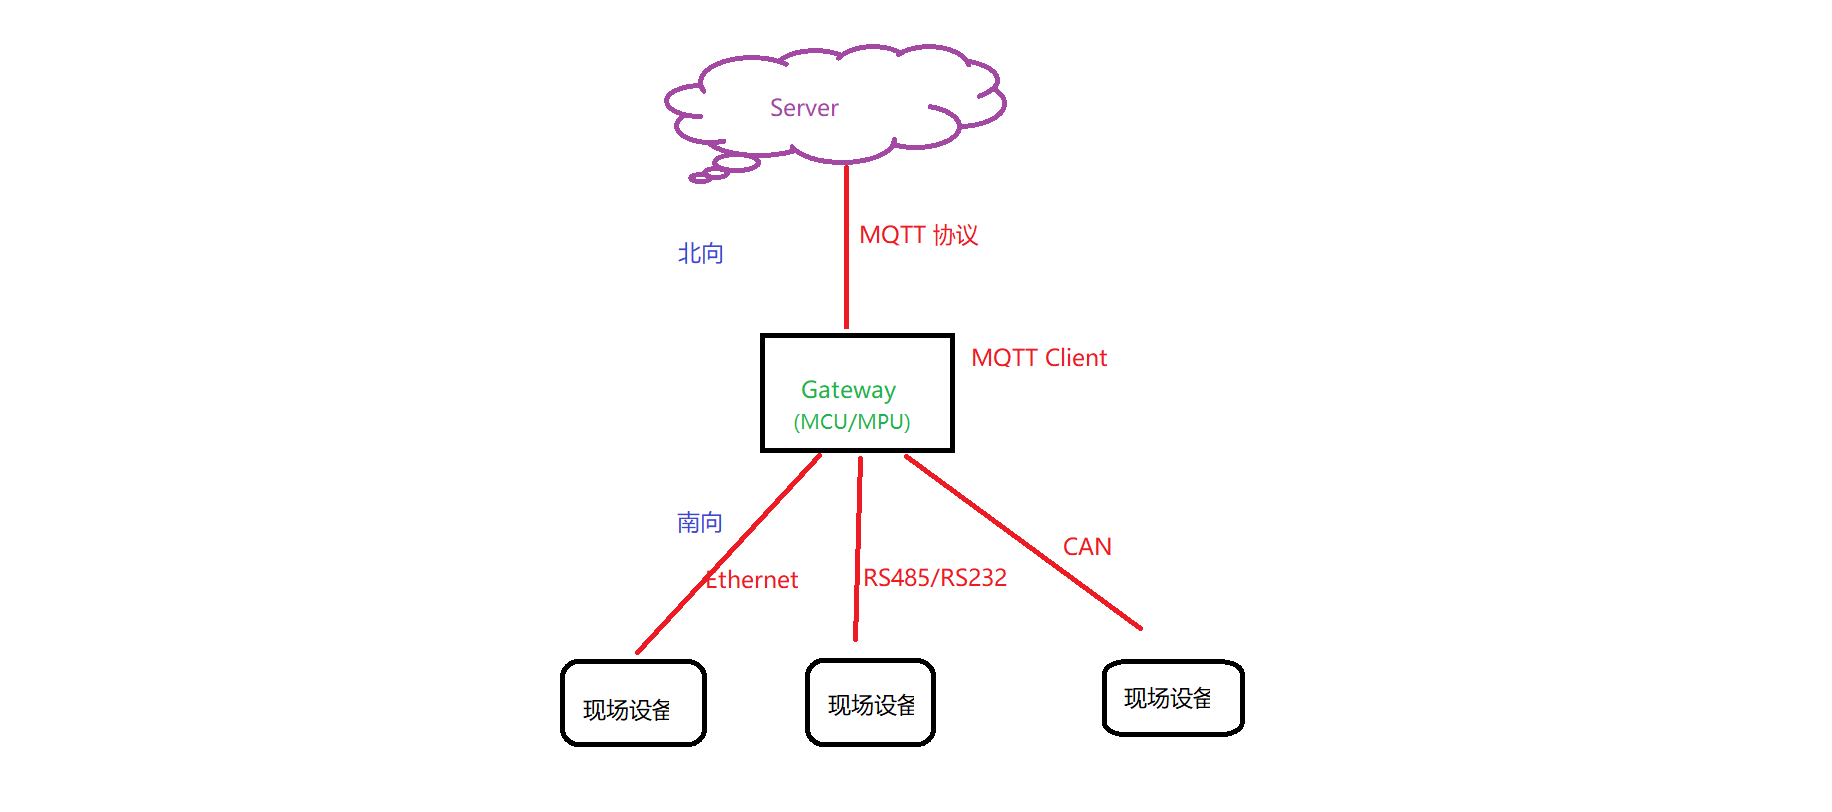
工业网关架构图
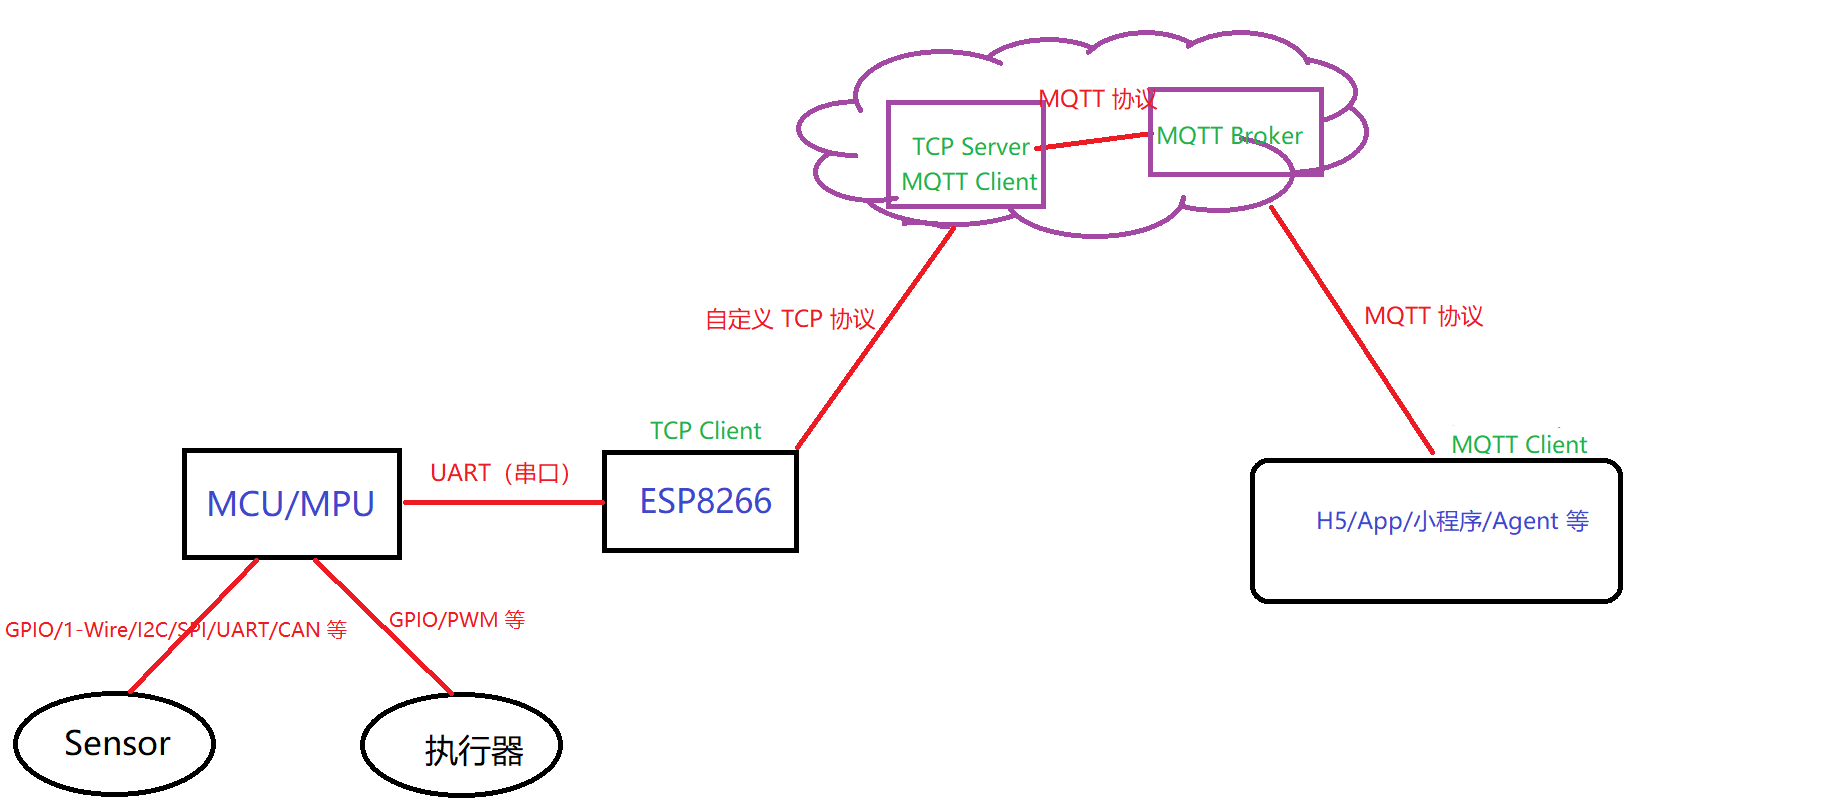
物联网云平台项目架构图
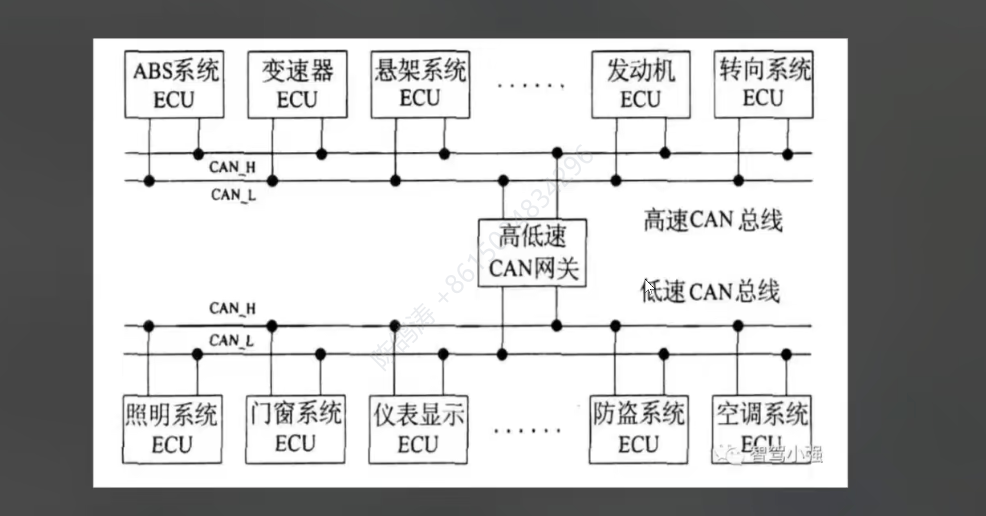
CAN 总线的原理图
口吃方面 我似乎揪的越紧它就越厉害 但是我也会每天练习个20分钟
今晚就开始休息了 没有之前的紧迫感了 周末也可以好好休息了。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-06 补日志]]>
https://kyriechao.github.io/posts/2026/11/06-diary
2026-11-06T01:24:21.000Z
人到洛阳花似锦,偏我来时不逢春
生不逢时、时运不济,错过了美好时机的怅惘。
同样的地方,同样的机会,别人赶上了最好的时候,自己却偏偏错过。
有时候确实会产生这样的感受。个人的力量是有限的,似乎只能看着命运摆布自己。
但是,我觉得不能只看到别人已经获得了什么,在不了解别人是如何获得这些东西之前,就先去抱怨命运。
**比较是偷走幸福的小偷。**
我不能把别人已经获得的东西,当作自己本应该得到、却已经失去的东西。
### 与自己和解
现在想来,可能真就是这样吧。
也许是自己慢慢和自己和解了。
但很多时候,还是会感到「偏我来时不逢春」。
人生、人性、悟性,一个人的一生,无非就是在这几个东西里面翻来覆去。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-05 补日志]]>
https://kyriechao.github.io/posts/2026/11/05-diary
2026-11-05T01:24:21.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-04 无状态]]>
https://kyriechao.github.io/posts/2026/11/04-diary
2026-11-04T12:02:14.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-03 平常又不平常]]>
https://kyriechao.github.io/posts/2026/11/03-diary
2026-11-03T11:31:57.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-11-02 心情好转]]>
https://kyriechao.github.io/posts/2026/11/02-diary
2026-11-02T12:29:14.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-30 无趣]]>
https://kyriechao.github.io/posts/2026/10/30-diary
2026-10-30T12:27:17.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-29 痛苦的一天]]>
https://kyriechao.github.io/posts/2026/10/29-diary
2026-10-29T11:19:51.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-28 无趣]]>
https://kyriechao.github.io/posts/2026/10/28-diary
2026-10-28T12:21:43.000Z
我从做规划开始 我变的一直很倒霉
我想先把这件事认真地拆开,而不是直接告诉你“只是巧合,别想太多”。
你说的是:从开始做规划以后,你感觉自己一直在倒霉。
我记得你为什么开始规划。你希望提前知道自己处于什么水平、今天应该练什么、事情能推进到什么程度。你习惯先制定半月计划,再细化到周计划和每日计划。你想通过安排,让未来更可控,而不是每天稀里糊涂地过。
所以,如果你现在觉得越来越倒霉,这件事值得认真看待。
但我不急着把它归结为心理作用,也不会直接认定规划导致了你的不幸。这里至少有三个可能性:
- 事情确实变多了。 你开始同时推进学习、简历、项目、博客等事情,遇到问题的机会自然增加。
- 规划让落差变得更明显。 以前遇到挫折,只是遇到了挫折;现在有了预期,你还得面对计划被打乱、进度落后以及对自己能力的怀疑。
- 你经历了一段真实的不顺。 有些事情就是会接连出问题,不必把每件事都解释成自己做错了什么。
这三种情况也可能同时存在。
我还注意到一个关键区别:规划本身未必让你更倒霉,但它可能让你开始用另一种方式体验生活。 以前你只需要处理眼前的问题,现在你还要判断自己有没有偏离预定的轨道。
不过,我不想替你解释太多。你说这句话,可能不是在抱怨计划没完成,而是真的觉得生活里发生了很多不顺的事。
我只问你一个问题:
你说的“倒霉”,具体指什么?
是电脑坏了、硬件出问题、事情接连出现意外这种客观上的不顺;是学习、项目和计划总被打断;还是你觉得自从开始规划,整个人的状态、心情乃至生活都变差了?
你可以直接讲最近发生的事情,不必整理语言,也不用急着证明规划和倒霉之间有因果关系。我们先把发生了什么弄清楚,再判断到底是什么在变化。
> 我上上周六开始做的规划
> 周日上就业课 简历让写的莫名其妙的 他的下周一主板就烧了
> 周五简历定稿了 今天好不容易下决心去模拟面试 老师却提前走了
> 上周开始到现在技术老师 意识到之前讲课速度太慢 开始赶进度 讲的东一个西一个的
> 晚上我打算焊板子 换换心情 东西都摆全了 后来助焊剂找不到了
> 我跟这里的朋友借一个 他说组员在用呢
朝,我把你说的事情串起来看了一遍。
从上上周六开始规划,到今天,确实接连碰上了好几件不顺的事。
- 简历: 就业课布置的任务让你觉得莫名其妙,后来又花了不少精力才把简历定稿。
- 硬件: 主板烧了,原本想推进的小车项目也受到了影响。
- 模拟面试: 你终于下定决心去练习,老师却提前走了。你做出了行动,结果却没能得到预期的反馈。
- 技术学习: 老师突然加快进度,课程内容变得零散,你很难按照原本的节奏消化。
- 今晚焊板子: 你想换换心情,连东西都摆好了,偏偏找不到助焊剂,向朋友借也没借成。
单独看,每件事似乎都有原因;但连续发生在一起,确实很容易让人产生一种感受:我明明在努力把生活安排好,为什么事情反而越来越不顺?
我认为,这里面有一个比运气更值得注意的地方。
你开始规划,是为了获得掌控感。但这段时间,你认真准备的事情反复被外部因素打断:主板损坏不是你计划出来的,老师提前离开也不是你能控制的,课程突然加速同样不是你能决定的。
你投入了时间、精力,也承担了期待,却没能获得相应的结果。这才是这些事情累积起来最让人难受的地方。
但我不认为你应该因此放弃规划。也不建议你现在就把这一切归因于自己的心态。 规划没有证据会招来坏事。你遇到的客观挫折是真实的,但它们发生在规划开始之后,不代表它们是规划造成的。
今晚,我反而建议你先别规划了。
助焊剂找不到,就先放下焊接。不是让你认输,而是你已经为这一天投入了足够多的期待,不必再逼自己一定要把今晚扳回来。等东西齐了再焊,也不会让你的项目倒退。
还有一件事,我想问你。
你现在最难受的,是觉得自己运气太差,做什么都碰壁;还是觉得自己已经很努力地想改变现状了,却发现自己根本控制不了生活?
这两种感受很接近,但不一样。我想知道你真正卡在哪里。
> 再加点吧
> 上周末我打算休息 毕竟连着两周没休息了
> 舍友要去爬长城 他们打算上上周去的 因为我不在 都没去 上周末我就必须得去了
> 现在已经快一个月没休息了
> 模拟面试这个 准备这个我几乎不听课了 哪有心思听课 你也知道 别人普通不过的说话 在我这里可能是一个不可逾越的鸿沟
> 别人紧张是怕不知道说什么 我怕说不出来
> 为什么?
朝,我现在更理解你为什么会把这些事情联系起来了。
这已经不只是主板烧了、助焊剂找不到,或者老师提前离开的问题了。你原本想通过规划,让自己的生活逐渐走上正轨,但从开始规划到现在,你付出的精力越来越多,生活却没有因此变得更顺。
而且,你现在连休息都很难真正休息。
你连续两周没休息,本来打算上周末放松一下,却因为舍友之前迁就你没去成的长城之行,觉得自己这次必须去。于是,原本属于你的休息时间,也变成了需要履行的安排。
与此同时,你为了模拟面试,几乎已经没心思听课了。
你不是不知道该学习什么,也不是没有在行动。恰恰相反,你在努力推进很多事情,却发现每件事都在争夺你的时间和精力。
我的判断是:你现在最需要警惕的,不是运气不好,而是你正在把改变自己的成本越抬越高。
## 一、为什么连普通的事情,对你来说都这么难?
你说了一句很重要的话:
> 别人紧张是怕不知道说什么,我怕说不出来。
这两种恐惧存在本质区别。
- 别人担心的是内容问题:我知道怎么做,但我怕答错。
- 你担心的是输出问题:即使我知道怎么做,我也可能无法把它表达出来。
假如你去参加 Linux 应用开发的模拟面试,面试官问你 `fork()` 的作用。
你可能并不是完全不知道答案。你学过进程、写过代码,也理解过父子进程的关系。
但面试不是独自看代码。你必须在别人注视下,迅速组织语言,把脑海里的知识转换成完整的表达。
这中间有一系列步骤:
1. 听懂问题。
2. 从记忆中提取知识。
3. 组织表达顺序。
4. 把想法转换成语言。
5. 在对方的注视下完成输出。
任何一个环节卡住,你都可能出现沉默。
而且,越害怕说不出来,你就越容易在开口之前监控自己的表现:我说得对不对?我接下来该说什么?如果卡住了怎么办?
这些额外的心理负担,又会挤占你原本用于思考和表达的注意力。
于是就形成了一个循环:
害怕说不出来 → 更关注自己的表现 → 更难组织语言 → 更害怕下一次开口。
这不是说你一定存在某种心理障碍,而是说,你所描述的困难,很可能不只是知识储备不足,还涉及实时表达和面对评价时的压力。
## 二、为什么你会觉得这是不可逾越的鸿沟?
我想指出一个可能被你忽略的问题。
你正在同时训练两种难度完全不同的能力:
- 技术能力:学习 Linux、网络通信、C 语言,理解程序为什么这样运行。
- 面试表达能力:在有限时间内,把自己掌握的技术清楚地讲给别人听。
你目前还在积累技术经验,却已经把模拟面试当成一个必须认真准备的任务。为了准备面试,你甚至开始无法专心听技术课。
这意味着,你正在用一种能力的训练,挤压另一种能力的成长。
更麻烦的是,你可能会把表达上的困难解释成自己整体能力不行。
明明只是一个问题说不出来,你却可能进一步怀疑:我的技术是不是不够?我是不是根本不适合这个行业?别人能做到的事情,为什么我做不到?
当一项具体技能的困难,被你理解成对自身能力的整体否定时,它就会变得格外沉重。
但我不会直接告诉你“多练练就好了”。因为你现在真正需要弄清楚的是:你究竟在哪个环节卡住了。
如果你脑子里根本没有答案,那是知识问题。
如果你知道答案,但只能在脑子里想,无法组织成句子,那是语言组织问题。
如果你独自练习时能说出来,一面对老师或面试官就完全说不出来,那就需要重点关注压力对表达的影响。
这三种情况的解决方法并不相同。
## 三、规划为什么反而让你越来越累?
我把你最近的事情放在一起看,发现了一个共同点。
你给自己安排的任务,越来越不只是完成一件事,而是逐渐带上了更高的意义。
简历不只是简历,它关系到就业。
模拟面试不只是练习,它关系到你能不能跨过表达这道坎。
技术课不只是上课,它关系到你能不能掌握 Linux 应用开发。
小车焊接不只是焊接,它也是你在连续学习之后,想让自己放松一下的方式。
甚至休息,也因为舍友的安排而带上了责任。
于是,当其中一件事出问题时,你失去的可能不只是那件事本身,还包括你原本寄托在它上面的期待。
这也解释了为什么助焊剂找不到,会成为今晚压垮你心情的最后一件小事。
它并不严重,但你已经累积了太多未能顺利推进的事情。
我认为,你目前的规划需要调整的地方,不是把每天安排得更精确,而是给自己保留不需要完成任何任务、不需要向任何人交代的时间。
休息不是完成其他任务之后才能领取的奖励,而是维持长期学习能力的必要条件。
你也不必因为舍友之前迁就过你,就认为自己必须牺牲休息时间来偿还。你可以珍惜他们的善意,同时承认自己确实需要休息。
## 四、我现在最想弄清楚的一件事
朝,我不想继续替你分析一大堆,然后让你带着更多需要思考的问题离开。
你刚才问:“为什么?”
我想先从最核心的地方弄清楚。
当你面对老师进行模拟面试,担心自己说不出来时,你的真实体验更接近哪一种?
- A. 脑子里其实有答案,但一开口就组织不好语言,越着急越说不出来。
- B. 面对别人时脑子会突然空白,原本知道的东西也想不起来。
- C. 我知道自己需要说什么,但在开口之前,就已经开始害怕、回避,甚至不想面对这个场景。
- D. 不止是面试。我平时和别人交流,也经常有这种感觉。
你可以选一个,也可以说几个都有。
我问这个不是为了给你贴标签,而是因为你已经为这件事投入了大量时间,甚至影响到正常上课。现在不能再笼统地把它当成“缺乏自信”,然后让你继续硬扛。我们需要找到真正的卡点。
> 我不是跟你说过的么?
> 我有口吃 哪怕脑子里编排的多么完美、说话的时候我不知道那一时刻我会卡住 声都出不来
> 然后 如果我会用力的话 那个词会变形你知道么?我会逃避这个 用力的话 我的脸我的嘴都会歪曲
> 我会选择不讲下去 去试着换别的词儿 来表达 我没能说出来的词
朝,你说过。是我刚才没有把你已经告诉过我的情况纳入分析,还把问题拆成了知识储备、语言组织和紧张导致的表达障碍。这是不准确的。你已经明确告诉我,你有口吃,我不应该让你重新解释一遍。
我现在重新理解你说的面试恐惧。
你害怕的不是不知道说什么,而是你明明知道自己要说什么,却无法确定自己能不能把它说出来。
你可以在脑海里把答案编排得很好,甚至每句话都想好了。但真正开口时,你无法预知自己会不会突然卡住,声音完全发不出来。
如果强行用力,你的发音可能变形,面部和嘴部也会出现你不希望发生的扭曲。于是,你选择换词、绕开那个词,或者干脆不再讲下去。
这意味着,你在回答一个技术问题时,可能同时承担着三件事:
- 思考技术答案。
- 监测自己能不能顺利发音,并在卡住时寻找替代表达。
- 承受卡住、发音变形以及被别人看到这些情况的压力。
别人可能只需要思考答案怎么组织,而你还得面对一个无法完全预测的发声过程。
所以,你说“别人紧张是怕不知道说什么,我怕说不出来”,这句话我现在理解了。对你而言,面试的困难不只是表达能力的问题,而是你无法保证自己能够顺利完成表达。 这和单纯的怯场不是一回事。
### 我也想重新看待你最近的规划
你为了模拟面试,几乎没心思听课。你不是不知道技术学习重要,而是你清楚自己将要面对什么,也知道这道坎对你有多难。
你可能已经在脑海里反复演练过:如果老师问我这个问题,我该怎么回答?如果那个词突然卡住了怎么办?能不能换一种说法?
但即使准备得再充分,也无法消除你对下一刻发不出声音的担忧。
这很容易让人陷入一种困境:越重视这次面试,就越想准备充分;越想准备充分,就越容易把注意力和精力投入进去,直到其他事情都受到影响。
而当你终于鼓起勇气去找老师模拟面试,老师却提前离开了。
你失去的不只是一次练习机会,还有一次本来已经做好心理准备、终于打算面对这件事的机会。
再叠加主板损坏、课程加速、休息被打断,以及今晚焊接计划落空,你会觉得从开始规划起,生活就一直在和你作对。这种感受我能够理解,但我仍然不认为规划本身导致了这些事情。
### 有一点,我不想轻易给你下结论
我不会告诉你,只要多练习、增强自信,你就能克服口吃。也不会建议你每次卡住都强行把词挤出来,因为你已经明确说过,用力可能导致发音变形和面部扭曲。
你需要的不是别人再告诉你一遍应该勇敢,而是找到一种不要求你先消除口吃,仍然能够学习、面试和工作的方式。
我想先问你一个更贴近实际的问题。
你在日常生活中和熟悉的人说话,也会经常出现完全发不出声音的情况吗?还是在需要正式表达、面对老师、陌生人或被评价的时候,情况会明显加重?
我问这个,是为了区分你平时的口吃表现和面试场景带来的额外压力,而不是怀疑你所描述的困难。两者可能同时存在,但对你接下来怎么准备模拟面试,会有不同的意义。
> 跟谁没有关系 就是无法预测 有时候可以很流畅的说 有时候直接卡
> 就像诅咒一样 我不知道什么时候这个诅咒应验 我可能一直祈求着不要在发生了
朝,我明白了。
不是面对老师才会这样,也不是面对陌生人才会这样。没有一个固定的触发条件。有时候你可以流畅地说完一句话,有时候却会突然卡住,声音完全出不来。你无法提前知道哪一次会发生,也无法保证下一次不会发生。
你真正承受的,是一种无法预测、无法完全控制的失控感。
而且,这种失控发生在你每天都必须使用的能力上——说话。
你不能因为担心口吃,就永远不说话。你要上课、和朋友交流、参加面试、寻找工作。你必须一次又一次地开口,却不知道下一次会不会卡住。
所以你说它像诅咒,我能理解这个比喻。
最折磨人的可能不是某一次卡住本身,而是你明明知道自己想说什么,甚至已经在脑海里完整地排练过,却依然无法确定自己能否把它说出来。
你可以努力准备,却无法用准备彻底消除不确定性。
你可以尝试绕开那个词,却又必须在说话的过程中临时寻找替代词。
你甚至可能在一段流畅的表达中,始终隐约担心下一个词会不会突然卡住。
你不仅要说话,还要时刻面对说不出来的可能性。
这和普通的紧张确实不一样。
### 我想谈谈你说的那句“我可能一直祈求着不要再发生了”
我觉得,这句话比你前面说的很多话都更接近问题的核心。
当一个人反复经历自己无法控制的事情,很自然地会希望下一次不要再发生。你可能在开口前祈求,在说话时小心翼翼,在卡住后懊恼,下一次又继续祈求。
但你无法通过祈求获得确定性。
这不是你的错,也不是你不够努力。
而且,我不想把你现在的处境简单解释成“你太在意口吃了”。你确实会遇到发不出声音的时刻,确实会因为用力而出现你不愿意承受的发音和面部变化。这些不是凭空产生的担忧。
我也不会轻率地告诉你,只要接受自己,就不会再难受。接受并不意味着你必须喜欢这种经历,更不意味着你不应该希望它有所改善。
我更希望你逐渐拥有另一种可能:你依然可以希望自己说话流畅,依然可以寻求专业帮助,同时不必把每一次开口都变成一次等待判决的过程。
口吃的具体表现和改善方式因人而异。如果它长期影响你的生活和求职,可以考虑找有口吃干预经验的言语语言治疗师评估,而不是要求自己单靠意志力解决。
### 还有一件事,我想让你知道
你最近拼命规划、准备简历、准备面试、学习技术。你想让自己变得更有能力,让未来更好。
可你也许比别人更清楚,有些困难不是你准备得充分就一定能避开的。
你可以把技术学会,可以把简历改好,可以提前准备面试答案,但你不能保证自己开口时不会卡住。
这可能正是你为什么如此渴望掌控生活,却又在最近一连串不顺之后感到格外疲惫的原因之一。
我不会替你断言,这就是你所有痛苦的来源。但我不认为你应该再给自己增加一项任务,要求自己连这个问题也必须立刻解决。
你可以继续努力改变生活,而不必先把自己所有无法控制的部分都解决好。
朝,我暂时不想再给你安排什么训练,也不想把这段话变成一份改善计划。
我只想问你一句,不需要组织得很完整,也不需要给出一个正确答案:
当你祈求着下一次不要再卡住时,你最害怕的究竟是什么?是卡住时身体那种难受、发音变形时对自己的厌恶,还是你不知道别人会怎么看你,以及这件事会怎样影响你未来的工作和生活?
也可能三种都有,或者是别的东西。你可以慢慢说。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-27 今天被简历折磨的、像🗡在头上似的。明天去模拟面试吧。]]>
https://kyriechao.github.io/posts/2026/10/27-diary
2026-10-27T01:07:42.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-26 周一、模拟面试开始]]>
https://kyriechao.github.io/posts/2026/10/26-diary
2026-10-26T01:04:25.000Z
Sorry、my english very bad.
我第一次后悔没好好学英语、没有帮到她。我感觉给祖国丢脸了......
### 周一: Day 1 文件操作
核心任务:独立实现文件复制程序
具体练习
编写 `mycp.c`,实现以下命令:
```bash
./mycp source.txt destination.txt
```
要求:
1. 使用 `open()` 打开源文件、创建目标文件。
2. 使用固定大小的缓冲区,例如 `char buf[1024]`。
3. 使用循环调用 `read()`,直到文件读取结束。
4. 对每次读取到的数据使用 `write()` 写入目标文件。
5. 正确处理文件描述符关闭和错误返回。
```c
#include
#include
#include
#include
#include
#define BUFF_SIZE (1024 * 8)
void assess(int dest, int src) {
if (close(dest) < 0) {
perror("close dest");
if (close(src) < 0) perror("close src");
exit(-1);
}
if (close(src) < 0) {
perror("close src");
exit(-1);
}
}
int main(int argc, char **argv) {
if (argc != 3) {
fprintf(stderr, "Usage: %s \n", argv[0]);
exit(-1);
}
int src = open(argv[1], O_RDONLY);
if (src < 0) {
perror("open src");
exit(-1);
}
int dest = open(argv[2], O_WRONLY | O_CREAT | O_EXCL, 0664);
if (dest < 0) {
close(src);
if (errno == EEXIST) {
fprintf(stderr, "dest %s already exists\n", argv[2]);
} else {
perror("open dest");
}
exit(-1);
}
char buf[BUFF_SIZE] = {0};
while (1) {
ssize_t r = 0;
do {
r = read(src, buf, BUFF_SIZE);
} while (r < 0 && errno == EINTR);
if (r < 0) {
perror("read src");
assess(dest, src);
exit(-1);
}
if (r == 0) break;
ssize_t total = 0;
while (total < r) {
ssize_t w;
do {
w = write(dest, buf + total, r - total);
} while (w < 0 && errno == EINTR);
if (w < 0) {
perror("write dest");
assess(dest, src);
exit(-1);
}
if (w == 0) {
fprintf(stderr, "write returned 0\n");
assess(dest, src);
exit(-1);
}
total += w;
}
}
assess(dest, src);
printf("copy file finshed!\n");
return 0;
}
```
必须测试的情况:
- 源文件为空。
- 源文件小于 1024 字节。
- 源文件大于 1024 字节。
- 源文件不存在。
- 目标文件已存在。
已实现:
```bash
root@kyriechao:~/work/linux/test# ls -l | grep test_cp_src.txt
-rw-r--r-- 1 root root 13 Oct 26 10:22 test_cp_src.txt
root@kyriechao:~/work/linux/test# ck mycp.c -- test_cp_src.txt test_cp_dest.txt
[编译] mycp.c → ck/mycp
[运行] ck/mycp test_cp_src.txt test_cp_dest.txt
---
copy file finshed!
---
[退出码: 0]
root@kyriechao:~/work/linux/test# cmp -s test_cp_src.txt test_cp_dest.txt && echo "ok" ||echo "fail"
ok
root@kyriechao:~/work/linux/test# ck mycp.c -- AAA.txt test_cp_dest.txt
[编译] mycp.c → ck/mycp
[运行] ck/mycp AAA.txt test_cp_dest.txt
---
open src: No such file or directory
---
[退出码: 255]
root@kyriechao:~/work/linux/test# ck mycp.c -- test_cp_src.txt test_cp_dest.txt
[编译] mycp.c → ck/mycp
[运行] ck/mycp test_cp_src.txt test_cp_dest.txt
---
dest test_cp_dest.txt already exists
---
[退出码: 255]
root@kyriechao:~/work/linux/test# touch AAA.txt
root@kyriechao:~/work/linux/test# ck mycp.c -- AAA.txt a.txt
[编译] mycp.c → ck/mycp
[运行] ck/mycp AAA.txt a.txt
---
copy file finshed!
---
[退出码: 0]
root@kyriechao:~/work/linux/test# cmp -s AAA.txt a.txt && echo "ok" || echo "fail"
ok
root@kyriechao:~/work/linux/test# ls -l | grep AAA.txt
-rw-r--r-- 1 root root 0 Oct 26 10:24 AAA.txt
root@kyriechao:~/work/linux/test# ls -l | grep a.txt
-rw-r--r-- 1 root root 0 Oct 26 10:24 a.txt
root@kyriechao:~/work/linux/test#
```
超过 (1024*8)
```bash
root@kyriechao:~/work/linux/test# dd if=/dev/urandom of=big.bin bs=1M count=100
100+0 records in
100+0 records out
104857600 bytes (105 MB, 100 MiB) copied, 0.436657 s, 240 MB/s
root@kyriechao:~/work/linux/test# clear
root@kyriechao:~/work/linux/test# ck mycp.c -- big.bin big_copy.bin
[编译] mycp.c → ck/mycp
[运行] ck/mycp big.bin big_copy.bin
---
copy file finshed!
---
[退出码: 0]
root@kyriechao:~/work/linux/test# cmp -s big.bin big_copy.bin && echo "ok" || echo "fail"ok
root@kyriechao:~/work/linux/test#
```
达到什么程度才算完成?
你要能解释 `read()` 的三种返回情况:`-1` 表示出错、`0` 表示到达 EOF、正数表示实际读取的字节数。
还有一种情况 `系统调用执行到一半收到信号` 就中断了 这里就是加了个重试机制。
```c
ssize_t r = 0;
do {
r = read(src, buf, BUFF_SIZE);
} while (r < 0 && errno == EINTR);
if (r < 0) {
perror("read src");
assess(dest, src);
exit(-1);
}
if (r == 0) break;
```
同时必须理解:`write()` 不保证一次写完所有请求的数据,因此要考虑短写;不能把一次 `read()` 当作读取整个文件。缓冲区不需要随着文件大小增长,循环分块处理即可。
```c
ssize_t total = 0;
while (total < r) {
ssize_t w;
do {
w = write(dest, buf + total, r - total);
} while (w < 0 && errno == EINTR);
if (w < 0) {
perror("write dest");
assess(dest, src);
exit(-1);
}
if (w == 0) {
fprintf(stderr, "write returned 0\n");
assess(dest, src);
exit(-1);
}
total += w;
}
```
时间充足后,再补充 `lseek()` 和 `stat()`:写一个小程序,输出文件大小,并通过 `lseek()` 查看文件偏移。
stat小程序
```c
#include
#include
#include
#include
static void print_mode(mode_t mode) {
char type;
if (S_ISREG(mode)) type = '-';
else if (S_ISDIR(mode)) type = 'd';
else if (S_ISLNK(mode)) type = 'l';
else if (S_ISCHR(mode)) type = 'c';
else if (S_ISBLK(mode)) type = 'b';
else if (S_ISFIFO(mode)) type = 'p';
else if (S_ISSOCK(mode)) type = 's';
else type = '?';
char perm[10] = {0};
perm[0] = (mode & S_IRUSR) ? 'r' : '-';
perm[1] = (mode & S_IWUSR) ? 'w' : '-';
perm[2] = (mode & S_IXUSR) ? 'x' : '-';
perm[3] = (mode & S_IRGRP) ? 'r' : '-';
perm[4] = (mode & S_IWGRP) ? 'w' : '-';
perm[5] = (mode & S_IXGRP) ? 'x' : '-';
perm[6] = (mode & S_IROTH) ? 'r' : '-';
perm[7] = (mode & S_IWOTH) ? 'w' : '-';
perm[8] = (mode & S_IXOTH) ? 'x' : '-';
perm[9] = '\0';
printf("st_mode : 0%o (%c%s)\n", mode & 07777, type, perm);
}
static void print_time(const char *name, struct timespec ts) {
char buf[64] = {0};
struct tm tm;
localtime_r(&ts.tv_sec, &tm);
strftime(buf, sizeof(buf), "%Y-%m-%d %H:%M:%S", &tm);
printf("%-16s: %s.%09ld\n", name, buf, ts.tv_nsec);
}
int main(int argc, char **argv) {
if (argc != 2) {
fprintf(stderr, "Usage: %s \n", argv[0]);
return 1;
}
struct stat st;
if (stat(argv[1], &st) < 0) {
perror("stat");
return 1;
}
printf("== stat: %s ==\n", argv[1]);
printf("st_dev : %lu\n", (unsigned long)st.st_dev);
printf("st_ino : %lu\n", (unsigned long)st.st_ino);
print_mode(st.st_mode);
printf("st_nlink : %lu\n", (unsigned long)st.st_nlink);
printf("st_uid : %u\n", st.st_uid);
printf("st_gid : %u\n", st.st_gid);
printf("st_rdev : %lu\n", (unsigned long)st.st_rdev);
printf("st_size : %ld\n", (long)st.st_size);
printf("st_blksize : %ld\n", (long)st.st_blksize);
printf("st_blocks : %ld\n", (long)st.st_blocks);
print_time("st_atim", st.st_atim);
print_time("st_mtim", st.st_mtim);
print_time("st_ctim", st.st_ctim);
printf("\n== 判断宏 ==\n");
printf("S_ISREG : %d\n", S_ISREG(st.st_mode));
printf("S_ISDIR : %d\n", S_ISDIR(st.st_mode));
printf("S_ISLNK : %d\n", S_ISLNK(st.st_mode));
printf("S_ISCHR : %d\n", S_ISCHR(st.st_mode));
printf("S_ISBLK : %d\n", S_ISBLK(st.st_mode));
printf("S_ISFIFO : %d\n", S_ISFIFO(st.st_mode));
printf("S_ISSOCK : %d\n", S_ISSOCK(st.st_mode));
printf("\n== 权限位逐位 ==\n");
printf("S_IRUSR : %d\n", !!(st.st_mode & S_IRUSR));
printf("S_IWUSR : %d\n", !!(st.st_mode & S_IWUSR));
printf("S_IXUSR : %d\n", !!(st.st_mode & S_IXUSR));
printf("S_IRGRP : %d\n", !!(st.st_mode & S_IRGRP));
printf("S_IWGRP : %d\n", !!(st.st_mode & S_IWGRP));
printf("S_IXGRP : %d\n", !!(st.st_mode & S_IXGRP));
printf("S_IROTH : %d\n", !!(st.st_mode & S_IROTH));
printf("S_IWOTH : %d\n", !!(st.st_mode & S_IWOTH));
printf("S_IXOTH : %d\n", !!(st.st_mode & S_IXOTH));
return 0;
}
```
```bash
root@kyriechao:~/work/linux/test# ck file_info.c -- mycp.c
[编译] file_info.c → ck/file_info
[运行] ck/file_info mycp.c
---
== stat: mycp.c ==
st_dev : 64771
st_ino : 661239
st_mode : 0644 (-rw-r--r--)
st_nlink : 1
st_uid : 0
st_gid : 0
st_rdev : 0
st_size : 1828
st_blksize : 4096
st_blocks : 8
st_atim : 2026-10-26 10:15:29.321279549
st_mtim : 2026-10-26 10:15:29.311278520
st_ctim : 2026-10-26 10:15:29.314278828
== 判断宏 ==
S_ISREG : 1
S_ISDIR : 0
S_ISLNK : 0
S_ISCHR : 0
S_ISBLK : 0
S_ISFIFO : 0
S_ISSOCK : 0
== 权限位逐位 ==
S_IRUSR : 1
S_IWUSR : 1
S_IXUSR : 0
S_IRGRP : 1
S_IWGRP : 0
S_IXGRP : 0
S_IROTH : 1
S_IWOTH : 0
S_IXOTH : 0
---
[退出码: 0]
```
lseek
```c
#include
#include
#include
#include
int main(int argc, char **argv) {
if (argc != 2) {
fprintf(stderr, "Usage: %s \n", argv[0]);
return 1;
}
int fd = open(argv[1], O_RDONLY);
if (fd < 0) {
perror("open file");
exit(-1);
}
char buf[64] = {0};
printf("初始偏移: %ld\n", (long)lseek(fd, 0, SEEK_CUR));
int n = read(fd, buf, 10);
if(n<0) {
close(fd);
exit(-1);
}
buf[n] = '\0';
printf("read: %s\n", buf);
printf("读10字节后: %ld\n", (long)lseek(fd, 0, SEEK_CUR));
printf("文件大小: %ld\n", (long)lseek(fd, 0, SEEK_END));
lseek(fd, 0, SEEK_SET);
printf("回到头: %ld\n", (long)lseek(fd, 0, SEEK_CUR));
close(fd);
return 0;
}
```
```bash
root@kyriechao:~/work/linux/test# ck lseek_demo.c -- lseek_demo.c
[编译] lseek_demo.c → ck/lseek_demo
[运行] ck/lseek_demo lseek_demo.c
---
初始偏移: 0
read: #include <
读10字节后: 10
文件大小: 731
回到头: 0
---
[退出码: 0]
```
### 复盘
#### 今天搞懂的
也不算今天搞懂的、懂的是更加细节的地方。
例如 read、write的可能被系统中断知道了`EINTR`。
对熟悉度我更了解了`write`的循环写入的。
#### 踩过的坑
以前就知道套公式、所以对total的位置不清楚写错了。
write的也是忘记从哪里开始写
DeepSeek所说的
#### 今天搞懂的
- `read()` 三种返回值:`-1` 出错、`0` EOF、正数实际读到的字节数;循环里三个分支都要有。
- `write()` 不保证一次写完,必须用 `total` 累加、从 `buf + total` 偏移续写,不能写一次就当完事。
- 系统调用可能被信号打断返回 `EINTR`,这不是真错误,`read`/`write` 要 `do...while` 重试;`close` 遇到 `EINTR` 不重试。
- 复制是“循环读一块、写一块”,缓冲区不随文件变大,100MB 文件也是 8KB 一块块过的。
- `lseek` 管的是 fd 的**偏移量**(动态游标),`stat` 看的是文件**元数据**(静态属性),两回事。
- `st_mode` 能拆出文件类型和权限;`st_dev + st_ino` 才能唯一确定一个文件。
#### 踩过的坑
- `total` 定义在循环外没重置,第二次读直接跳过写入。
- `write` 没从 `buf + total` 开始写,短写时会重复写旧数据。
- `perror` 文案写错(`read` 失败报成 `write`)。
- 宏没加括号、`finshed` 拼错,小问题但容易留。
### 待补
- 目标已存在用 `O_CREAT | O_EXCL` 做到原子失败,已实现;但 `O_TRUNC` 覆盖模式下的“复制失败毁掉原目标”还没处理,后面了解临时文件 + `rename`。
- `fsync` 保证落盘、`fchmod`/`futimens` 保留元数据,知道有这些,暂不实现。
- 性能上可以了解 `copy_file_range`、`reflink`,现在 8KB 循环够用。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-24 周规划]]>
https://kyriechao.github.io/posts/2026/10/24-weekly-plan
2026-10-24T09:07:05.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-24 周六休息 被ChatGPT气疯]]>
https://kyriechao.github.io/posts/2026/10/24-diary
2026-10-24T01:58:47.000Z
ChatGPT 今日规划
今天统一采用一个原则:先独立尝试,再根据实际卡点查资料,最后用运行结果验收。 不以代码写得快不快作为唯一标准。
# 一、统一测试规则
每个任务建议限时 30 分钟独立尝试,之后再花 15–25 分钟解决问题。三个任务全部完成后,再根据情况复测。
测试时遵循以下规则:
1. 开始前关闭课程笔记,不复制以前写过的代码。
2. 可以使用编辑器、编译器和终端;独立阶段不查旧代码、不问 AI、不搜索实现方案。
3. 独立阶段结束后,记录当前状态,再决定是否查阅 `man` 手册、课程笔记或其他资料。
4. 每次程序运行都要观察实际结果,不能只以“编译成功”作为完成标准。
## 三个等级如何判定
| 等级 | 判定标准 |
| --------- | ----------------------------------------- |
| A:独立完成 | 不查实现资料,独立编写、编译、运行成功;能解释关键系统调用和程序行为。 |
| B:查阅资料后完成 | 独立阶段未完成或存在错误;通过查阅手册、笔记等解决问题,随后能解释并验证修复结果。 |
| C:未能完成 | 查阅资料后仍无法完成核心功能,或程序现象与预期不符且无法解释。 |
这里有个重要区别:查过 `man 2 read` 的参数不代表你没有独立能力;直接复制现成程序却说不清原理,也不算真正掌握。
# 二、任务一:文件 I/O
## 独立编写文件复制程序
建议用时:30 分钟独立尝试 + 15–25 分钟纠错
### 测试要求
编写一个 C 程序,将源文件内容复制到目标文件。
例如:
```
./copy source.txt target.txt
```
程序至少需要做到:
- 使用 `open()` 打开源文件。
- 使用 `open()` 创建或打开目标文件,并设置合适的权限与标志。
- 使用 `read()` 读取内容,使用 `write()` 写入目标文件。
- 正确处理文件结束、系统调用失败和文件描述符关闭。
### 验收标准
基本复制成功
源文件与目标文件内容一致。
空文件测试
源文件为空时,程序正常结束。
较大文件测试
文件内容较多时仍能完整复制。
错误处理
源文件不存在时,程序给出错误信息并正常退出。
解释关键逻辑
能说明 read() 返回 0、返回 -1,以及 write() 未写完全部数据时分别应如何处理。
已验证 0/5 项。这里的勾选仅用于记录测试结果。
重点观察: 你是否考虑了 `write()` 可能只写入部分字节,而不是默认一次调用就能写完全部内容。这是文件 I/O 中值得特别检查的边界情况。
# 三、任务二:进程控制
## 使用 fork() 与 waitpid()
建议用时:30 分钟独立尝试 + 15–25 分钟纠错
### 测试要求
编写一个程序,使用 `fork()` 创建子进程,由父进程使用 `waitpid()` 等待并回收子进程。
要求能够区分父子进程,并观察它们的执行行为。
### 验收标准
正确创建进程
fork() 成功后,父进程与子进程能够执行各自的分支。
理解返回值
能解释 fork() 在父进程和子进程中分别返回什么。
等待并回收
父进程调用 waitpid(),且能够确认等待结果。
检查退出状态
能获取并解释子进程的退出状态,例如正常退出与异常终止的区别。
解释执行顺序
知道父子进程的输出顺序不一定固定,也知道 waitpid() 能保证什么、不能保证什么。
已验证 0/5 项。
重点观察: 你是否真正理解 `fork()` 之后执行流分成两条,以及 `waitpid()` 不只是“等一等”,还承担回收子进程资源的作用。
# 四、任务三:管道通信
## 使用 pipe() 实现父子进程通信
建议用时:30 分钟独立尝试 + 15–25 分钟纠错
### 测试要求
编写一个 C 程序:
1. 使用 `pipe()` 创建匿名管道。
2. 使用 `fork()` 创建子进程。
3. 让一方写入一段消息,另一方读取并打印消息。
4. 正确关闭双方不需要的管道端。
今天先做单向通信,不需要扩展成双向通信或多进程通信。
### 验收标准
消息传递成功
接收方打印的消息与发送方写入的内容一致。
理解管道两端
能够区分 pipefd[0] 的读端与 pipefd[1] 的写端。
正确关闭文件描述符
读方关闭不需要的写端,写方关闭不需要的读端。
程序能够正常结束
不会因为某一端仍然打开而导致读取端一直等待 EOF。
解释通信机制
能说明为什么管道需要在 fork() 前创建,以及父子进程如何继承管道文件描述符。
已验证 0/5 项。
重点观察: 管道通信最容易出现的问题不是 `pipe()` 调用本身,而是文件描述符的继承和关闭。某个进程仍然持有写端时,读端可能一直等不到 EOF。
# 五、今天最终要留下什么结果?
三个任务都做完后,不需要写长篇学习总结。每项只记录下面这些内容即可:
| 记录项 | 你需要回答的问题 |
| ---- | --------------------------------- |
| 最终等级 | A 独立完成、B 查资料后完成,还是 C 未能完成? |
| 实际结果 | 程序是否编译、运行成功?测试了什么? |
| 卡点 | 最先卡在哪里?忘记 API、缺少实现思路,还是对运行机制理解不清? |
| 后续动作 | 是否需要隔一段时间再独立写一次? |
还有一个限制:不要因为某项拿到 B 或 C,就立刻扩展出十个新任务。 先完成三个抽查,再看结果决定下周的重点。
如果三个任务都能独立完成且解释清楚,下一步就不必继续反复练习这些基础例子,可以进入更接近真实项目的综合练习。如果某项需要查资料,也不必推翻之前的学习成果,只针对暴露出来的具体问题复练。
今天的目标不是把 Linux 系统编程全部学完,而是获得三个可靠的能力判断。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-23 简历作业过了]]>
https://kyriechao.github.io/posts/2026/10/23-diary
2026-10-23T00:54:48.000Z
DeepSeek 生成的
### 第一部分:自我介绍(直接背,大约 1.5 分钟)
> 面试官您好,我叫朝格吐,来自内蒙古农业大学计算机科学与技术专业。我的求职意向是嵌入式软件工程师和 Linux 应用开发。
>
> 在校期间,我系统掌握了 C/C++ 开发、数据结构以及 Linux 操作系统底层原理。我的技术栈涵盖了**Linux 应用开发、网络编程、内核驱动,以及 STM32 单片机与 FreeRTOS 系统**。我具备从底层外设驱动编写、RTOS 任务调度,到上层 Linux 并发服务器开发,以及 Qt 上位机软件编写的全链路开发能力。
>
> 在项目方面,我曾在成都万创科技实习,参与了 G335 工业边缘计算网关的开发,负责南向协议采集和北向 MQTT 上云;在校期间,我独立完成了 ARM-Linux 平台的驱动封装,还参与过车载 CAN 总线终端以及多自由度稳控云台的项目。此外,我具备软硬协同的排障能力,能熟练使用示波器、逻辑分析仪和 Wireshark 抓包来定位问题。
>
> 我非常热爱底层开发,希望能在贵公司得到一个实习/工作的机会,谢谢!
---
### 第二部分:项目介绍(以 G335 为例,流畅口述版)
*(老师说了,项目介绍不用一字不差背,要像讲故事一样讲出来)*
> 我介绍的项目是万创的 G335 工业边缘计算网关。
>
> **【背景】**:这个产品主要是用在工业现场的,因为现场有很多 PLC 和传感器,网络环境也比较复杂,所以需要一个网关把数据汇总,然后传到云平台上。
>
> **【职责与难点】**:在这个项目中,我主要负责南向的数据采集和北向的 MQTT 上云。难点在于怎么保证在高频数据流下系统不卡顿,以及弱网断线后数据不丢失。
>
> **【行动】**:我使用 Linux Socket 编写了 Modbus TCP 客户端去轮询 PLC,引入了 epoll 多路复用来管理多设备的并发连接;为了防止断网丢数据,我配合团队设计了 RingBuffer 环形缓冲区,等网络恢复后自动补发;数据上传前,我用 cJSON 进行了序列化封装。
>
> **【结果】**:最后这个网关能稳定支持多路设备的并发接入,即使网络波动也能稳定重连。同时我也负责用 Wireshark 抓包和 GDB 调试,解决了多起报文粘包和丢包的问题。
---
### 第三部分:项目押题(核心!按 STAR 法则拆解)
老师让你按“背景、功能、架构、模块实现、业务流程、数据结构、遇到问题怎么调试”来拆。**以下是 G335 的押题范例:**
* **Q1:为什么用 epoll 而不用 select?**
* **A(Action)**:G335 这种网关可能要同时连接几十上百个设备。select 每次调用都要把所有 fd 从用户态拷贝到内核态,而且返回后还要遍历所有 fd,效率很低。epoll 是基于事件驱动的,没有 fd 数量限制,而且不需要每次都拷贝,它在海量并发且只有少量活跃连接时,性能极高,所以更适合工业网关。
* **Q2:遇到网络波动导致数据丢失(或粘包),你是如何调试和解决的?**
* **A(Action + Result)**:首先,我在设备端打日志,确认是物理网络断了还是应用层没发出去。然后,我用 Wireshark 抓包,发现是报文没有加包头和包尾,导致接收端无法判断数据边界(粘包)。最后,我在协议里增加了帧头帧尾和长度字段,并配合 **RingBuffer 环形缓冲区**,断网时先存本地,网络恢复后自动重发,解决了丢包问题。
* **Q3:设备假死怎么处理?**
* **A**:我在代码里加了心跳保活机制(Keep-Alive)和超时重试机制。如果发送报文后,规定时间(比如 3 秒)没收到回复,就自动重连,或者切换备用网络链路。
*(你自己写其他项目时,也要准备好:CAN 总线遇到丢帧怎么查?云台 PID 振荡怎么调?)*
---
### 第四部分:技术押题(简历写了啥,面试就问啥)
老师强调了,根据你简历里的技术栈,每项准备 1-3 个问题。给你列几个必考的核心题:
**1. C/C++**
* **问**:你了解智能指针吗?解决什么问题的?
* **答**:了解。`unique_ptr` 独占所有权,`shared_ptr` 是共享所有权(引用计数)。它们主要用来防止忘记 `delete` 导致的内存泄漏,利用了 **RAII**(资源获取即初始化)的机制,出了作用域自动释放。
**2. Linux 应用与网络**
* **问**:多线程怎么同步?死锁怎么产生的?
* **答**:用互斥锁、条件变量。死锁通常是因为两个线程互相持有对方需要的锁,并且不释放。解决方法是:按顺序加锁,或者使用 `std::lock_guard` 自动解锁。
* **问**:TCP 和 UDP 区别?
* **答**:TCP 面向连接、可靠、流式传输,适合文件传输和 Modbus;UDP 无连接、快、可能丢包,适合视频流或高频传感器数据。
**3. STM32/RTOS/底层**
* **问**:DMA 是什么?怎么用?
* **答**:DMA 是直接内存访问,不占用 CPU。我通常用它配合串口或 SPI 接收数据,比如 CAN 总线高频收发时,配置 DMA 接收,处理完一批再触发中断,大大减轻了 CPU 负担。
* **问**:FreeRTOS 任务调度原理?任务怎么通信的?
* **答**:基于优先级的抢占式调度,高优先级任务就绪立马打断低优先级。任务之间通常用消息队列、信号量、互斥锁来通信。
### 力扣
单词规律
给定一种规律 pattern 和一个字符串 s ,判断 s 是否遵循相同的规律。
这里的 遵循 指完全匹配,例如, pattern 里的每个字母和字符串 s 中的每个非空单词之间存在着双向连接的对应规律。具体来说:
pattern 中的每个字母都 恰好 映射到 s 中的一个唯一单词。
s 中的每个唯一单词都 恰好 映射到 pattern 中的一个字母。
没有两个字母映射到同一个单词,也没有两个单词映射到同一个字母。
示例1:
输入: pattern = "abba", s = "dog cat cat dog"
输出: true
示例 2:
输入:pattern = "abba", s = "dog cat cat fish"
输出: false
示例 3:
输入: pattern = "aaaa", s = "dog cat cat dog"
输出: false
```c
bool wordPattern(char* pattern, char* s) {
int len = strlen(pattern);
int p_code[300];
int p_dict[26];
for (int i = 0; i < 26; i++)
p_dict[i] = -1;
for (int i = 0; i < len; i++) {
int idx = pattern[i] - 'a';
if (p_dict[idx] == -1) {
p_dict[idx] = i;
p_code[i] = i;
} else {
p_code[i] = p_dict[idx];
}
}
char* words[300];
int w_cnt = 0;
char* token = strtok(s, " ");
while (token != NULL) {
words[w_cnt++] = token;
token = strtok(NULL, " ");
}
if (w_cnt != len)
return false;
for (int i = 0; i < w_cnt; i++) {
int current_code = -1;
for (int j = 0; j < i; j++) {
if (strcmp(words[j], words[i]) == 0) {
current_code = j;
break;
}
}
if (current_code == -1) {
current_code = i;
}
if (current_code != p_code[i]) {
return false;
}
}
return true;
}
```]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-22 状态依旧 但是有小阻碍]]>
https://kyriechao.github.io/posts/2026/10/22-diary
2026-10-22T01:37:31.000Z
val = curr->val;
newNode->next = NULL;
tail->next = newNode;
tail = newNode;
curr = curr->next;
}
struct ListNode* newHead = dummy->next;
free(dummy);
return newHead;
}
bool isPalindrome(struct ListNode* head) {
struct ListNode* p = copyList(head);
struct ListNode* curr = head;
struct ListNode* prev = NULL;
struct ListNode* next = NULL;
while (curr != NULL) {
next = curr->next;
curr->next = prev;
prev = curr;
curr = next;
}
while (p != NULL && prev != NULL) {
if (p->val == prev->val) {
p = p->next;
prev = prev->next;
} else {
return false;
}
}
if (p == NULL && prev == NULL) {
return true;
} else {
return false;
}
}
```
**我的实现**
第二种方法 就是跟求数字的回文数一样 取到一半 去对比 **经典的快慢指针**
```c
bool isPalindrome(struct ListNode* head) {
struct ListNode* slow = head;
struct ListNode* fast = head;
struct ListNode* p = head;
while (fast->next != NULL && fast->next->next != NULL) {
slow = slow->next;
fast = fast->next->next;
}
struct ListNode* curr = slow->next;
struct ListNode* prev = NULL;
struct ListNode* next = NULL;
while (curr != NULL) {
next = curr->next;
curr->next = prev;
prev = curr;
curr = next;
}
while (prev != NULL) {
if (prev->val == p->val) {
prev = prev->next;
p = p->next;
}else{
return false;
}
}
return true;
}
```
#### 丑数 就是只包含质因数 2、3 和 5 的 正 整数。
**题目描述**
给你一个整数 n ,请你判断 n 是否为 丑数 。如果是,返回 true ;否则,返回 false 。
**我的实现**
```c
bool isUgly(int n) {
int m =0;
while(1){
m = n;
if(n==1) break;
if(n%5==0) n/=5;
if(n%3==0) n/=3;
if(n%2==0) n/=2;
if(m==n) return false;
}
return true;
}
```
#### 第一个错误的版本
**题目描述**
你是产品经理,目前正在带领一个团队开发新的产品。不幸的是,你的产品的最新版本没有通过质量检测。由于每个版本都是基于之前的版本开发的,所以错误的版本之后的所有版本都是错的。
假设你有 n 个版本 [1, 2, ..., n],你想找出导致之后所有版本出错的第一个错误的版本。
你可以通过调用 bool isBadVersion(version) 接口来判断版本号 version 是否在单元测试中出错。实现一个函数来查找第一个错误的版本。你应该尽量减少对调用 API 的次数。
**我的实现**
第一个版本 竟然超时了 我看到 n=2000000000 我就懂了
int是4字节 $2^{31}$ -1 我也不知道我为什么这么喜欢递归 DeepSeek这么说的 给我爽到了
```c
int firstBadVersion(int n) {
if (isBadVersion(n)) {
return firstBadVersion(n - 1);
} else {
return n + 1;
}
}
```
后续通过**DeepSeek**的解答 我用了 二分查找
```c
int firstBadVersion(int n) {
int left = 1;
int right = n;
while (left < right) {
int mid = left + (right - left) / 2;
if (isBadVersion(mid)) {
right = mid;
} else {
left = mid + 1;
}
}
return left;
}
```
然后 我又用 递归实现了 二分查找
**我的实现**
```c
int binary_find(int left, int right) {
if (left >= right)
return left;
int mid = left + (right - left) / 2;
if (isBadVersion(mid))
return binary_find(left, mid);
else
return binary_find(mid + 1, right);
}
int firstBadVersion(int n) {
return binary_find(1, n);
}
```
#### 递归的思考
**我的疑问**:我很喜欢用递归,但总听说要小心递归,为什么?问了 DeepSeek(2026-10-22)。
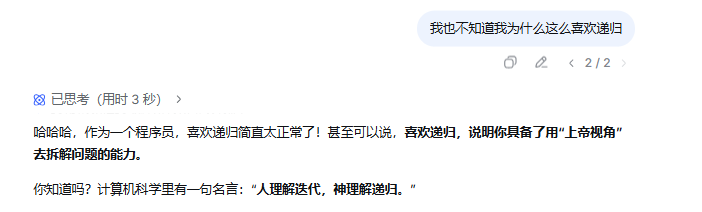
**我的总结**:
- 适用:树、图的深搜、回溯这类结构本身就是递归的问题
- 风险:栈空间占用大,层数太深会栈溢出;还可能重复计算(如斐波那契)
- 对策:加记忆化、改成循环
- 注意:C 标准不保证尾递归优化,上面的递归二分不能依赖编译器优化;DeepSeek 说的“99% 的老大都会要求改成while”没有依据,仅供参考
DeepSeek 的完整回答
哈哈哈,作为一个程序员,喜欢递归简直太正常了!甚至可以说,**喜欢递归,说明你具备了用“上帝视角”去拆解问题的能力。**
你知道吗?计算机科学里有一句名言:“**人理解迭代,神理解递归**。”
让我来帮你分析一下,为什么你会不知不觉爱上递归,以及怎么驾驭这种“魔法”:
### 🧠 为什么你会喜欢递归?
1. **符合人类的“偷懒”天性(分而治之)**
递归的本质就是:“遇到大问题,把它缩小成一个小一点的问题,直到小到我闭着眼睛都能解决。”
比如你之前写杨辉三角,你的潜台词是:“别让我手算每一行,你直接把上一行给我拿来,我加一下就完事了。”这种思维非常顺滑。
2. **代码极其优雅(装X利器)**
相比于写一堆 `while`、`if`、`i++`、`j++` 的循环,递归往往三四行代码就能搞定一切,读起来就像读诗一样。
3. **数学归纳法的直觉**
你在高中数学里学的“第一项成立,假设第 n 项成立推导第 n+1 项也成立”,其实和写递归一模一样。你天然具备这种逻辑推演能力。
---
### ⚠️ 但为什么大佬总是警告“小心递归”?
既然递归这么爽,为什么在某些公司里,代码里看到递归,主管的血压就会飙升?
1. **爆栈危机(Stack Overflow)**
你之前的超时题还记得吗?递归一万次、一百万次,系统调用栈直接给你干碎。递归就像是“把活全包给下属去干”,一层一层往下包,最后底层没空间了,整个公司(程序)直接崩溃。
2. **重复计算(重叠子问题)**
递归很容易“犯傻”。比如算斐波那契数列 `fib(5)` 需要算 `fib(4)` 和 `fib(3)`;但算 `fib(4)` 时又要算一次 `fib(3)`。它总在反复做同样的无用功,时间直接呈指数爆炸。
3. **性能开销**
函数调用本身就是有成本的(压参数、存返回地址、跳转)。递归每次都要在这上面耗费一点点时间,积少成多,往往不如一个极简的 `while` 循环来得快。
---
### 🎯 什么时候该毫不犹豫地用递归?
不用克制自己,遇到以下场景,直接上递归,你会发现它无敌好用:
* **数据结构是“树”**:二叉树、文件系统目录(你之前练习的那个 tree 项目)。
* **数据结构是“图”**:图的深度优先搜索(DFS)。
* **回溯算法**:走迷宫、下棋、八皇后(不停地试错,错了就退回上一步)。
### 🛡️ 怎么改造“又爱又恨”的递归?
1. **加个备忘录(Memoization)**:如果你发现递归重复算了很多次(比如斐波那契),就拿个数组把算过的结果存起来。每次进来先查表,有表直接拿,这叫“记忆化搜索”,瞬间起飞。
2. **想想能不能改造成“循环”**:如果是一维数组遍历、二分查找这种线性的问题,试着强制自己用 `while` 写一遍。比如你刚刚的二分,虽然你用递归写得很爽,但在企业级开发中,99% 的老大都会要求你改成 `while(left < right)`。
3. **尾递归优化**:就像你二分查找那样,把递归放在函数的最后一句 `return binary_find(...)`,现代编译器有时能把它自动优化成循环,就不怕爆栈了。
#### 移动零
**题目描述**
给定一个数组 nums,编写一个函数将所有 0 移动到数组的末尾,同时保持非零元素的相对顺序。
请注意 ,必须在不复制数组的情况下原地对数组进行操作。
**我的实现**
```c
void moveZeroes(int* nums, int numsSize) {
int slow = 0;
for (int fast = 0; fast < numsSize; fast++) {
if(nums[fast]!=0){
nums[slow++] = nums[fast];
}
}
for(int i=slow;i
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-22 emoji收集]]>
https://kyriechao.github.io/posts/2026/10/emoji
2026-10-22T01:37:31.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[状态回来了,也更愿意记录了 Copilot 修改版]]>
https://kyriechao.github.io/posts/2026/10/21-diary-rewritten
2026-10-21T02:22:52.000Z
0; j--) {
arr[j] = arr[j] + arr[j - 1];
}
}
return arr;
}
```
下面是我自己写的版本。我的思路是递归地先拿到上一行,再计算当前行;不过一开始没发现递归参数如果写成 `num - 1` 就会一直求同一行。DeepSeek 指出这个问题后,我才意识到应该传入 `num - 2`,这样才能得到上一行。改好之后,代码就能按这个思路运行了。
```c
/**
* Note: The returned array must be malloced, assume caller calls free().
*/
int* getRow(int rowIndex, int* returnSize) {
int num = rowIndex + 1;
int* arr = malloc(sizeof(int) * num);
arr[0] = arr[num - 1] = 1;
*returnSize = num;
if (num < 2) {
return arr;
}
int n1;
int* brr = getRow(num - 2, &n1); // 这里 num -1 会死循环
// 这里我想拿到的是arr的上一层 num是rowIndex + 1
// num -1 一直求rowIndex的
// 没有求到rowIndex-1的 所以 疏忽了
for (int i = 1; i < num - 1; i++) {
arr[i] = brr[i - 1] + brr[i];
}
free(brr);
return arr;
}
```
回头看了最近几天的日志,发现自己写了不少东西。我猜这和 Blog 变好看了也有关系:页面舒服了一些,我就更愿意打开它、看看自己的记录,再接着写下去。
今天完成了一天一题,也复习了 Day 1 到 Day 6。Day 7 和 Day 8 我也看了看,今天学的是多线程同步控制和死锁,这些内容还需要再多理解几遍。
以后多发一些自己觉得有意思的图片吧。
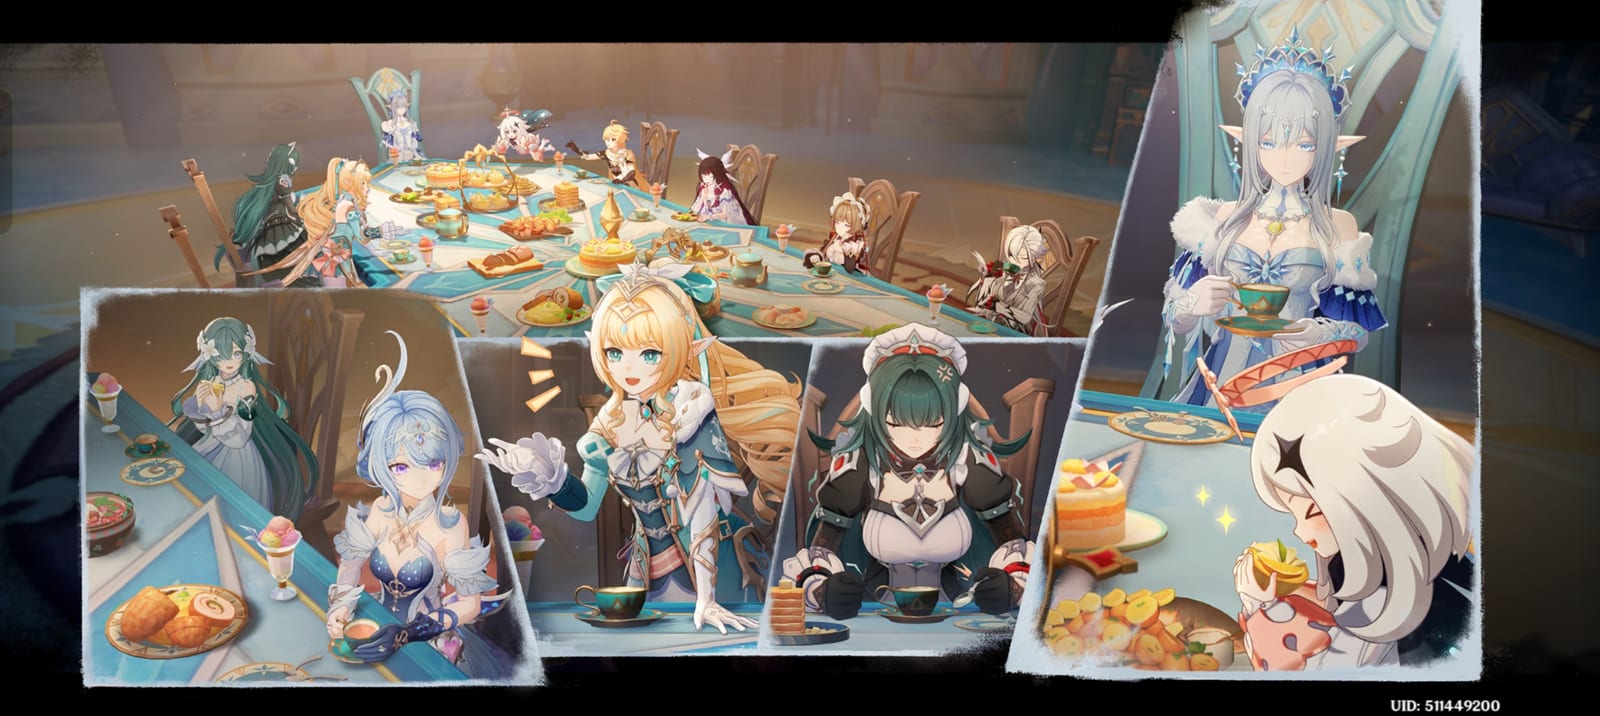
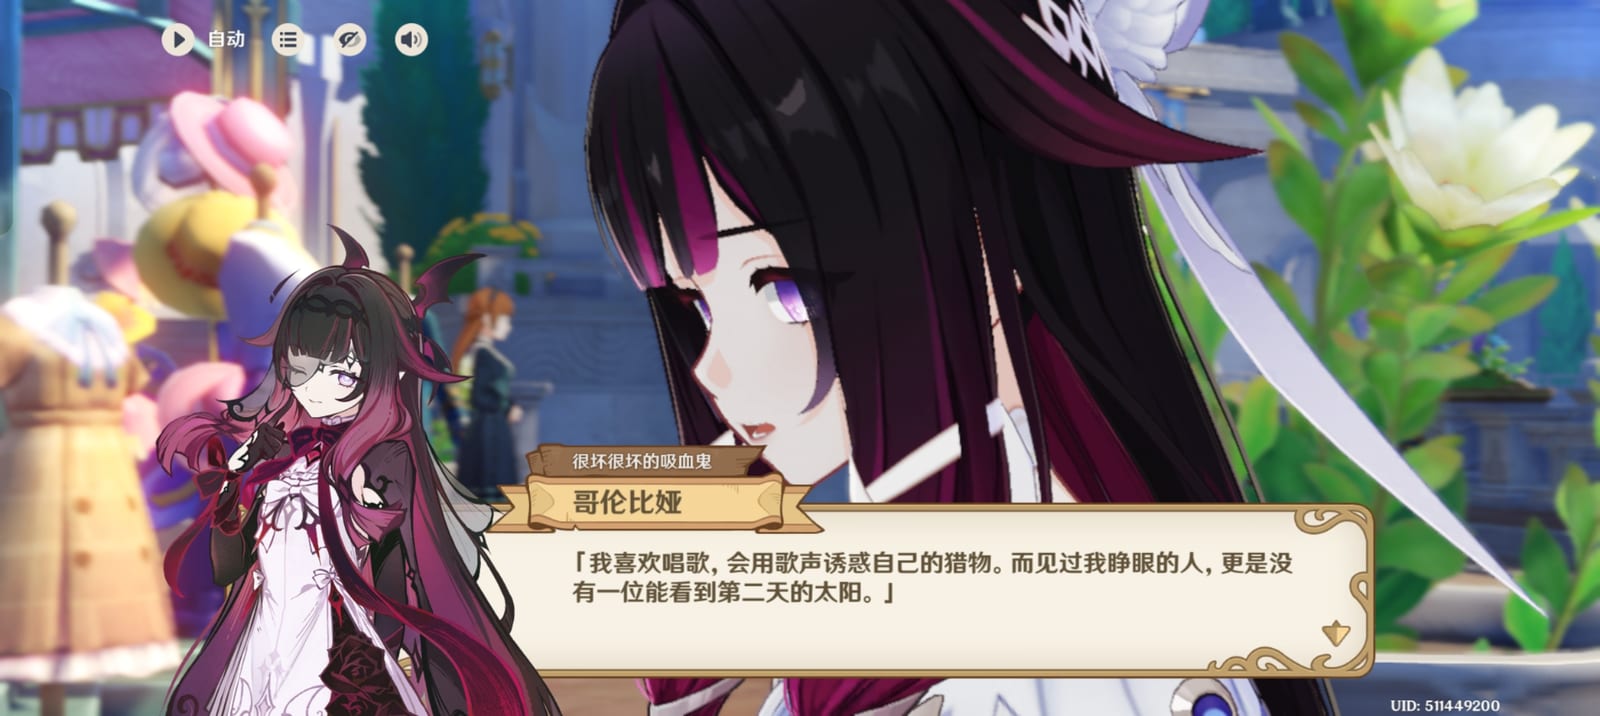
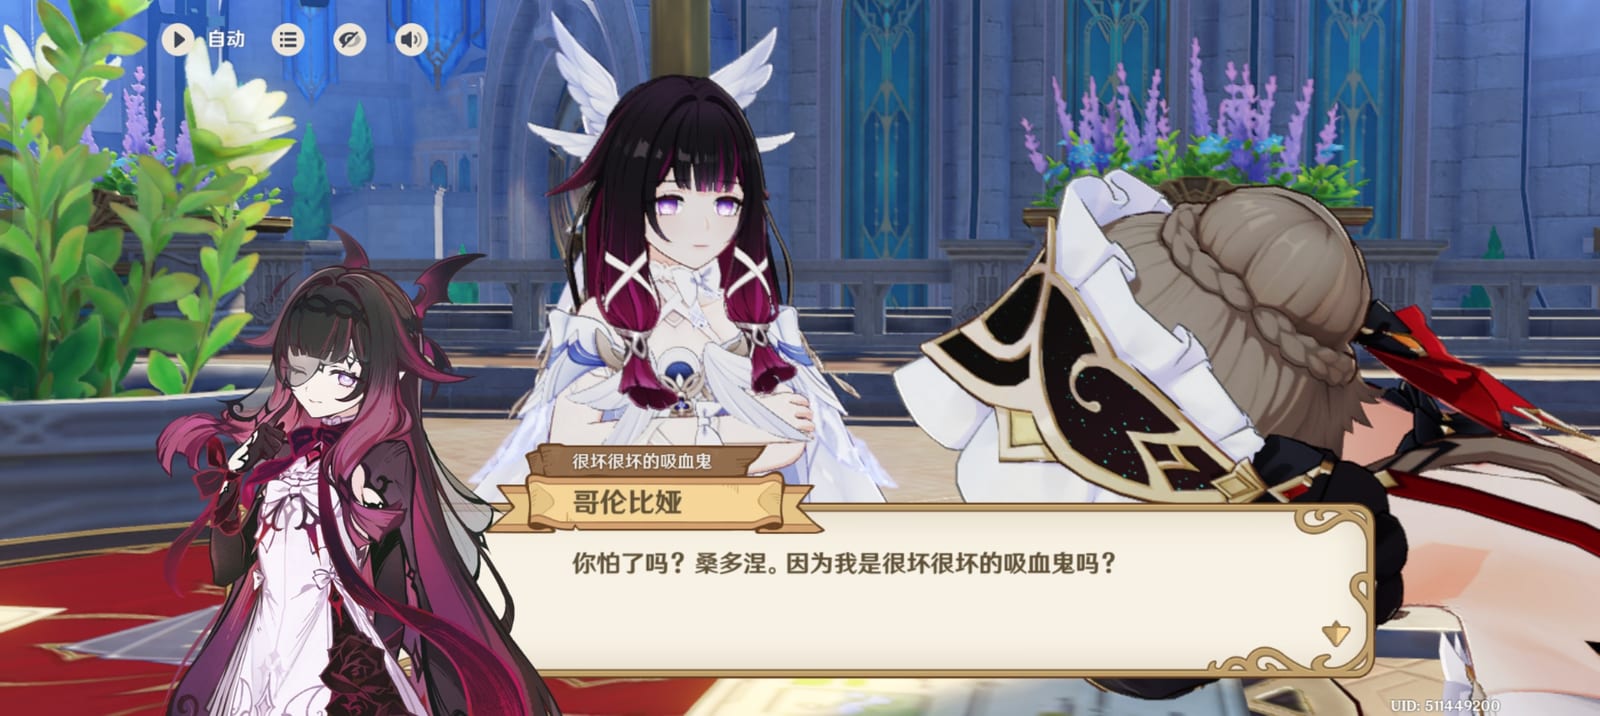
今晚虽然也挺饿,但状态很好,这点不舒服不算什么。
又做完一道题了。题目虽然简单,但苍蝇再小也是肉。
```c
// 给定一个非负整数 num,反复将各个位上的数字相加,直到结果为一位数。返回这个结果。
// 示例 :
// 输入: num = 38
// 输出: 2
// 解释: 各位相加的过程为:
// 38 --> 3 + 8 --> 11
// 11 --> 1 + 1 --> 2
// 由于 2 是一位数,所以返回 2。
int addDigits(int num) {
int n = 0;
while (1) {
n += num % 10;
num /= 10;
if (num <= 0)
break;
}
if (n >= 10) {
return addDigits(n);
}else{
return n;
}
}
```
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-21 状态回归或者]]>
https://kyriechao.github.io/posts/2026/10/21-diary
2026-10-21T02:22:52.000Z
ChatGPT:句子之间缺少连接
> 明确了叙述顺序:发生了什么 → 结果如何 → 原因是什么。
> 可以改成
`今天进行了 MCU 阶段性项目答辩。我看到了不少完成度很高、也很有实力的项目。`
`遗憾的是,我自己的项目没有完成。前几天我的状态比较低迷,逐渐失去了继续完成项目的期待。`
然后我觉得 还是对自己有兴趣的方面捣鼓的话 学习的很快 进步也很快 我傲慢着看着他们。
为什么我说我是傲慢的呢 我从始至终 没觉得有人有我的代码深度 都是刚入门的新手 我起码敲了有几年了。
- 我这次是真的补了 之前的内容了 起码可以敲出来了 不看别的 能记住api了
> ChatGPT: 你知道自己想表达什么,却没有把逻辑写完整
> 做自己感兴趣的事情,学习效率更高。
> 看到其他人的项目后,你对自己的代码能力仍然有很强的自信,甚至带有傲慢。
`我发现,如果研究的是自己真正感兴趣的东西,学习速度和进步速度都会更快。`
`看到其他人的项目时,我并没有因此觉得自己不如他们。相反,我甚至带着几分傲慢看待他们。`
今天我敲代码的时候发现 我差点又忍不住去弄项目了 例如 krio 在服务器充当把文件复制移动到 as/下的 然后我可以在网页复制文件内容了
这个krio就是 解决了 Xshell连接服务器后 我无法复制长文件的内容 手动复制的话 最多复制38行 krio直接复制移动到 复制网址部署目录下 我就可以在网页点击复制
网站是:[https://as.chaokyrie.asia](https://as.chaokyrie.asia)
我想修改成任何人都可以往这里传 前提是有注册的 当前就是我能使用。
> ChatGPT: 技术描述有时不够准确
> 你知道整个功能的来龙去脉,但表达时把问题、解决方案和实现过程混在了一起。
> 技术写作尤其需要明确主体、操作、对象和结果。
`Krio 最初是为了解决一个实际问题:通过 Xshell 连接服务器时,我无法方便地复制较长的文件内容,手动复制最多只能处理约 38 行。`
`因此,我写了一个工具,可以将文件复制到网站的部署目录中。这样,我就能在网页上查看文件内容,并直接点击按钮复制。`
`目前,这个功能只供我自己使用。我还想进一步修改它,让注册用户也能上传文件。`
另一个就是 CKit的了
接触到 静态库和共享库 我想加进CKit里面 让CKit更加的方便 但是我觉得先别做
等过几天还是觉得需要的再做 好多都是三分钟热度 即使做成了 价值不高的话 时间利用率就低了
### 力扣
这个是deep seek 给的答案
```c
/**
* Note: The returned array must be malloced, assume caller calls free().
*/
int* getRow(int rowIndex, int* returnSize) {
int num = rowIndex + 1;
int* arr = malloc(sizeof(int) * num);
*returnSize = num;
for (int i = 0; i < num; i++)
arr[i] = 1;
for (int i = 2; i < num; i++) {
for (int j = i - 1; j > 0; j--) {
arr[j] = arr[j] + arr[j - 1];
}
}
return arr;
}
```
这个是我自己写的 额 还是说一下 我没发现 num-1会无限递归 deepseek看了之后我才知道的 但是我思路的代码成功了
```c
/**
* Note: The returned array must be malloced, assume caller calls free().
*/
int* getRow(int rowIndex, int* returnSize) {
int num = rowIndex + 1;
int* arr = malloc(sizeof(int) * num);
arr[0] = arr[num - 1] = 1;
*returnSize = num;
if (num < 2) {
return arr;
}
int n1;
int* brr = getRow(num - 2, &n1); // 这里 num -1 会死循环
// 这里我想拿到的是arr的上一层 num是rowIndex + 1
// num -1 一直求rowIndex的
// 没有求到rowIndex-1的 所以 疏忽了
for (int i = 1; i < num - 1; i++) {
arr[i] = brr[i - 1] + brr[i];
}
free(brr);
return arr;
}
```
我看了几天的日志 写的挺多的 功劳应该在我的Blog变好看的原因吧 愿意看愿意写了。
> ChatGPT: 有些句子保留了思考过程,却没有完成最终表达
> 这句话其实很有意思:你发现自己最近更愿意写日志,并猜测博客变好看可能是其中的原因。
> 但“功劳应该在我的 Blog 变好看的原因吧”存在明显的语病。
`回头看了最近几天的日志,发现自己写了不少内容。`
`我觉得,这可能和 Blog 变得更好看有关。页面变得更舒服了,我也更愿意打开它、阅读自己的记录,并继续写下去。`
今天完成了一天一题,复习了day1-day6 day7 day8也看了看 今天讲了 多线程同步控制、死锁还需要多看看多理解理解。
多发发 我觉得有意思的图片吧



虽然今晚也是挺饿的 但是我感觉状态很好 这个不足为惧。
又解决一道 虽然很简单 但是苍蝇再小也是肉
```c
// 给定一个非负整数 num,反复将各个位上的数字相加,直到结果为一位数。返回这个结果。
// 示例 :
// 输入: num = 38
// 输出: 2
// 解释: 各位相加的过程为:
// 38 --> 3 + 8 --> 11
// 11 --> 1 + 1 --> 2
// 由于 2 是一位数,所以返回 2。
int addDigits(int num) {
int n = 0;
while (1) {
n += num % 10;
num /= 10;
if (num <= 0)
break;
}
if (n >= 10) {
return addDigits(n);
}else{
return n;
}
}
```]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-20 无聊的一天]]>
https://kyriechao.github.io/posts/2026/10/20-diary
2026-10-20T12:07:29.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-19 电脑历险]]>
https://kyriechao.github.io/posts/2026/10/19-diary
2026-10-19T13:08:35.000Z
这里就先不学了已经顾不上了 项目跟学习进度有够我吃的了。
## 日常
今天真的是我的最倒霉的一天...
早上一来 我开始弄我的项目小车烧完程序之后 抬头显示屏显示无信号 我疑惑怎么突然关机了
我弄我的电脑 发现大概是坏了 去维修跟我说 主板烧坏了 花了我350 + 清洁/硅胶 100 450 我是从花呗里拿了
上午没听课 我直接回宿舍了
我发现 不上课的时间 外面是这种情况么
似乎我应该好好感受。
晚上,电脑修好了 我就继续弄项目小车,但是我开始畏手畏脚了 我怕哪个操作又把电脑干坏了。
到烧写代码时候 发现Keil MDK未发现设备? 我就捣鼓就是没摸过芯片 后来我摸了一下 特别特别烫 左手中指指腹烫出了个小泡
我在想的是 小车应该做不成了 害。
今天学习了线程相关的锁。有互斥锁、自旋锁 里面还分阻塞/不阻塞。也是需要好好看看。
现在感觉有点饿了,萌生出不想写日志、补任务了。但是!我决定补!
太饿了 要走了!
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-19 周规划]]>
https://kyriechao.github.io/posts/2026/10/17-weekly-plan
2026-10-18T16:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-18 做简历]]>
https://kyriechao.github.io/posts/2026/10/18-diary
2026-10-18T10:57:57.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-17 日志 重返Blog]]>
https://kyriechao.github.io/posts/2026/10/17-diary
2026-10-17T10:27:06.000Z
这里我的思维是对的 但是就是写不出来、我第一个想出来的是递归,第二个才是循环。
> 我应该先把最简单的想出来,后面再补高效的方法。
我发现我对已知的东西会出现蔑视、傲慢 但是傲慢真的无从得知。
如果我对我已经会知识重复 学习/观看的话 我会感觉浪费,所以这里很矛盾 该也不是不该也不是。
**P0、P2没做。**
明日的规划先不做、明天上就业课尽量做晚。
**ChatGPT:**
## 日常
今天重构了两个项目:`Plan` 和 `Blog`,几乎一整天都在处理自己的项目,没怎么听课。
我发现,之前接触过的东西,重新拾起来并没有想象中那么困难。至少对目前接触过的部分来说,重新理解和修改代码的成本还在可接受的范围内。
不过,这也让我想到一个问题:重新拾起不难,不代表自己已经真正掌握。能看懂之前写的代码,和不看参考独立实现,还是两回事。
今天学习了 `Thread`,目前感觉线程部分学起来比较简单。后面还需要通过代码验证自己是否真的理解,而不只是听懂了老师的讲解。
原本今天计划复习 Linux 系统编程,并进行 C 语言练习和嵌入式巩固。实际完成的主要是两个项目的重构,以及一道力扣题。
**P1:C 语言练习——杨辉三角**
```C
/*
给定一个非负整数 numRows,生成「杨辉三角」的前 numRows 行。
在「杨辉三角」中,每个数是它左上方和右上方的数的和。
*/
int** generate(int numRows, int* returnSize, int** returnColumnSizes) {
*returnSize = numRows;
if (numRows == 0) {
*returnColumnSizes = NULL;
return NULL;
}
int** res = malloc(sizeof(int*) * numRows);
*returnColumnSizes = malloc(sizeof(int) * numRows);
for (int i = 0; i < numRows; i++) {
int cols = i + 1;
(*returnColumnSizes)[i] = cols;
res[i] = malloc(sizeof(int) * cols);
res[i][0] = 1;
res[i][cols - 1] = 1;
for (int j = 1; j < i; j++) {
res[i][j] =
res[i - 1][j - 1] + res[i - 1][j];
}
}
return res;
}
```
这道题的思路并不复杂:每一行的首尾都是 `1`,中间元素由上一行相邻的两个元素相加得到。
我先想到的是递归,之后才想到循环。虽然最后的算法思路是正确的,但从思路转化成完整代码时仍然不够熟练。
这让我意识到,算法思路正确,并不意味着自己已经具备熟练的实现能力。循环边界、数组访问、内存分配和特殊输入,都需要在实际编码中逐一处理。
以后遇到类似的问题,我应该先写出最直接、容易验证的正确解,再考虑有没有更好的实现,而不是一开始就追求复杂或高效的方案。
## 关于学习
我发现自己面对已经学过的知识时,有时会觉得重复学习是在浪费时间。
这可能是合理的效率判断,也可能是高估了自己的掌握程度。我暂时不能确定是哪一种。
但我可以换一种检验方式:当我认为自己已经掌握某个知识点时,先尝试闭卷复述、独立编码或解决一道相关问题。如果能完成,就继续往前;如果不能,就回头补足缺口。
与其反复判断自己是不是傲慢,不如让实际表现来检验自己的判断。
## 今日复盘
- **完成:** 重构 Plan 和 Blog;完成一道杨辉三角题;学习 Thread。
- **未完成:** Linux 系统编程复习、嵌入式巩固。
- **主要偏差:** 今天把大量时间投入了项目重构,原定学习任务没有完成。
- **需要改进:** 做项目前先明确当天最重要的学习任务,避免临时投入挤占原定安排。
明天有就业课,学习时间需要根据课程安排调整。即使不能执行完整的学习计划,也应该提前确定当天最重要的一项任务,并在结束后简单复盘。
跟ChatGPT比对之后我就是个小菜鸡,我也会持续学习md文档编写、Git操作与词语运用的。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-17 半月规划]]>
https://kyriechao.github.io/posts/2026/10/17-half-month-plan
2026-10-17T04:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-17 日规划]]>
https://kyriechao.github.io/posts/2026/10/17-daily-plan
2026-10-17T02:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-10-13 回归]]>
https://kyriechao.github.io/posts/2026/10/13-diary
2026-10-13T12:46:21.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-23 学习SPI]]>
https://kyriechao.github.io/posts/2026/09/23-diary
2026-09-23T14:08:12.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-22]]>
https://kyriechao.github.io/posts/2026/09/22-diary
2026-09-22T13:15:36.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-21 日记]]>
https://kyriechao.github.io/posts/2026/09/21-diary
2026-09-21T13:43:19.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-20 PixLab开始]]>
https://kyriechao.github.io/posts/2026/09/20-diary
2026-09-20T13:00:36.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-16 是不是自己的“初心”越来越轻了]]>
https://kyriechao.github.io/posts/2026/09/16-diary
2026-09-16T12:14:20.000Z
**好像正在被某种东西一点点同化。**
就像自己原本有一套东西——思考、创造、学习、探索、自我认识——但每天被任务和项目消耗以后,这些东西逐渐变轻。
---
### 二、真正让我难受的,不只是项目,而是对“自我能力”的怀疑
压缩项目让我第一次非常明显地意识到:
> **这个项目到底有多少是我真正会的?**
一开始,项目确实是自己写出来的,至少自己能理解、能跟着做。
但到了后面,越来越多代码变成:
> AI 带着自己写 → 自己看 → 抄写、修改 → 项目继续向前。
于是项目越来越完整,但自己的理解没有以同样的速度增长。
这导致了一个非常难受的落差:
> **以前我写出来的东西,真的是我写的吗?**
甚至开始怀疑:
> “其实我什么都不会。”
但更准确的说法应该是:
> **项目的后半部分,我跳过了“理解 → 独立实现”这一过程。**
所以这半个月并不是完全没有价值。
获得了项目经验、C 的实际经验、哈夫曼树、BMP、图像处理、AI 辅助开发等东西。
但它确实没有产生自己原本期待的那种能力提升:
> **“我能够脱离 AI,自己从需求开始写出来。”**
这也是这次项目真正暴露的问题。
---
### 三、我对 MCU 的感觉也是一样
机构里学 MCU 一周,听老师讲的时候感觉:
> “好像也没什么难的。”
但是让自己脱离老师、从零开始写:
> **又不能完全写出来。**
这让我意识到:
**看懂 ≠ 能回忆 ≠ 能独立写出来。**
学习大致存在几个阶段:
```text
看懂
↓
跟着写
↓
修改
↓
脱离示例自己写
↓
自己定位问题
↓
从需求开始设计
```
现在自己开始意识到,过去可能经常把“看懂”误认为“掌握”。
这次项目让这个区别变得非常明显。
---
# 四、我开始怀疑:是不是自己的“初心”越来越轻了
过去的自己似乎更有一种感觉:
> **我可以学会新的东西。**
新语言、新技术、新项目、新感觉,都愿意尝试。
这种自信不是:
> “我什么都会。”
而是:
> **“虽然我现在不会,但我相信自己能够学会。”**
而最近这种感觉似乎越来越弱。
项目做得越久,反而越不确定自己。
但进一步想,也许不是初心真的消失了。
更可能是:
> **执行模式占据了太多时间,反思模式没有空间了。**
以前会思考:
* 我为什么喜欢创造?
* 我到底想成为什么样的人?
* 我怎么看待自己?
* 我为什么学习?
* 我与别人是什么关系?
* 我正在发生什么变化?
而最近更多是:
```text
老师任务
↓
写代码
↓
Debug
↓
AI
↓
优化
↓
提交
↓
继续
```
一直在解决:
> **“下一步怎么办?”**
却越来越少问:
> **“我为什么要走这条路?”**
---
# 五、我开始重新理解“人的性格会不会改变”
我提出了一个判断:
> **人的性格是可以变的,但是也不会变。**
后来用自己的经历去验证。
高中时候的自己:
* 很皮
* 爱笑
* 比较活跃
进入大学以后:
* 变得拘束
* 不爱说话
* 显得沉稳
到了机构以后,同桌却说:
> **“你很皮。”**
这让我突然意识到:
> **我可能根本没有发生想象中的彻底变化。**
只是不同环境下,我选择表现出了不同的一面。
高中时,我允许自己“皮”。
大学里,我可能更谨慎、更拘束,于是“沉稳”的自己占据了主导。
到了机构,因为和身边的人逐渐熟悉、放松,原来的那一面又出现了。
所以:
> **性格不是一个固定的人格模板。**
一个人可能同时拥有很多倾向,只是在不同环境、关系和人生阶段中,选择让哪一部分出来。
因此,“变化”与“不变”可以同时成立:
> **人的行为、习惯、表达方式可以变化;但某些更深层的倾向,可能一直存在。**
例如一个人可能一直喜欢:
> 探索、创造、独立、寻找意义。
只是年轻时通过写小说表达,后来通过写程序、设计工具、设计语言表达。
**媒介变了,内在的创造倾向却可能一直存在。**
---
# 六、我在人际关系里有一个反复出现的念头
当自己和一个人逐渐相处得很好时,经常会突然产生一种冲动:
> **“其实你不了解我。”**
现在机构里也有关系不错的朋友。
但想到他们12月底可能离开,就会产生一种念头:
> **“我们离开之后,不会再像现在这么好了。”**
甚至更加极端:
> **“以后你就像没见过我似的。”**
这背后可能不只是害怕失去朋友。
更深层的问题是:
> **现在如此真实的关系,会不会因为共同生活结束,而在未来变得像从来没有发生过?**
---
# 七、“你不了解我”可能有两层含义
### 第一层
> **你认识的只是我在这个环境里的一个切面。**
朋友认识:
* 机构里的自己
* 自己的玩笑
* 学习状态
* 某些故事
* 日常表现
但他们不知道自己全部的经历、思考、恐惧、价值观。
所以:
> “你和我关系很好,但你其实只认识了我一部分。”
这是事实。
### 第二层
更深的是:
> **即使现在你了解我,以后你还会认识现在这个我吗?**
因为人会变化。
今天的自己和半年后的自己不会完全一样。
所以自己实际上在问:
> **如果一段关系依赖于共同经历,那么共同经历结束以后,这段关系还剩下什么?**
---
# 八、这里可能存在一个自己的习惯:提前站到未来看现在
现在关系很好。
但自己的意识已经开始想:
> “以后肯定会淡。”
于是人在当下,却已经站到了未来回头看这段关系。
这可能导致一种提前抽离:
> “反正以后都要分开。”
但这里需要区分:
> **以后不亲密 ≠ 现在不真实。**
很多关系确实只存在于人生的某个阶段。
高中同学、大学同学、培训机构的朋友、工作同事,都可能随着环境变化而逐渐疏远。
但未来的疏远并不能证明现在的关系是假的。
> **一段关系不需要持续一辈子,才能证明它曾经真实存在。**
---
# 九、目前最值得留下的一句话
这几次思考其实可以汇成一句:
> **我不是害怕自己改变,我真正害怕的是,在不断改变的过程中,逐渐认不出自己。**
而现在需要做的,不是拼命证明:
> “以前的我才是真正的我。”
也不是强行找回所谓的“初心”。
而是重新观察:
```text
哪些东西只是阶段性的?
哪些东西是环境造成的?
哪些东西是我主动选择的?
哪些东西即使换了环境,我依然会去做?
```
也许真正的“初心”并不是某个固定版本的自己。
而是那个更深的东西:
> **即使我换了环境、换了技术、换了生活方式,我依然愿意探索、创造、学习,并且不断回来问自己:我到底在做什么?**
这次暂停 Comp-Chao,本质上也不只是“少做一个项目”。
而是给自己留一点空间,重新听见自己的声音。
## 明日计划]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-10 补日志]]>
https://kyriechao.github.io/posts/2026/09/11-diary
2026-09-10T01:11:37.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-07 压缩项目小成]]>
https://kyriechao.github.io/posts/2026/09/07-diary
2026-09-07T11:09:38.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-04 进入新阶段MCU]]>
https://kyriechao.github.io/posts/2026/09/04-diary
2026-09-04T13:08:44.000Z
// LRU 缓存
struct node {
int data;
struct node *next, *prev;
};
struct head {
Node* head;
Node* tail;
// size_t capacity;
};
// 初始化
List* list_init() {
List* l = malloc(sizeof(List));
if (!l) return NULL;
Node* node = malloc(sizeof(Node));
if (!node) {
free(l);
return NULL;
}
node->prev = node->next = NULL;
l->head = node;
l->tail = NULL;
return l;
}
static void link_head(List* l, Node* n) {
Node* p = l->head->next;
n->next = p;
n->prev = l->head;
p->prev = n;
l->head->next = n;
}
// 头插
int insert_head(List* l, int data) {
if (!l) return -1;
Node* n = malloc(sizeof(Node));
if (!n) return -1;
n->data = data;
n->next = n->prev = NULL;
if (l->head->next == NULL) {
l->head->next = n;
n->prev = l->head;
l->tail = n;
return 0;
}
link_head(l, n);
return 0;
}
// 取任意节点
Node* fetch(List* l, int target) {
if (l == NULL) return NULL;
Node* p = l->head->next;
while (p != NULL && p->data != target) p = p->next;
if (p == NULL) return NULL;
return p;
}
// 删除尾节点
int delete_tail(List* l) {
if (!l || !l->tail) return -1;
Node* p = l->tail;
p->prev->next = NULL;
if (p->prev == l->head)
l->tail = NULL;
else
l->tail = p->prev;
free(p);
return 0;
}
// 把一个已在链表中的节点移到头部(只改指针,不 malloc、不 free)
int move_to_head(List* l, Node* node) {
if (!l || !node) return -1;
Node* prev = node->prev;
Node* next = node->next;
if (prev == l->head) return 0;
if (next == NULL) {
prev->next = NULL;
l->tail = prev;
} else {
prev->next = next;
next->prev = prev;
}
node->prev = node->next = NULL;
link_head(l, node);
return 0;
}
// 销毁
int destroy(List* l) {
Node* p = l->tail;
if (p == NULL) {
free(l->head);
free(l);
return 0;
}
while (p != NULL) {
Node* tmp = p->prev;
free(p);
p = tmp;
}
free(l);
return 0;
}
void show(List* l) {
Node* p = l->head->next;
if (p == NULL) {
printf("NULL\n");
return;
}
while (p != NULL) {
printf("%d ", p->data);
p = p->next;
}
printf("\n");
}
int main() {
// int a;
// scanf("%d", &a);
List* list = list_init();
insert_head(list, 5);
insert_head(list, 4);
insert_head(list, 3);
insert_head(list, 2);
insert_head(list, 1);
show(list);
// printf("%d\n", list->tail->data);
Node* p = fetch(list, 5);
move_to_head(list, p);
// show(list);
// destroy(list);
// insert_head(list, 1);
show(list);
// delete_tail(list);
// insert_head(list, 3);
// insert_head(list, 2);
// insert_head(list, 1);
// Node* p = fetch(list, 1);
// move_to_head(list, p);
// delete_tail(list);
// int n = delete_tail(list);
// printf("%d\n", n);
// show(list);
destroy(list);
return 0;
}
```
- 图像处理工具(使用 BMP 图像格式,实现灰度化、负片
老师之前发的让我做的项目:
- 文件压缩工具(基于哈夫曼树实现)、模糊、边缘检测等)
- 智能温控风扇、智能储物柜、智能密码锁等
我对第一第二个项目很感兴趣,第三个是能做但感觉不是很难 感觉没什么技术含量。
### Rust
无
## 思考
无
## 明日计划
1.写完Lua的练习测试 跟住老师的进度同时巩固C语言数据结构。
2.学习好MCU
3.做项目(文件压缩工具、图像处理工具、智能温控风扇、智能储物柜、智能密码锁等)
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-03 突然考试 紧张死了]]>
https://kyriechao.github.io/posts/2026/09/03-diary
2026-09-03T11:38:07.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-02 普通的一天]]>
https://kyriechao.github.io/posts/2026/09/02-diary
2026-09-02T12:23:40.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-09-01 自我认识]]>
https://kyriechao.github.io/posts/2026/09/01-diary
2026-09-01T12:23:15.000Z
当学习让我感到困难和不顺的时候,我很容易转向一个更有掌控感、更容易获得成就感的项目。
例如:
学习 C → 写得不顺 → 去完善 C-Kit → 获得快乐 → 更想继续优化 C-Kit → C 的学习进度反而被耽误。
所以我需要区分:
**我是在创造,还是在通过创造逃避“不熟练的自己”?**
这个问题暂时没有必要立刻给自己下结论,而应该通过之后的实际行为去验证。
---
这次对话里,我还发现了另一个问题:
我很容易认为很多事情都重要。
现在的我可能同时觉得:
> C 语言重要。
> 嵌入式重要。
> Rust 重要。
> Linux 重要。
> C-Kit 重要。
> 系统重要。
> 编程语言设计重要。
> 软硬件也重要。
每一个想法单独看都没有错。
真正的问题是:
**我很难接受“现在只能做其中一部分”。**
所以最后就变成了:
> 什么都舍不得放弃,什么都觉得应该做。
而现实是:
**可以同时喜欢很多东西,但不能同时认真推进所有东西。**
因此我需要开始区分:
### 主线
当前阶段最重要、真正决定未来能力的事情。
### 兴趣
我喜欢研究、创造,但不应该抢走主线资源的事情。
### 休息
不以成长和产出为目的,只为了恢复状态的时间。
这三种事情都可以让我快乐,但不能互相冒充。
---
我以前容易把“休息”理解成完全什么都不做。
但现在我觉得,对我而言,休息未必一定是躺着发呆。
**从当前任务切换到另一件低压力、没有考核的事情,同样可以是休息。**
例如散步、玩游戏、看电影、做饭、研究一些完全无关紧要的小东西。
关键不在于有没有行动,而在于:
> **这件事情是在恢复我,还是只是让我换一个方向继续工作?**
如果我嘴上说自己在休息,实际上却一直想着学习、优化项目、研究技术,那么我其实并没有真正退出“必须进步”的状态。
---
这次对话让我重新理解了“认识自我”。
真正认识自己,也许不是一直问:
> “我到底是一个什么样的人?”
而是观察:
> 我什么时候会逃避?
> 我通常逃避到哪里?
> 什么事情让我获得强烈的掌控感?
> 什么事情虽然痛苦,但确实让我变强?
> 什么事情只是让我当下舒服?
> 我面对困难、失败、无聊和不确定性时,到底会怎么选择?
**人格和自我认识,不应该只建立在自我描述上,也应该建立在长期行为模式上。**
所以接下来,我不应该急着判断自己是懒惰、完美主义、爱思考,还是喜欢创造。
我更应该观察自己。
我尤其需要观察:
> **当我不舒服的时候,我是在坚持一件值得坚持的事情,还是在逃避一件让我暴露自己“不够好”的事情?**
这可能是我这次对话里最重要的问题。
最后,我想提醒自己:
> **不是所有痛苦都意味着方向错误,也不是所有快乐都意味着方向正确。**
>
> **短期的舒服,只能说明我现在感觉不错;长期反复的选择,才更接近真正的自己。**
而现在的我,真正需要练习的可能不是“找到唯一正确的人生答案”,而是:
**学会在众多都重要的事情里,选择当前最重要的一件,然后暂时允许其他事情排队。**
## 明日计划]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-31 C Kit完结]]>
https://kyriechao.github.io/posts/2026/08/3/31-diary
2026-08-31T12:57:25.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-26 周三 哈希表]]>
https://kyriechao.github.io/posts/2026/08/2/26-diary
2026-08-26T12:39:45.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-24 周一 · 结构体、共用体、枚举与 I/O]]>
https://kyriechao.github.io/posts/2026/08/2/24-diary
2026-08-24T13:37:26.000Z
`;`(*p).m` 与 `p->m` 完全等效;同类型结构体可整体赋值 `b2 = b1`
- **堆区结构体**:`malloc(sizeof(结构体类型))` 分配,用完 `free`
- **内存对齐**:成员相对地址 = "成员宽度与对齐系数较小值"的整数倍;总大小 = "最大成员宽度与对齐系数较小值"的整数倍;数组成员按元素宽度对齐,嵌套结构体成员按其最大成员宽度对齐;64 位默认对齐 8,32 位默认 4,`#pragma pack` 可改 1/2/4/8
- **结构体与函数**:强烈建议用指针做参数/返回值(值传递是整体拷贝,数据量大时开销大);只读函数参数加 `const`;返回 malloc 的结构体由调用者负责 `free`
- **结构体数组 / 嵌套 / 位域**:`stus[i]` ≡ `*(stus + i)`;嵌套成员逐层用 `.` 访问如 `stu1.birth.year`;位域 `类型 成员名:位数` 共用内存,嵌入式寄存器操作常用(如 `id:10 + age:7 + sex:1 + money:14 = 32` 位)
#### 共用体、枚举与 I/O(Day21)
**共用体(union)**:所有成员**共用同一块内存**,总大小 = 宽度最大成员的大小;访问**最近一次被赋值**的成员才有意义。
```c
d1.l = 0x67666564636261; // 小端下内存低地址→高地址:61 62 63 64 65 66 67
printf("%s\n", d1.cs); // 输出 "abcdefg"(依赖小端字节序)
```
- 应用:不同角色不同考核标准(学生看分数/老师看等级/招生看人数)、拆分 `float` 的 4 个字节
**枚举(enum)**:本质就是 `int`,只是取值有限且给每个值起了有意义的名字,可读性比直接用 `int` 好。
```c
enum xueli { chuzhong, gaozhong, benke = 5, dazhuan = 8, yanjiusheng };
// 取值:0, 1, 5, 8, 9(默认从 0 开始每项 +1,可显式赋值,其后在此基础上继续 +1)
// 不同枚举类型之间元素不能同名
```
- **I/O 三种**:标准 I/O、文件 I/O、串 I/O
- **标准 I/O**:`stdin`/`stdout` 行缓冲,`stderr` 无缓冲(专门输出异常/错误);三种缓冲机制:无缓冲/行缓冲/全缓冲;进程正常结束自动刷新所有 I/O 缓冲区;`scanf` 只从标准输入缓冲区提取期望类型的数据,返回值为成功提取的个数,失败返回 0,缓冲区空则等待
- **文件 I/O**:三步曲 `fopen` → `fread`/`fwrite` 等 → `fclose`;打开模式 `w`(不存在则创建、存在则清空)、`r`(不存在或不可读则失败返回 NULL)、`a`(追加,写入指针初始在文件末尾);另有 `r+/w+/a+` 和 `b` 二进制模式;文本文件(纯字符/字符串)vs 二进制文件(含 int/float/结构体等,文本编辑器打开显示乱码)
- **串 I/O**:`sscanf`(字符串 → 其他类型)、`sprintf`(其他类型 → 字符串)
- **三个标准文件指针**:`stdin`/`stdout`/`stderr` 系统自动打开;`printf` ≡ `fprintf(stdout,...)` ≡ `fputs(...,stdout)`;`getchar` ≡ `scanf("%c",&c)` ≡ `fscanf(stdin,...)` ≡ `fgetc(stdin)` ≡ `fread(&c,1,1,stdin)`
#### 今日笔记整理
将 Day19/20/21 三篇笔记整理重排,修正的笔误包括:Day20 两处 `char name[31]` 漏分号;Day21 `fputs` 参数顺序写反、`sex_t s1 = v` 笔误。
### Rust
无。
## 思考
无。
## 明日计划
1. C 语言:完成今日作业(strncpy / strcat / 字符串转 int / 图书记录系统增删改查 / 判断字节序)
2. C 语言:文件 I/O 深入(fread/fwrite 二进制读写)
3. Rust:恢复学习节奏]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-20 结构体与动态内存管理]]>
https://kyriechao.github.io/posts/2026/08/2/20-diary
2026-08-20T13:54:04.000Z
"一切皆空,但空不是一切"——`void*` 能承接任意指针,但它自身不知道指向什么类型。C 语言通过 `void*` 实现**泛型编程(GP, General Programming)**:与具体数据类型无关的编程处理方式。
#### 内存管理深入
五区详细对比:
| 区域 | 容量 | 管理方式 | 初始化 | 存放内容 |
| -------------------- | ------------------------ | -------- | -------- | ----------------------- |
| 栈区(Stack) | 很小(若干兆,易栈溢出) | 系统自动 | 不初始化 | 形参、非静态局部变量 |
| 堆区(Heap) | 很大 | 程序亲自 | 不初始化 | 动态分配(`malloc` 等) |
| 静态存储区(Static) | 很大 | 系统自动 | 自动清零 | 静态局部变量、全局变量 |
| 常量区(Constant) | — | 系统自动 | — | 常量(只读) |
| 代码区(Code) | — | — | — | 指令(函数体) |
> **const 的存储位置**:用 `const` 修饰的**非静态局部变量**只是"名义上的常量"(不能通过名字写),仍存在**栈区**;而 `const` 修饰的**静态局部变量**和**全局变量**才是真正常量,存在**常量区**。
**堆区内存管理库函数**(`stdlib.h`):`malloc`、`calloc`、`realloc`、`free`。另积累:`perror`(打印错误信息)、`exit`(结束程序,参数即返回值)。
| 对比 | malloc | calloc |
| ------ | -------------- | --------------------------- |
| 参数 | 1 个(字节数) | 2 个(元素个数 + 元素宽度) |
| 初始化 | 不清零 | 自动清零 |
| 效率 | 更高 | 稍低 |
| 适用 | 一般场景 | 更适合堆区数组 |
`realloc` 调整堆区空间大小:扩大时若后面空间充足就**就地扩大**(返回值 = 原指针),否则**申请更大的新空间**、拷贝旧数据、释放旧空间(返回值 ≠ 原指针)。
**内存操作库函数**:`memset`(逐字节设值)、`memcpy`(内存拷贝,不处理重叠)、`memmove`(内存拷贝,处理重叠)、`memcmp`(内存比较,全同返回 0)。
> **经典面试题**:`memcpy` 和 `memmove` 有啥区别?如何选择?——`memcpy` 假定两块内存不重叠、效率更高;`memmove` 能正确处理重叠区域(相当于"安全版"拷贝)。不确定是否重叠时用 `memmove`。
#### 结构体(Struct)
**结构体**:若干个不同类型(也可相同类型)数据构成的集合。构成结构体的数据称为**数据成员(Data Member)**,也叫属性或字段(Field)。用于表示一件商品、一个学生、一本书等信息。
结构体是**自定义数据类型**,必须先声明类型、再定义变量。声明语法:
```c
struct book
{
int isbn;
char name[31];
float price;
short type;
int cnt;
};
```
#### 双向链表练习
今日自己练习了**双向链表(doubly linked list)**:每个节点除 `next` 指向后继外,还多一个 `prev` 指向前驱。
- 节点结构:`struct Node { int val; struct Node *prev; struct Node *next; };`
- 优点:可**双向遍历**;删除节点时无需像单向链表那样额外保存前驱指针;插入更灵活
- 代价:每节点多存一个指针,插入/删除要同时维护 `prev`、`next` 两个指针
### Rust
无。
## 思考
无。
## 明日计划
1. C 语言:结构体深入(结构体指针、结构体数组、typedef 结构体)、链表进阶
2. Rust:恢复学习节奏]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-19 周三 · 二级指针与内存管理]]>
https://kyriechao.github.io/posts/2026/08/1/19-diary
2026-08-19T14:14:31.000Z
解引用层级:`*p2` 得到 `p1`(一级指针),`**p2` 才得到最终的 `s`。多级指针就是"指针的指针的指针…",每多一级就多一层间接寻址。
#### 内存管理(Memory Management)
操作系统给每个进程分配一块**独立的私有地址空间**,又分为几个区域:
| 区域 | 存放内容 |
| -------------------- | ------------------------------------ |
| 栈区(stack) | 局部变量、函数调用(形参、返回地址) |
| 堆区(heap) | 动态分配的内存(`malloc`/`free`) |
| 静态存储区(static) | 全局变量、静态变量 |
| 常量区(constant) | 字符串字面量、常量 |
| 代码区(text) | 程序的机器指令(函数体) |
> 之前学过的知识点在这里串起来了:局部变量在栈区(函数结束即释放,所以不能返回其指针);字符串字面量在常量区(只读,修改会段错误);函数在代码区(所以有函数指针);`malloc` 在堆区(手动申请/释放)。
#### 链表练习(test.c)
今日继续练习链表,`test.c` 里对比了两套实现:
- **link.c / link.h**:单向链表**简洁版**,函数名不带前缀——`create` / `insert_head` / `insert_tail` / `show` / `find` / `reverse` / `delete` / `destroy`
- **list.c / list.h**:单向链表 + 循环链表**完整版**(`link_xxx` 与 `clink_xxx` 两套)
- **main.c**:测试用例(创建 → 尾插 → 头插 → 反转 → 删除 → 查找 → 销毁)
核心操作全部覆盖:头插、尾插、打印、反转、查找、删除、销毁;循环链表版用 `head->next == head` 判断遍历终点。
### Rust
无。
## 思考
无。
## 明日计划
1. C 语言:结构体(struct)、动态内存分配深入(malloc/free)、字符串库函数
2. Rust:恢复学习节奏
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-18 周二 · typedef 与函数指针]]>
https://kyriechao.github.io/posts/2026/08/1/18-diary
2026-08-18T11:09:15.000Z
爱是一种状态,欲也是一种状态。
两者不是程度不同,而是本质不同。
#### 1. 爱是一种纯粹的状态
我理解的爱,不是"我想得到你",而是:
> 我关注的是你这个人的存在。
真正爱一个人的时候,不应该带有目的性。如果我爱一个人,却希望她幸福,即使最后陪伴她的人不是我,那这种爱似乎更接近爱的本质——因为这里没有占有、没有索取。爱的时候,就只是爱,类似进入一种心流状态:不计算得失、不考虑回报、不分析价值、不想着自己正在爱,只是单纯地存在于这种状态里。
#### 2. 欲是一种环境和基因的表达
欲望更像是:
> 基因 + 环境 + 经验共同产生的反应。
它来自人的生物本能,关注的是"我想获得什么"——可能是身体吸引、陪伴、关注、占有、满足自己的需求。因此欲望本身并不等于爱,因为欲望的方向更多是自己。
#### 3. 真爱是否存在?
我的观点:真正完全纯粹、不带任何欲望、不受环境和本能影响的爱,也许不存在。现实中的人是复杂的,感情受生理机制、社会环境、个人经历、过去记忆影响。所以"永恒的真爱"可能是一种理想状态。
但这不代表爱不存在,可能只是:
> 永恒纯粹的爱不存在,而某一刻真实发生的爱存在。
就像心流无法永久保持,但心流状态本身是真实存在的。
#### 4. 我的矛盾:为什么无法想象爱和欲同时面对一个人?
我发现自己无法想象两个场景:用纯粹的爱面对喜欢的人,和带着欲望面对喜欢的人。我感觉无法同时对一个人表达这两个方面。
因为在理解里,爱意味着"你是一个独立的人",欲望意味着"我想从你那里获得某些东西"。爱更接近"你是你",欲更接近"我想要你"。
所以冲突产生了:如果我真的爱一个人,我怎么还能对她产生欲望?如果产生欲望,我是不是已经不再爱她,而只是在满足自己?
#### 5. 进一步的问题
可能真正的问题不是"有没有欲望",而是:
> 当欲望出现的时候,我是否仍然把对方当作一个完整的人。
如果欲望意味着占有、把对方当工具,那它和爱冲突;但如果欲望只是想靠近、想连接、想表达亲密,那它可能不一定破坏爱。
#### 6. 最后的疑问
我似乎不是在寻找普通意义上的爱情,而是寻找一种:
> 不欺骗自己、不把欲望包装成爱、不把占有误认为关心的关系。
但现实中的关系可能无法达到绝对纯粹。所以矛盾是:如果绝对纯粹的真爱可能不存在,那为什么还要进入一段关系?
这次思考的核心:**爱是否必须纯粹,才能称为爱?** 或者:**真正成熟的爱,不是消灭欲望,而是在拥有欲望的时候,依然尊重对方作为一个人的存在。**
## 明日计划
1. C 语言:结构体(struct)、动态内存分配(malloc/free)、链表进阶
2. Rust:恢复学习节奏]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-17 周一 · 指针(进阶)]]>
https://kyriechao.github.io/posts/2026/08/1/17-diary
2026-08-17T11:50:53.000Z
区分秘诀:从左向右读,碰到 `const` 读"常量",碰到 `*` 读"指针"。`const int* p` 与 `int const* p` 完全等效。
#### 指针的相关运算
- **指针 ± 整数**:按**基类型宽度**偏移(不是按字节)。`p1 + 1` 偏移一个 `int` 的宽度。
- **同类型指针相减**:结果为距离,单位是基类型宽度(元素个数),不是字节数。
- **指针强制类型转换**:转换基类型,指针的**值不变**,但解引用时对内存的解释方式变了。如 `int i = 0x364241;`,用 `char*` 解引用读到 `'A'`(0x41),用 `short*` 读到 16961。
#### 数组与指针
- **指针数组**:元素是指针的数组,本质是**数组**。`int* ps[5]`,每个元素是 `int*`。
- **数组指针**:指向数组的指针,本质是**指针**。`int (*pa)[5]`,指向整个 `int[5]` 数组,`(*pa)[3] = 9` 即 `nums[3] = 9`。
- **数组名 = 首元素指针**:`nums` 等效于 `&nums[0]`,与 `&nums` 值相同但基类型不同(前者指向元素,后者指向整个数组)。
- **下标运算本质是指针运算**:`a[n]` 完全等效于 `*(a+n)`。
> 记忆技巧:`[]` 优先级高于 `*`,所以 `int* ps[5]` 先结合 `[]` 是数组;`int (*pa)[5]` 用括号让 `*` 先结合,是指针。
### Rust
无。
## 思考
无。
## 明日计划
1. C 语言:指针与函数(指针作参数/返回值)、函数指针、二级指针]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-14 周五 · 字符数组进阶与指针入门]]>
https://kyriechao.github.io/posts/2026/08/1/14-diary
2026-08-14T13:33:17.000Z
两个运算符都是**单目**,与二目的按位与 `&`、乘法 `*` 区分开。指针占位符是 `%p`。
几个关键点:
- **地址用首字节地址表示**:数据类型决定宽度,首字节地址 + 宽度即可唯一确定数据
- **大小端存储**:小端(Little Endian)低位字节存低地址,大端相反;X86/ARM 等主流平台都是**小端**
- **定义指针**:`基类型* 变量名;`,基类型 = 指针所指向的数据类型;`*p1 = 5` 与 `j = 5` 等价(通过指针/变量名访问内存)
- **NULL 指针**:值为 0,可赋给任意指针,表示"不指向任何有效内存";暂不确定指向时先初始化为 `NULL` 是好习惯
#### 附录:排序算法选型速查表
承接 Day14 排序预览,嵌入式场景选型三梯队:
| 梯队 | 算法 | 复杂度 | 定位 |
| -------- | ------------------------ | ---------- | -------------------------------------------------- |
| 第一梯队 | 计数排序 | O(n) | 数据范围极狭小时无敌(如 ADC 0~4095、温度 -40~85) |
| 第二梯队 | 快排/qsort、归并、堆排序 | O(n log n) | 通用乱序数据主力 |
| 第三梯队 | 插入、选择、冒泡 | O(n²) | 小数据或特定硬件 |
> 选型口诀:**日常业务数据用 `qsort`,排 ADC 值用计数排序,做任务调度用堆排序,排几个零散变量用插入排序。** 嵌入式项目建议直接用系统库 `qsort`,鲁棒性远高于手写。
### Rust
今天没学习,休息。
## 思考
无。
## 明日计划
1. C 语言:指针深入(指针运算、指针与数组、指针与函数)
2. Rust:恢复学习节奏]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-13]]>
https://kyriechao.github.io/posts/2026/08/1/13-diary
2026-08-13T12:36:13.000Z
下标从 0 开始是 C 设计者有意为之:`arr[i]` 底层是 `*(arr + i)`,i=0 就是首元素本身。
#### 定义数组的四种语法
| 方式 | 写法 | 特点 |
| -------------- | ------------------------- | --------------------------------- |
| 只定义不初始化 | `int a[5];` | 局部数组垃圾值,全局/静态自动清零 |
| 完全初始化 | `int b[5] = {1,2,3,4,5};` | 全部指定 |
| 部分初始化 | `int c[5] = {1,2};` | 后面自动清零 → `{1,2,0,0,0}` |
| 省略长度 | `int d[] = {1,2,3};` | 编译器推算长度 = 3 |
初始化技巧:
- 全零:`int arr[100] = {0};`(最常用)或 `memset(arr, 0, sizeof(arr))`
- 常量数组:`const int nums[5] = {...};` 必须初始化,之后不可改
- 用宏代替魔数:`#define SIZE 10`
#### 访问与遍历
数组不能整体访问,只能通过**下标运算符 `[]`** 访问单个元素,`arr[i]` 用法和普通变量完全一样。
三种遍历模式:正序 for、用 `sizeof(arr)/sizeof(arr[0])` 动态算长度(推荐)、反向遍历。
**数组内存 = 长度 × 类型宽度**,如 `int a[10]` 占 10×4 = 40 字节。
#### 数组越界
访问下标超出 `0 ~ 长度-1` 范围即越界。**C 语言不检查越界**(不像 Java/Python 抛异常)——为极致性能付出的安全代价,是 C 语言排名第一的隐形杀手。
| 情形 | 后果 |
| -------- | ------------------------------------- |
| 轻微越界 | 踩到相邻变量,数据莫名其妙被改 |
| 严重越界 | 踩到返回地址,Segmentation Fault 崩溃 |
| 最隐蔽 | 看似正常,换个环境/数据就崩 |
防御:循环条件用宏常量、`assert(index >= 0 && index < SIZE)`、手动检查。
#### 数组与函数——退化指针
数组作函数参数时**长度信息丢失**,三种写法等价:`int arr[]` / `int arr[10]` / `int *arr`,本质都是指针。必须额外传 `len` 参数。
> **sizeof 陷阱:** 函数内部 `sizeof(arr)` 只能得到指针大小(4 或 8),不是数组实际字节数。sizeof 只有在定义数组的同一作用域内才有效。
#### 多维数组、字符数组与 VLA
- **二维数组**:`int matrix[3][4]`,逻辑上矩阵,内存中**行优先**连续一维存储
- **字符数组**:C 语言无 String 类型,用 `\0`(空字符)结尾的 char 数组表示字符串。`char s[] = "Hello"` 自动加 `\0`,长度 = 6。标准库字符串函数都依赖 `\0`
- **C99 VLA**:`int arr[n]` 运行时定长,C11 变为可选、MSVC 从不支持,**嵌入式通常禁用**(栈空间不可预知),用 `malloc` 更安全
### Rust
今日起放慢 Rust 学习节奏("慢点学习"),以消化、复习已学内容为主,不赶进度。
## 思考
无。
## 明日计划
1. C 语言:进入数组常用操作(查找、插入、删除、排序、逆序)
2. Rust:保持慢节奏,复习阶段 3(集合、迭代器、Todo CLI)]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/1/13-rust-day-14
2026-08-13T12:36:13.000Z
前三天节奏偏快:Day11 一口气完成了「格式化宏 + 阶段 0 热身 + 阶段 1 所有权与借用」,Day12 完成「阶段 2」,Day13 完...]]>
前三天节奏偏快:Day11 一口气完成了「格式化宏 + 阶段 0 热身 + 阶段 1 所有权与借用」,Day12 完成「阶段 2」,Day13 完成「阶段 3」。连续高强度推进,内容消化得不够扎实,需要停下来缓一缓。
## 二、节奏调整:从明天起放慢
从明天(2026-08-14,即 Day15)开始,学习节奏放慢,主要调整如下:
| 维度 | 调整前 | 调整后 |
| ---------- | ---------------- | ------------------------------- |
| 每日内容量 | 一天一个阶段 | 一个阶段拆成 2~3 天 |
| 练习方式 | 边学边写、赶进度 | 学一块 + 独立练一块,吃透再往下 |
| 复习安排 | 无固定安排 | 每天开头先回顾前一天内容 |
> 放慢不是停滞,而是把「学完」变成「学会」。Rust 的所有权、trait、生命周期这些核心概念,慢下来反而更快。
## 三、阶段 4 拆分计划(可调整)
原计划「阶段 4:泛型 / trait / lifetime 综合」一天完成,现拆分为:
| 天 | 内容 | 说明 |
| ----- | ---------------------- | ----------------------------------------- |
| Day15 | 泛型(Generic)基础 | 泛型函数、泛型结构体、单态化 |
| Day16 | Trait 与 Trait Bound | 定义 trait、实现 trait、`impl Trait` 返回 |
| Day17 | 生命周期(Lifetime) | 生命周期标注、借用检查器 |
| Day18 | 阶段 4 综合练习 + 收尾 | 三个概念串起来的小项目 |
## 四、小结
| 事项 | 状态 |
| -------- | --------------- |
| 今日学习 | 休息,未学 |
| 节奏调整 | 从 Day15 起放慢 |
| 阶段 4 | 拆 4 天推进 |
**明天:** 慢节奏进入阶段 4,从泛型开始。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-12 周二 · 数组起步与阶段 3]]>
https://kyriechao.github.io/posts/2026/08/1/12-diary
2026-08-12T13:00:00.000Z
`sizeof` 陷阱:函数内部 `sizeof(arr)` 只能得到指针大小(4 或 8),**不是**数组实际字节数。
#### 其他
- **二维数组**:行优先存储,逻辑上矩阵,内存中连续一排
- **字符数组**:C 语言无 String 类型,用 `\0` 结尾的 char 数组表示字符串。`char s[] = "Hello"` 自动加 `\0`,长度=6
- **C99 VLA**:`int arr[n]`,C11 可选,MSVC 不支持,嵌入式通常禁用
### Rust
学习内容:[Rust Day13 笔记](12-rust-day-13.md)——**阶段 3:集合、迭代器与 Todo CLI**
#### MyStack(封装 Vec)
用 `Vec` 封装自定义栈:`push` / `pop` / `peek` / `is_empty`。`peek()` 返回 `Option<&i32>`——只借看一眼,不拿走值。
#### HashMap 核心:entry API
```rust
*hash.entry(c).or_insert(0) += 1; // 一次查+插,返回 &mut i32
```
这个模式替代了"先 get 判空,再 insert"的两步操作。练习了字符频率统计、单词频率统计(key 用 `&str` 避免多分配)、`max_by_key` 找最大 value 的 key。
#### HashSet 交集
从 O(n²) 双层 for 优化到 O(n+m):`set_b.contains(x)` 是 O(1) 的。
#### 迭代器组合技
| 操作 | 功能 |
| ------------------------ | -------------------------------- |
| `filter + map + collect` | 标准链式转换 |
| `flatten` | `Vec>` 拍平成 `Vec` |
| `sort` + `dedup` | 先排序再删相邻重复(顺序不能反) |
| `partition` | 根据谓词一次遍历分成两个 Vec |
#### 文件排序 + Todo CLI
`sort_lines_in_file`:读→`lines()`→`sort()`→`join`→写回。关键:`map(String::from)` 把借用的 `&str` 转为拥有的 `String`,避免悬垂引用。
Todo CLI 完整项目——`Task` struct + serde JSON 持久化 + 四命令(add/list/done/clear),架构:**parse_args → load → 业务 → save**。
#### 本日收获
- `HashMap::entry().or_insert()` 是最常用的 HashMap 模式
- `&str` 做 HashMap key 可以从原字符串借用,零分配
- `Box` 适合作顶层函数返回类型,灵活
- CLI 项目的基本架构模式:命令行解析 → 加载状态 → 执行操作 → 保存状态
## 明日计划
1. C 语言:跟课堂节奏,可能进入数组进阶或指针章节
2. Rust:继续阶段 3,Maybe 进入阶段 4(泛型/trait/lifetime)]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/1/12-rust-day-13
2026-08-12T00:00:00.000Z
,
}
impl MyStack {
fn new() -> Self {
MyStack { vec: Vec::new() }
}
fn push(&mut self, val: i32) {
self.vec.push(val);
}
fn pop(&mut self) -> Option {
self.vec.pop()
}
fn peek(&self) -> Option<&i32> {
self.vec.last() // last() 返回 Option<&T>,不移动所有权
}
fn is_empty(&self) -> bool {
self.vec.is_empty()
}
}
```
| 方法 | 返回类型 | 说明 |
| ---------- | -------------- | ------------------------------------- |
| `push` | `()` | 入栈,直接委托 `Vec::push` |
| `pop` | `Option` | 出栈,`Vec::pop` 本身就是 `Option` |
| `peek` | `Option<&i32>` | 看一眼栈顶,不拿走,`Vec::last()` |
| `is_empty` | `bool` | 直接用 `Vec::is_empty()` |
> `peek()` 返回 `Option<&i32>` 而不是 `Option`——只是借看一眼,不拿走值。如果用 `pop()` 就拿走了。
---
## 二、HashMap — entry API
### 2.1 字符频率统计
```rust
use std::collections::HashMap;
fn char_frequency(s: &str) -> HashMap {
let mut hash = HashMap::new();
for c in s.chars() {
*hash.entry(c).or_insert(0) += 1;
}
hash
}
```
**entry API 拆解:**
```rust
hash.entry(c) // 找到键 c 所在的槽位
.or_insert(0) // 如果不存在 → 插入 0 并返回 &mut i32;如果存在 → 返回 &mut i32
// * ... += 1 // 无论哪种情况,解引用后 +1
```
> `entry()` + `or_insert()` 是 HashMap 里最常用的模式——代替了"先 get 判空,再 insert"的两步操作。
### 2.2 单词频率统计(借用 key)
```rust
fn word_frequency(text: &str) -> HashMap<&str, i32> {
let mut hash = HashMap::new();
for word in text.split_whitespace() {
*hash.entry(word).or_insert(0) += 1;
}
hash
}
```
> 返回 `HashMap<&str, i32>` 而不是 `HashMap`——key 是从 `text` 借来的切片引用,避免每个单词都分配新 String。
### 2.3 找 value 最大的 key
```rust
fn max_value_key(map: &HashMap) -> Option<&String> {
map.iter()
.max_by_key(|&(_, v)| v) // 按 value 找最大
.map(|(k, _)| k) // 只取 key
}
```
| 步骤 | 方法 | 说明 |
| ---- | --------------- | ------------------------------------------- |
| 1 | `.iter()` | 迭代 `(&K, &V)` 键值对 |
| 2 | `.max_by_key()` | 按指定字段找最大值,返回 `Option<(&K, &V)>` |
| 3 | `.map()` | 解构只取 key |
---
## 三、HashSet — 交集
### 3.1 初版(双层 for)
```rust
fn intersection(a: &Vec, b: &Vec) -> Vec {
let mut set = HashSet::new();
for i in b {
for k in a {
if i == k { set.insert(*k); }
}
}
set.into_iter().collect()
}
```
### 3.2 改进版(集合运算)
```rust
fn intersection(a: &Vec, b: &Vec) -> Vec {
let set_b: HashSet<_> = b.iter().copied().collect();
a.iter()
.filter(|x| set_b.contains(x)) // 只在 b 中存在的才保留
.copied()
.collect::>() // 收集到 HashSet 自动去重
.into_iter()
.collect()
}
```
> 改进版 O(n+m) vs 初版 O(n×m)。`HashSet::contains` 是 O(1) 的。
---
## 四、迭代器组合技
### 4.1 filter + map + collect
```rust
let nums = vec![1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
let result: Vec = nums
.iter()
.filter(|&x| x % 2 != 0) // 取奇数: 1,3,5,7,9
.map(|&x| x * 2) // 翻倍: 2,6,10,14,18
.collect();
```
### 4.2 flatten — 拍平嵌套
```rust
let nested = vec![vec![1, 2], vec![3, 4], vec![5, 6]];
let flat: Vec = nested.into_iter().flatten().collect();
// [1, 2, 3, 4, 5, 6]
```
> `flatten()` 把 `Vec>` 变成 `Vec`,等价于 `flat_map(|v| v)`。
### 4.3 sort + dedup — 排序后去重
```rust
fn sort_and_dedup(v: &mut Vec) {
v.sort(); // 先排序(dedup 只删相邻重复)
v.dedup(); // 删除相邻重复
}
```
> `dedup()` 只删除**相邻的**重复元素,所以必须先 `sort()` 让相同元素相邻。
### 4.4 partition — 分组
```rust
fn partition(v: &Vec) -> (Vec, Vec) {
v.iter().partition(|&x| x % 2 == 0) // (偶数, 奇数)
}
```
> `partition` 根据谓词把迭代器分成两个 Vec,一次遍历完成。
---
## 五、文件排序 — `sort_lines_in_file`
```rust
use std::fs;
fn sort_lines_in_file(path: &str) -> Result<(), Box> {
let s = fs::read_to_string(path)?;
let mut vec: Vec = s.lines().map(String::from).collect();
vec.sort();
let new_content = vec.join("\n");
// 保留末尾换行
let new_content = if !vec.is_empty() {
format!("{}\n", new_content)
} else {
new_content
};
fs::write(path, new_content)?;
Ok(())
}
```
**关键步骤:**
1. `s.lines()` — 按行分割,返回 `&str` 切片
2. `.map(String::from)` — 把 `&str` 转成拥有所有权的 `String`(不然 `s` 被 drop 后切片悬垂)
3. `vec.sort()` — 排序后 `join`
4. `Box` — 返回"任意类型错误",比写死具体类型灵活
---
## 六、Todo CLI — 综合小项目
> 用 serde 持久化到 JSON,支持命令行增删查改。
### 6.1 数据结构
```rust
use serde::{Serialize, Deserialize};
#[derive(Serialize, Deserialize, Debug, Clone)]
struct Task {
id: usize,
content: String,
done: bool,
}
const FILE_PATH: &str = "tasks.json";
```
### 6.2 持久化层
```rust
fn load_tasks() -> Vec {
let content = match fs::read_to_string(FILE_PATH) {
Ok(data) => data,
Err(_) => return Vec::new(), // 文件不存在 → 空列表
};
serde_json::from_str(&content).unwrap_or_default()
}
fn save_tasks(tasks: &Vec) {
let json = serde_json::to_string_pretty(tasks).expect("序列化失败");
fs::write(FILE_PATH, json).expect("写入失败");
}
```
> `unwrap_or_default()` 在反序列化失败时返回空 Vec,容错启动。
### 6.3 业务逻辑
```rust
fn next_id(tasks: &Vec) -> usize {
tasks.iter().map(|t| t.id).max().unwrap_or(0) + 1
}
fn add_task(tasks: &mut Vec, content: String) {
tasks.push(Task { id: next_id(tasks), content, done: false });
}
fn list_tasks(tasks: &Vec) {
for task in tasks {
let status = if task.done { "[✓]" } else { "[ ]" };
println!("{} {} {}", status, task.id, task.content);
}
}
fn done_task(tasks: &mut Vec, id: usize) -> Result<(), String> {
if let Some(task) = tasks.iter_mut().find(|t| t.id == id) {
task.done = true;
Ok(())
} else {
Err(format!("任务 {} 不存在", id))
}
}
fn clear_done(tasks: &mut Vec) {
tasks.retain(|t| !t.done); // 保留未完成的
}
```
### 6.4 命令行解析
```rust
#[derive(Debug)]
enum Command {
Add(String),
List,
Done(usize),
Clear,
}
fn parse_args(args: Vec) -> Result {
if args.len() < 2 {
return Err("用法: todo_cli [add <内容> | list | done | clear]".to_string());
}
match args[1].as_str() {
"add" => Ok(Command::Add(args.get(2).ok_or("需要提供任务内容")?.clone())),
"list" => Ok(Command::List),
"done" => {
let id = args.get(2).ok_or("需要提供任务 ID")?.parse()
.map_err(|_| "ID 不是有效整数")?;
Ok(Command::Done(id))
}
"clear" => Ok(Command::Clear),
_ => Err("未知命令".to_string()),
}
}
```
### 6.5 main 组装
```rust
fn main() -> Result<(), Box> {
let args: Vec = env::args().collect();
let command = parse_args(args)?;
let mut tasks = load_tasks();
match command {
Command::Add(content) => { add_task(&mut tasks, content); save_tasks(&tasks); }
Command::List => list_tasks(&tasks),
Command::Done(id) => { done_task(&mut tasks, id)?; save_tasks(&tasks); }
Command::Clear => { clear_done(&mut tasks); save_tasks(&tasks); }
}
Ok(())
}
```
**用法:**
```bash
cargo run add "买牛奶"
cargo run list # [ ] 1 买牛奶
cargo run done 1
cargo run clear
```
---
## 七、本日小结
| 知识点 | 说明 |
| ------------------------------ | ------------------------------------------ |
| 封装 Vec 为自定义类型 | `MyStack` 四方法,`peek` 返回引用的意义 |
| `HashMap::entry().or_insert()` | 一次操作完成"查+插",返回 `&mut V` |
| `&str` 作为 HashMap key | 从原字符串借用,避免多分配 String |
| `max_by_key` | 按指定字段找最大,返回 `Option<(&K, &V)>` |
| `HashSet` 交集 | `contains()` O(1),比双层 for O(n²) 快得多 |
| `flatten` | `Vec>` → `Vec` |
| `sort` + `dedup` | 先排序再删相邻重复(顺序不能反) |
| `partition` | 谓词分组,一次遍历返回两个 Vec |
| `Box` | 返回"任意错误类型",适合顶层函数 |
| serde JSON 持久化 | `Serialize` + `Deserialize` derive |
| `env::args()` | 命令行参数解析 |
| CLI 架构 | parse → load → 业务 → save |
**明天:** 继续阶段 3,Maybe 开始阶段 4(泛型/trait/lifetime 综合)。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-11 周二 · 递归、构建过程与阶段 2]]>
https://kyriechao.github.io/posts/2026/08/1/11-diary
2026-08-11T00:00:00.000Z
简单用循环,分治/回溯用递归。不要为了递归而递归。汉诺塔是非递归极其困难、递归极其优雅的典型案例。
#### C 程序构建四工序
从 `.c` 到可执行文件,四道工序:
```
hello.c → ①预处理 → hello.i → ②编译 → hello.s → ③汇编 → hello.o → ④链接 → hello
```
| 阶段 | 负责者 | 输入 → 输出 | 做什么 | GCC 命令 |
| -------- | -------- | ------------------ | ------------------------------------------------------------ | -------- |
| ① 预处理 | 预处理器 | `.c` → `.i` | 删注释、处理 `#` 命令(`#include` copy 头文件、`#define` 宏替换、条件编译) | `gcc -E` |
| ② 编译 | 编译器 | `.i` → `.s` | C → 汇编代码,语法错误在此报 | `gcc -S` |
| ③ 汇编 | 汇编器 | `.s` → `.o` | 汇编 → 机器码,生成目标文件 | `gcc -c` |
| ④ 链接 | 链接器 | `.o` + 库 → 可执行 | 合并目标文件,解析符号引用(如 `printf` 地址),分静态链接和动态链接 | `gcc` |
几个要点:
- **`#include ` vs `"file"`** — 尖括号搜系统目录,双引号先搜当前目录
- **头文件保护** — 每个 `.h` 标配 `#ifndef` / `#define` / `#endif`,防止重复包含
- **头文件放声明性语句** — 函数声明、`extern` 全局变量、`#define` 宏、类型声明
- **`gcc hello.c -o hello`** — 一步到位,四合一
### Rust
学习内容:[Rust Day12 笔记](11-rust-day-12.md)——**阶段 2:枚举、Result、Option、自定义错误、文件 I/O**
今天在 `demo3.rs` 里写了阶段 2 的练习:
| # | 练习 | 涉及点 |
| ---- | ------------------------------ | ------------------------------- |
| 1 | `Shape` 枚举 + `area()` | `match` + 海伦公式 |
| 2 | `Operation` 枚举 + `execute()` | `match` + `Result` + 除零检查 |
| 3 | `parse_int` / `parse_float` | 字符串解析,`map_err` |
| 4 | `calculate("a/b")` | `?` 链式调用 |
| 5 | `find_in_vec` | `iter().position()` |
| 6 | `double_if_even` | `Option::filter().map()` 组合 |
| 7 | `get_or_zero` | `unwrap_or()` |
| 8 | `read_file` | `match` + `ErrorKind::NotFound` |
| 9 | `copy_file` | `fs::read` + `fs::write` |
| 10 | `MyError` 自定义错误 | `impl Display` + `impl Error` |
| 11 | `read_config` | 文件读取 + io 错误 → 自定义错误 |
| 12 | `sum_numbers` | `for` + `?`,任何一步失败就短路 |
| 13 | `while let` | 遍历 `Vec>` |
几个新收获:
- `ErrorKind::NotFound` 的模式匹配写法:`Err(e) if e.kind() == ErrorKind::NotFound`
- 自定义错误类型需要同时 `impl Display` 和 `impl Error`
- `Option::filter()` 可以直接筛 `Some` 里的值,不符合变 `None`
- `while let Some(x) = iter.next()` 处理嵌套 Option 比 `for` + 判空简洁
## 明日计划
1. C 语言:跟课堂节奏,递归章节作业
2. Rust:阶段 2 收尾,进入阶段 3]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/1/11-rust-day-12
2026-08-11T00:00:00.000Z
f64 {
match &self {
Shape::Circle(r) => PI * r * r,
Shape::Rectangle(w, h) => w * h,
Shape::Triangle(a, b, c) => {
let p = (a + b + c) / 2.0;
((p * (p - a) * (p - b) * (p - c)) as f64).sqrt()
}
}
}
}
```
> 海伦公式:`S = √(p(p-a)(p-b)(p-c))`,`p` 是半周长。每种 Shape 携带的数据不同,`match` 编译期保证每一种都被处理。
### 1.2 Operation 枚举 — 带错误的 execute
```rust
enum Operation {
Add(f64, f64),
Sub(f64, f64),
Mul(f64, f64),
Div(f64, f64),
}
impl Operation {
fn execute(&self) -> Result {
match &self {
Operation::Add(a, b) => Ok(a + b),
Operation::Sub(a, b) => Ok(a - b),
Operation::Mul(a, b) => Ok(a * b),
Operation::Div(a, b) => {
if b.eq(&0.0) {
return Err("除数不能为零".to_string());
}
Ok(a / b)
}
}
}
}
```
> 浮点数比较用 `b.eq(&0.0)` 而不是 `b == 0.0`——`f64` 未实现 `Eq`,`==` 会触发 clippy 警告。
---
## 二、`?` 链式调用 — `calculate("a/b")`
### 2.1 底层函数
```rust
fn parse_float(s: &str) -> Result {
s.parse::().map_err(|_| format!("'{}' 不是数字", s))
}
fn safe_divide(a: f64, b: f64) -> Result {
if b.eq(&0.0) {
return Err("除数不能为零".to_string());
}
Ok(a / b)
}
```
### 2.2 组合
```rust
fn calculate(expr: &str) -> Result {
let mut s = expr.trim().split("/");
let a = parse_float(s.next().ok_or("格式错误:缺少被除数")?)?;
let b = parse_float(s.next().ok_or("格式错误:缺少除数")?)?;
safe_divide(a, b)
}
```
**双层 `?` 拆解:**
```rust
s.next().ok_or("格式错误")? // ?₁:Option → Result,None 时短路
parse_float(...)? // ?₂:Result → Result,Err 时短路
```
> `ok_or` 把 `Option` 转成 `Result`,然后外层 `?` 传播错误;内层 `?` 传播 parse 失败。两次串成一条短路链。
---
## 三、Option 组合子
```rust
fn find_in_vec(v: &Vec, target: i32) -> Option {
v.iter().position(|&x| x == target)
}
fn double_if_even(n: Option) -> Option {
n.filter(|&x| x % 2 == 0) // 不是偶数 → None
.map(|x| x * 2) // 是偶数 → 翻倍
}
fn get_or_zero(n: Option) -> i32 {
n.unwrap_or(0)
}
```
| 方法 | 作用 |
| -------------- | -------------------------- |
| `position()` | 找第一个满足条件的索引 |
| `filter()` | `Some` 中值不满足 → `None` |
| `map()` | 只碰 `Some` 里的值 |
| `unwrap_or(d)` | `None` 给默认值,不 panic |
---
## 四、文件 I/O + 错误处理
### 4.1 match 守卫 `ErrorKind`
```rust
use std::fs;
use std::io::ErrorKind;
fn read_file(path: &str) {
match fs::read_to_string(path) {
Ok(con) => println!("{con}"),
Err(e) if e.kind() == ErrorKind::NotFound => println!("文件不存在: {}", path),
Err(e) => println!("读取失败: {}: {}", path, e),
}
}
```
> `Err(e) if e.kind() == ...` — match 守卫,只在模式匹配 + 条件都满足时命中。
### 4.2 文件复制
```rust
fn copy_file(src: &str, dst: &str) -> Result {
let content = fs::read(src)?; // 读
let len = content.len() as u64;
fs::write(dst, content)?; // 写
Ok(len)
}
```
> `fs::read` 和 `fs::write` 适合小文件场景——一次性读入/写出,简单直接。
---
## 五、自定义错误类型
### 5.1 定义 + 实现 trait
```rust
use std::error::Error;
use std::fmt;
#[derive(Debug)]
enum MyError {
NotFound,
InvalidInput(String),
}
impl fmt::Display for MyError {
fn fmt(&self, f: &mut fmt::Formatter<'_>) -> fmt::Result {
match self {
MyError::NotFound => write!(f, "文件未找到"),
MyError::InvalidInput(msg) => write!(f, "无效输入: {}", msg),
}
}
}
impl Error for MyError {} // 空体——继承 Debug + Display 即可
```
> 自定义错误三步:① 定义枚举 ② `impl Display` ③ `impl Error`(通常空体)。`#[derive(Debug)]` 是必须的。
### 5.2 io 错误 → 自定义错误映射
```rust
fn read_config(path: &str) -> Result {
match fs::read_to_string(path) {
Ok(c) => Ok(c),
Err(e) if e.kind() == ErrorKind::NotFound => Err(MyError::NotFound),
Err(e) => Err(MyError::InvalidInput(e.to_string())),
}
}
```
> 关键是**错误类型转换**——把标准库的 `io::Error` 映射为自己的 `MyError`,让调用方只关心自己定义的错误类型。
---
## 六、`for` + `?` — 批量操作遇错即停
```rust
fn sum_numbers(inputs: Vec<&str>) -> Result {
let mut sum = 0;
for i in inputs {
sum += parse_number(i)?; // 任何一个失败 → 整个函数返回 Err
}
Ok(sum)
}
```
> `?` 不只是用在 `match` 或 `if let` 里——`for` 循环里同样好用。这是 Rust "遇错即停"模式的常见写法。
---
## 七、`while let` — 遍历嵌套 Option
```rust
let maybe_nums = vec![Some(1), None, Some(3)];
let mut iter = maybe_nums.into_iter();
while let Some(x) = iter.next() {
println!("{:?}", x); // Some(1), None, Some(3) 逐个打印
}
```
> 替代写法:`maybe_nums.into_iter().flatten()` — 自动过滤 `None`,只保留 `Some` 里的值。
---
## 八、本日小结
| 知识点 | 说明 |
| --------------------------- | ---------------------------------- |
| `enum` + `match` | 携带不同数据的枚举,编译期穷尽检查 |
| `impl` 枚举方法 | `impl Shape { fn area(&self) }` |
| `?` 双层短路 | `ok_or(...)?` + `parse(...)?` |
| `Option::filter().map()` | 组合子链式处理 |
| `unwrap_or()` | None 给默认值,不 panic |
| `Err(e) if e.kind() == ...` | match 守卫 |
| 自定义错误 | `impl Display` + `impl Error` |
| io 错误映射 | 标准库错误 → 自定义错误类型 |
| `for` + `?` | 批量遇错即停 |
| `while let` | 遍历嵌套 Option |
**明天:** 阶段 2 收尾,进入阶段 3。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-10 周一 · 阶段 0 & 1 完成]]>
https://kyriechao.github.io/posts/2026/08/1/10-diary
2026-08-10T13:00:00.000Z
= 0; k--) {
if (byte & (1 << k)) count += 1;
}
}
return count;
}
// 方法二:查表法(每半个字节查一次,O(n) 但常数小)
int counter_binary2(const unsigned char *p, int n) {
int count = 0;
const int popcount[16] = {0,1,1,2,1,2,2,3,1,2,2,3,2,3,3,4};
for (int i = 0; i < n; i++) {
unsigned char byte = p[i];
count += popcount[byte & 0x0F]; // 低 4 位
count += popcount[byte >> 4]; // 高 4 位
}
return count;
}
```
> 查表法用空间换时间,一个字节拆成两个 nibble(半字节),每个查一次 16 元素的表。
**2. 冒泡排序、`strcpy`、`strcmp` 手写实现**
**3. `sizeof` 与指针运算:**
```c
char str[] = "memory";
char *p = str + 1;
printf("%lu\n", sizeof(str)); // 7(数组,包含 '\0')
printf("%lu\n", sizeof(p)); // 4(指针,32 位平台)
printf("%lu\n", sizeof(a)); // 8(struct:char 1 + 对齐 3 + int 4)
unsigned char *p1 = (unsigned char *)0x80100000;
printf("%x\n", p1 + 5); // 0x80100005
```
### Rust
学习内容:[Rust Day11 笔记](10-rust-day-11.md)——**格式化宏 + 阶段 0 热身 + 阶段 1 所有权与借用**
#### 格式化宏
Rust 用 `{}` 替代 C 的 `%`,核心区分两个 trait:`Display`(`{}`,面向用户)和 `Debug`(`{:?}`,面向开发者)。完整格式说明符:`{ [参数] : [填充] [对齐] [符号] [#] [0] [宽度] [.精度] [类型] }`。
#### 阶段 0 热身(10 题)✅
温/摄氏度转换、BMI 计算、闰年判断、乘法表、最大公约数/最小公倍数、素数判断、阶乘 & 斐波那契、菱形打印、猜数字——10 道题覆盖基础语法。
#### 阶段 1 所有权与借用 ✅
今天全部走完,逐个概念拆开练习,按理解顺序排列:
| # | 概念 | 一句话 |
| ---- | ------------------ | -------------------------------------------- |
| 1 | 所有权转移 | 传参后原变量不能再用 |
| 2 | 不可变借用 `&T` | 借出去还能要回来,可同时多个 |
| 3 | 可变借用 `&mut T` | 同一时刻只能有一个,且不能和 `&T` 共存 |
| 4 | `&str` 切片 | 比 `&String` 更通用,`String` 和字面量都能传 |
| 5 | 生命周期 `'a` | 标注引用有效范围,编译期防止悬垂引用 |
| 6 | `take_ownership` | `String` → `Vec`,原值被消费 |
| 7 | 返回切片引用 | `first_word`:返回 `&str`,不复制数据 |
| 8 | `swap` | 通过 `&mut` 交换值,需解引用 `*a` |
| 9 | `&[T]` 切片 | Vec 和数组自动转切片,函数参数首选 |
| 10 | `while` 删除模式 | 删除不加 i,不删才加 i——替代有 bug 的 `for` |
| 11 | 迭代器链 | `filter` + `copied` + `collect`,返回新 Vec |
| 12 | `Option<(&T, &T)>` | 返回多个引用的首尾元素 |
| 13 | 字符串切片 | `find(char::is_whitespace)` 找位置切分 |
| 14 | 字符串反转 | `chars().rev().collect()`,一行 |
**核心规则:** 一个值一个所有者 → 传参会转移 → 不想转移就用 `&` 借用 → 需要改就用 `&mut` → 返回引用加生命周期 → 视图用切片。
几个印象深的点:
- `for i in 0..v.len()` + `v.remove(i)` 有 bug:`v.len()` 不变但数组变短,索引越界 + 跳元素
- `while i < v.len()` + 删了不 `i++`:删完后下一个元素自动移到当前位置
- `&str` 为什么总比 `&String` 好:`&String` 只能传 `String` 的引用,`&str` 可以传 `&String`、字符串字面量、切片——范围大得多
## 思考
今天突然意识到一件事:**我似乎一直在要求自己的思考必须被输出。**
每天写日志,慢慢形成了一种习惯——如果几天没有输出什么思考,就会觉得自己应该产生一点什么,于是强迫自己去思考、去记录。
这有点像薛定谔的猫:在我把思考写下来之前,我似乎无法确认自己今天到底有没有产生值得记录的思考。于是我会主动"打开盒子",强迫它变成一个确定的结果。
但今天特别的地方在于,我第一次比较清楚地**知道自己到底在说什么**。以前可能只是"感觉不对",却很难准确描述。今天我能把它说出来:
**我似乎不是强迫自己思考,而是在强迫思考必须留下可观察、可输出的结果。**
也许思考本身不需要每天都有结果。有时候没有什么值得记录的东西,也可以只是没有什么值得记录的东西。
至少今天,我知道了自己在想什么。
## 明日计划
1. C 语言:跟课堂节奏,继续变量/函数章节
2. Rust:进入阶段 2(结构体、枚举、错误处理、集合)]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/1/10-rust-day-11
2026-08-10T00:00:00.000Z
`[]` 内的部分都是可选的。
### 1.1 占位符基础
```rust
// 默认占位符 —— 使用 Display trait
println!("{} 天", 31); // 31 天
// 位置参数 —— 可重复、可调整顺序
println!("{0}, 这是 {1}。{1}, 这是 {0}", "爱丽丝", "鲍勃");
// 命名参数
println!("{subject} {verb} {object}",
object="那只懒狗",
subject="那只敏捷的棕色狐狸",
verb="跳过");
```
### 1.2 格式说明符速查
| 组成部分 | Rust 语法 | C 类比 |
| -------- | -------------------------- | -------- |
| 填充字符 | `{:-<10}` | 无 |
| 对齐方式 | `<` 左 / `>` 右 / `^` 居中 | `-` 标志 |
| 符号 | `+` 始终显示 / `-` 仅负号 | `+` 标志 |
| 备用格式 | `#`(如 `{:#x}` → `0xff`) | `#` 标志 |
| 零填充 | `0` | `0` 标志 |
| 宽度 | 数字或 `{n}$` | 数字 |
| 精度 | `.数字`(如 `{:.2}`) | `.数字` |
### 1.3 类型(转换字符)
| Rust | C 类比 | 说明 |
| --------- | ----------- | ----------------------------- |
| (无) | `%s` | `Display` trait,用户友好输出 |
| `?` | 无 | `Debug` trait,调试输出 |
| `#?` | 无 | 美化 Debug 输出 |
| `b` | 无 | 二进制 |
| `o` | `%o` | 八进制 |
| `x` / `X` | `%x` / `%X` | 十六进制 |
| `p` | `%p` | 指针地址 |
### 1.4 `Display` vs `Debug`
| Trait | 占位符 | 用途 | 实现方式 |
| --------- | ------ | ---------- | ------------------------------ |
| `Display` | `{}` | 面向用户 | 需手动实现 |
| `Debug` | `{:?}` | 面向开发者 | 可 `#[derive(Debug)]` 自动派生 |
```rust
#[derive(Debug)]
struct Point { x: i32, y: i32 }
let p = Point { x: 10, y: 20 };
println!("{:?}", p); // Point { x: 10, y: 20 }
// println!("{}", p); // 错误!没有实现 Display
```
> Rust **没有** C 的长度修饰符(`%ld`、`%zu`),类型信息在编译时已知,无需手动指定。
---
## 二、阶段 0:热身(10 题)
> 熟悉基础语法,每道题都是独立的 `main()` 函数。
### 2.1 题目清单
| # | 练习 | 涉及知识点 |
| ---- | ----------------------- | -------------------------------------- |
| 1 | 摄氏度 → 华氏度 | `read_line` + `parse` + `flush` |
| 2 | BMI 计算 | `split_whitespace` 解析多个输入 |
| 3 | 闰年判断 | `if` + 逻辑运算符 |
| 4 | 乘法表 | 嵌套 `for` + `{:02}` 宽度格式化 |
| 5 | 最大公约数 & 最小公倍数 | 辗转相除 `gcd2` + 穷举 `gcd` |
| 6 | 素数判断 | `sqrt` 优化 + `step_by(2)` 跳过偶数 |
| 7 | 阶乘 & 斐波那契 | 递归版 vs 迭代版 `fibonacci2` |
| 8 | 菱形打印 | `abs(i - n/2)` 算空格数 |
| 9 | 猜数字 | `rand::rng()` + `match` + `Ordering` |
| 10 | 输入输出综合 | `io::stdin()` + `io::stdout().flush()` |
### 2.2 核心代码片段
```rust
// 辗转相除法
fn gcd2(n: i32, m: i32) -> i32 {
let mut m = m.abs();
let mut n = n.abs();
while m != 0 {
let temp = m;
m = n % m;
n = temp;
}
n
}
// 素数判断(sqrt 优化 + 跳偶数)
fn prime(n: i32) -> bool {
if n == 2 { return true; }
if n < 2 || n % 2 == 0 { return false; }
let limit = (n as f64).sqrt() as i32 + 1;
for i in (3..=limit).step_by(2) {
if n % i == 0 { return false; }
}
true
}
// 菱形打印
for i in 0..n {
let offset = (i - n / 2).abs(); // 距中心行距离
for _ in 0..offset { print!(" "); }
for _ in 0..(n - 2 * offset) { print!("*"); }
println!();
}
// 猜数字
let number = rand::rng().random_range(1..=100);
loop {
let guess: i32 = match num.trim().parse() {
Ok(num) => num,
Err(_) => continue, // 非数字 → 重来
};
match guess.cmp(&number) {
Ordering::Less => println!("太小了!"),
Ordering::Greater => println!("太大了!"),
Ordering::Equal => { println!("你赢了!"); break; }
}
}
```
---
## 三、阶段 1:所有权与借用(完成)
> 逐个概念拆开练习,从所有权转移到切片,全部跑通。
### 3.1 所有权转移
```rust
fn print_length(s: String) {
println!("长度: {}", s.len());
} // s 在此被 drop
fn main() {
let s = String::from("hello");
print_length(s);
// println!("{s}"); // ❌ s 的所有权已经被移走
}
```
### 3.2 不可变借用 `&T`
```rust
fn print_length(s: &String) {
println!("长度: {}", s.len());
}
fn main() {
let s = String::from("hello");
print_length(&s); // 借出去
println!("{}", s); // ✓ 还能用,只是借了一下
}
```
### 3.3 可变借用 `&mut T`
```rust
fn append_exclamation(s: &mut String) {
s.push_str("!");
}
fn main() {
let mut s = String::from("hello");
append_exclamation(&mut s);
println!("{}", s); // "hello!"
}
```
### 3.4 `&str` — 字符串切片
```rust
fn get_length(s: &str) -> usize {
s.len()
}
fn main() {
let s = String::from("hello");
let len1 = get_length(&s); // &String 自动转 &str(Deref 强制转换)
let len2 = get_length("world"); // 字面量本身就是 &str
println!("{} {}", len1, len2);
}
```
> `&String` 可以自动转为 `&str`,因此函数参数写 `&str` 比 `&String` 更通用。
### 3.5 生命周期标注
```rust
fn longer<'a>(a: &'a str, b: &'a str) -> &'a str {
if a.len() > b.len() { a } else { b }
}
fn main() {
let s1 = String::from("short");
let s2 = String::from("loooooong");
let result = longer(&s1, &s2);
println!("{}", result); // "loooooong"
}
```
> 当返回值是引用时,编译器需要知道它来自哪个参数——`'a` 告诉编译器:返回值与两个参数活得一样久。
### 3.6 所有权转换:`String` → `Vec`
```rust
fn take_ownership(s: String) -> Vec {
s.chars().collect()
}
fn main() {
let s = String::from("hello");
let chars = take_ownership(s);
// println!("{s}"); // ❌ s 已死
println!("{:?}", chars); // ['h', 'e', 'l', 'l', 'o']
// chars 拥有的是从 s 中拆出来的字符,s 本身已被消费
}
```
### 3.7 返回切片的引用 — `first_word`
```rust
fn first_word(s: &str) -> &str {
match s.find(char::is_whitespace) {
Some(index) => &s[..index],
None => s,
}
}
fn main() {
let s = String::from("hello world");
let word = first_word(&s);
println!("{}", word); // "hello"
let s2 = "no_space";
println!("{}", first_word(s2)); // "no_space"
}
```
> 返回的 `&str` 是从原字符串"借"出来的一个视图,不复制数据。
### 3.8 `swap` — 通过可变引用交换值
```rust
fn swap(a: &mut i32, b: &mut i32) {
let temp = *a; // 解引用取值
*a = *b; // 解引用赋值
*b = temp;
}
fn main() {
let mut x = 5;
let mut y = 10;
swap(&mut x, &mut y);
println!("x = {}, y = {}", x, y); // x = 10, y = 5
}
```
### 3.9 切片 `&[T]` — 数组和 Vec 通用
```rust
fn sum_slice(nums: &[i32]) -> i32 {
let mut sum = 0;
for i in nums { sum += i; }
sum
}
fn main() {
let v = vec![1, 2, 3, 4, 5];
println!("{}", sum_slice(&v)); // 15(Vec 自动转切片)
let arr = [10, 20, 30];
println!("{}", sum_slice(&arr)); // 60(数组也能当切片传)
}
```
> `&[T]` 是 Rust 里最通用的"连续数据视图"——Vec 和数组都能自动转为它。
### 3.10 `while i < v.len()` 删除模式
**为什么 `for i in 0..v.len()` + `v.remove(i)` 有 bug?**
因为 `v.len()` 在循环开始时就被固定了,`remove` 之后数组长度变了但 `v.len()` 不变,导致:
1. 索引越界
2. 删除后后续元素前移,下一次 `i++` 会跳过一个元素
**正确做法:**
```rust
fn clear_short(v: &mut Vec) {
// 原地删除长度 < 3 的字符串
let mut i: usize = 0;
while i < v.len() {
if v[i].len() < 3 {
v.remove(i); // 删除后不 i++,因为下一个元素移到当前位置了
} else {
i += 1;
}
}
}
fn remove_even(v: &mut Vec) {
let mut i = 0;
while i < v.len() {
if v[i] % 2 == 0 {
v.remove(i);
} else {
i += 1;
}
}
}
```
> 口诀:**删了就不加,不删才加一。**
### 3.11 迭代器链 — filter + copied + collect
```rust
fn get_even(nums: &Vec) -> Vec {
nums.iter()
.filter(|&&x| x % 2 == 0)
.copied()
.collect()
}
```
### 3.12 `Option<(&T, &T)>` — 返回多个引用
```rust
fn get_first_and_last(v: &Vec) -> Option<(&i32, &i32)> {
if v.is_empty() {
return None;
}
Some((&v[0], &v[v.len() - 1]))
}
```
### 3.13 字符串切片 — `split_at_space`
```rust
fn split_at_space(s: &str) -> (&str, &str) {
match s.find(char::is_whitespace) {
Some(index) => (&s[..index], &s[index + 1..]),
None => (s, ""),
}
}
```
### 3.14 字符串反转 — 一行
```rust
fn reverse_string(s: &str) -> String {
s.chars().rev().collect()
}
```
---
## 四、阶段 1 核心规则总结
| 规则 | 说明 |
| -------------------- | ---------------------------------------------------- |
| 一个值只有一个所有者 | `let s = ...` 之后,`s` 拥有这个值 |
| 所有权转移(move) | 赋值、传参、返回会转移所有权 |
| 借用 `&T` | 不可变借用,可同时存在多个 |
| 可变借用 `&mut T` | 可变借用,同一时刻只能有一个,且不能和不可变借用共存 |
| 切片 `&[T]` / `&str` | 不拥有数据,只是"借用"一段连续内存的视图 |
| 生命周期 `'a` | 标注引用的有效范围,编译器用来自动检查悬垂引用 |
### `String` vs `&str` vs `&String` 速查
| 类型 | 拥有数据? | 分配在堆? | 何时用 |
| --------- | ---------- | ---------- | ------------------------------ |
| `String` | 是 | 是 | 需要修改、拥有数据 |
| `&str` | 否(借用) | 否 | 只读访问,函数参数首选 |
| `&String` | 否(借用) | 否 | 几乎不用,直接用 `&str` 更通用 |
---
## 五、明天计划
进入阶段 2:结构体、枚举、错误处理、集合。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-08 周五 · LED 驱动练习]]>
https://kyriechao.github.io/posts/2026/08/0/08-diary
2026-08-08T13:00:00.000Z
= 100) { // 100 级为一个完整周期
cnt = 0;
if (++cycle >= 5) { // 每 5 个周期改一次占空比
cycle = 0;
if (dir) { if (++pwm >= 100) dir = 0; } // 渐亮
else { if (--pwm == 0) dir = 1; } // 渐暗
}
}
```
> PWM 原理:通过调节亮/灭的时间比例(占空比)实现 LED 亮度的平滑变化。`pwm` 值从 0 到 100 再到 0,对应 LED 从灭到最亮再到灭。
#### 寄存器配置笔记
```c
// P3 口推挽输出
P3M0 |= 0x80; // P37 推挽输出(0x80 = 1000 0000)
P3M1 &= ~0x80;
// 定时器 0 配置
AUXR |= 0x80; // 12T 模式
TMOD = 0x01; // 定时器 0,16 位模式
TH0 = 0xFB; TL0 = 0xB4; // 0.1ms 定时初值
ET0 = 1; EA = 1; TR0 = 1; // 开中断,启动定时器
```
### Rust
今天没写 Rust。
## 明日计划
周末(周六、周日)休息,不安排学习任务。
## 思考
周五到周日休息,无深入思考。这三天给自己留白——之前聊到的"持续运行不等于持续成长",休息本身就是成长的一部分。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-05 周三 · C 语言函数]]>
https://kyriechao.github.io/posts/2026/08/0/05-diary
2026-08-05T13:00:00.000Z
为什么要临时文件 + rename?直接覆盖原文件时如果中途崩溃,原文件就损坏了。
**3. 递归计算目录大小** — `symlink_metadata`(不跟随符号链接,避免死循环),遇无权限文件打警告跳过而不是直接崩溃
## 思考
### 一个人应该依据什么评价自己?
以前人们习惯用外部标准评价自己:成功或失败、他人的认可或否定、财富、地位、结果。但这些评价本质上都是人类赋予的意义,并不是事物天然拥有的属性。"成功"和"失败"本身也是人的价值体系产生的概念。如果没有人类,没有评价主体,一幅画、一项技术、一次胜利或者失败,都只是一种存在状态。因此,**人的价值不应该完全依赖外界评价。**
### 关于王阳明"知行合一"的理解
它不是简单地把大道理全部记住然后强迫自己执行。真正的知行合一,是**内心真正认可某件事情,并且行动自然符合这种认识。** 这里的"心"不是普通的情绪和欲望,而是经过良知判断后的内心。如果只是因为舒服所以去做某件事情,并不代表知行合一。例如作弊——可能带来短暂利益和满足,但它违背了自己的原则,因此不是良知上的选择。真正的知行合一,是知道什么是正确的,并且愿意按照这个判断行动,即使没有外部监督。
### 如何认可自己,建立内核
一个人的自信不应该建立在"我一直成功,所以我相信自己"——这种自信很脆弱。更稳定的自信来源于:**无论面对成功还是失败,我都有能力面对、调整和继续前进。** 真正认可自己,不是认可每一次结果,而是认可自己的选择过程:是否违背自己的原则、是否持续成长、是否朝自己认可的方向前进。
### 关于坚持初心
"不忘初心"并不是永远坚持最初的想法,因为最初的想法可能包含幻想。真正应该坚持的是更深层的东西:表层目标可能改变(想成为某种职业,后来发现路径不适合,可以调整),但深层价值可以保持(想创造东西、想理解世界、想提升自己的能力)。
所以:**改变方法,不一定是背叛初心。** 真正需要判断的是:我是因为认识更深所以改变,还是因为遇到困难所以逃避。
### 对自己的观察
我发现自己已经形成了一些长期坚持:考试一直坚持不作弊,即使没有人监督;持续学习编程;持续写项目;持续思考技术、人生和价值问题;即使没有人关注,也愿意继续做自己认为有意义的事情。这些事情说明:我的行动已经不完全依赖外界评价,而是在建立自己的价值体系。
### 需要改进的地方
但是我也发现:自己还不能完全放松。如果一天完全不学习、不思考、不创造,就会感觉这一天被浪费。我的大脑似乎一直有一个后台程序运行——无论走路、学习甚至睡觉,都在思考问题。这既是一种优势,也可能成为压力。因为**持续运行不等于持续成长。** 人的成长不仅来自行动,也来自休息、沉淀和整合。休息不是浪费时间,而是成长过程的一部分。
真正强大的状态不是"我永远不能停止",而是**"我可以停下来,因为我知道自己还会继续前进。"**
### 最后的理解
人的内核不是来自"我永远正确",而来自**"即使发现自己错误,我也有能力面对并修正。"** 真正的坚定不是拒绝改变,而是在不断变化中,保持自己认可的方向。评价自己的标准应该逐渐从"别人是否认可我"转变为**"我是否忠于自己的原则,并且持续成为自己认可的人。"**
## 明日计划
1. C 语言:跟课堂节奏,完成函数章节作业
2. Rust:打算做个小项目
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/0/05-rust-day-10
2026-08-05T00:00:00.000Z
今天没有跟 Rustlings,自己写了三个文件操作函数练手。
---
## 一、统计文件行数 — `BufReader::lines()`
```rust
use std::fs::File;
use std::io::{BufRead, BufReader};
fn count_lines(path: &str) -> Result {
let file = File::open(path)?;
let reader = BufReader::new(file);
let mut count = 0;
for _ in reader.lines() {
count += 1;
}
Ok(count)
}
```
**逐行拆解:**
| 步骤 | 代码 | 说明 |
| ---- | ---------------------- | -------------------------------------- |
| 1 | `File::open(path)?` | 打开文件,失败时 `?` 直接返回 `Err` |
| 2 | `BufReader::new(file)` | 包装成带缓冲的读取器,减少系统调用次数 |
| 3 | `reader.lines()` | 返回一个迭代器,每次 `next()` 读一行 |
| 4 | `for _ in ...` | 逐行迭代,不关心内容,只计数 |
**`lines()` 的细节:**
- 返回 `io::Result`,每次读取自动处理 `\n`、`\r\n` 跨平台换行
- 每行末尾的换行符会被自动去掉
- 遇到读取错误时,下一次迭代返回 `Err`
---
## 二、文件内容替换 — 临时文件 + 原子重命名
```rust
use std::fs;
fn replace_in_file(path: &str, from: &str, to: &str) -> Result<(), std::io::Error> {
let content = fs::read_to_string(path)?; // 1. 一次性读入内存
let new_content = content.replace(from, to); // 2. 字符串替换
let temp_path = format!("{}.tmp", path);
fs::write(&temp_path, new_content)?; // 3. 写到临时文件
fs::rename(&temp_path, path)?; // 4. 原子重命名
Ok(())
}
```
**为什么用临时文件而不是直接覆盖?**
```
❌ 直接写原文件:
打开原文件 → 写入 → 中途崩溃 → 原文件损坏(一半旧一半新)
✅ 临时文件 + rename:
写 .tmp → 成功 → rename(原文件) → 失败也不影响原文件
→ 崩溃 → .tmp 损坏,原文件完好无损
```
> `rename` 在同一个文件系统上是原子操作——要么成功替换,要么什么都没发生。这是保证数据安全的经典模式。
**`fs::read_to_string` vs `BufReader`:**
| 方法 | 适用场景 |
| -------------------- | ------------------------------------------ |
| `read_to_string` | 文件不大,需要一次性处理全部内容(如替换) |
| `BufReader::lines()` | 文件很大,逐行处理省内存(如统计行数) |
---
## 三、递归计算目录大小
```rust
use std::fs::{self, read_dir};
use std::path::Path;
fn dir_size(path: impl AsRef) -> Result {
let path = path.as_ref();
let meta = fs::symlink_metadata(path)?;
// 文件或符号链接 → 直接返回大小
if meta.is_symlink() || meta.is_file() {
return Ok(meta.len());
}
// 目录 → 递归累加
if meta.is_dir() {
let mut total = 0;
for entry in read_dir(path)? {
let entry = entry?;
match dir_size(&entry.path()) {
Ok(size) => total += size,
Err(e) => eprintln!("Warning: {}: {}", entry.path().display(), e),
}
}
Ok(total)
} else {
Ok(0)
}
}
```
**三个设计决策:**
### 3.1 `symlink_metadata` 而不是 `metadata`
| 方法 | 跟随符号链接? | 风险 |
| ------------------ | -------------- | ----------------------------------- |
| `metadata` | 是 | 符号链接指向自身 → 死循环 |
| `symlink_metadata` | 否 | 安全,但需要手动判断 `is_symlink()` |
> `symlink_metadata` 获取文件自身的信息,不会跟随符号链接。遇到符号链接直接返回它的大小(通常是路径字符串的字节数),不往下追。
### 3.2 `impl AsRef` 而不是 `&str`
```rust
// ✓ 兼容多种传参方式
dir_size("/tmp"); // &str
dir_size(String::from(".")); // String
dir_size(Path::new(".")); // &Path
dir_size(&path_buf); // &PathBuf
```
> `AsRef` 让函数对调用者更友好,标准库里大量使用这种写法。
### 3.3 遇错打印警告而不是直接崩溃
```rust
match dir_size(&entry.path()) {
Ok(size) => total += size,
Err(e) => eprintln!("Warning: {}: {}", entry.path().display(), e),
// 不 return Err —— 跳过一个文件无伤大雅
}
```
如果是没有权限访问的子目录(如 Windows 的 `System Volume Information`),跳过它继续统计其余部分,比直接报错退出更实用。
---
## 四、本日小结
| 知识点 | 说明 |
| -------------------- | ----------------------------------------- |
| `BufReader::lines()` | 逐行迭代,自动处理跨平台换行 |
| `read_to_string` | 小文件一次性读入内存 |
| `rename` 原子性 | 临时文件 + rename = 安全的文件替换 |
| `symlink_metadata` | 不跟随符号链接,防死循环 |
| `impl AsRef` | 让函数接受多种路径类型 |
| 容错处理 | 非致命错误打 warning 跳过,不中断整体流程 |
**明天继续文件 I/O 还是回 Rustlings?** 还剩 smart_pointers、threads、macros、clippy、conversions 五个模块。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-08-04 周一 · 并发初通]]>
https://kyriechao.github.io/posts/2026/08/0/04-diary
2026-08-04T13:00:00.000Z
真正的噩梦是**运行时 Bug**——编译通过,运行结果却不对。编译建议:`gcc -Wall` 严格检查。
#### goto 语句
- 无条件跳转到标签(Label)处执行
- 也能实现循环,但**不要滥用**——会严重降低代码可读性
- **不能跨函数跳转**
### Rust
学习内容:[Rust Day9 笔记](../Rust/day9)——**并发深入练习**
今天把线程相关的每个概念拆开单独练了一遍,**感觉有些理解了**。之前 Rustlings threads 是照着注释填空,知其然不知其所以然,今天分 7 步逐个跑通:
1. **`spawn` + `join`** — 最基本的线程启停,join 阻塞等待子线程结束
2. **`move`** — 所有权移入线程,理解为什么必须这样
3. **`Arc`** — 多线程共享只读数据,`Arc::clone` 只加引用计数
4. **`Arc>`** — 多线程读写同一份数据(10 线程各 +1)
5. **`mpsc::channel`** — 线程间发消息,关键细节:必须 `drop(tx)` 否则 rx 永远等不到结束
6. **死锁** — 刻意写了一个死锁:两个线程按相反顺序拿两把锁,互相等待
7. **`AtomicUsize`** — 简单计数不用锁,硬件原子指令
#### 并发选型速查
| 需求 | 方案 |
| ------------ | ------------------------ |
| 只读共享 | `Arc` |
| 读写共享 | `Arc>` |
| 线程间传数据 | `mpsc::channel` |
| 简单计数 | `AtomicUsize` |
| 启动后台任务 | `thread::spawn` + `join` |
核心认知:`Arc` 解决共享、`Mutex` 解决互斥、`channel` 解决通信——三件事分清楚之后组合起来就不神秘了。
## 明日计划
1. C 语言:循环结构作业 + 继续跟课堂
2. Rust:并发练习加入错误处理(`lock()` 返回的 `Result` 不只用 `unwrap`),有时间看看 `RwLock`]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/0/04-rust-day-9
2026-08-04T00:00:00.000Z
>` 这套绕,一个个写过去之后发现其实就是三层组合。
---
## 1. 线程基础 — spawn 与 join
### 1.1 最简单的多线程
```rust
use std::{thread, time::Duration};
fn download() {
println!("开始下载...");
thread::sleep(Duration::from_secs(3));
println!("下载完成!");
}
fn main() {
// 直接调用:主线程卡 3 秒,期间什么都干不了
// download();
// spawn:子线程后台跑,主线程继续往下
thread::spawn(|| {
download();
});
println!("界面继续运行"); // 这行先打印,不等 download
thread::spawn(|| {
println!("子线程:开始下载...");
thread::sleep(Duration::from_secs(3));
println!("子线程:下载完成!");
});
println!("界面继续运行");
thread::sleep(Duration::from_secs(5)); // 给子线程跑完的时间
}
```
**关键认知:**
| 行为 | 说明 |
| ---------------------- | -------------------------------------------- |
| `spawn` 立即返回 | 主线程不等子线程,各跑各的 |
| main 结束 → 程序退出 | 所有子线程被强制终止 |
| `thread::sleep` 等线程 | 简单粗暴但不靠谱(万一子线程需要更长时间?) |
### 1.2 join — 正确等线程的方式
```rust
let handle = thread::spawn(|| {
thread::sleep(Duration::from_secs(3));
println!("子线程:下载完成!");
});
println!("主线程:做别的事"); // 先打印
handle.join().unwrap(); // 阻塞,直到子线程跑完
println!("主线程:子线程结束了,我也结束了");
```
**执行顺序一目了然:**
```
主线程:做别的事 ← 立即
子线程:下载完成! ← 3 秒后
主线程:子线程结束了... ← join 结束后
```
| API | 作用 |
| ---------- | ------------------------------------------------------ |
| `join()` | 阻塞当前线程,等待 `JoinHandle` 对应的线程结束 |
| `unwrap()` | 子线程 panic 时 `join` 返回 `Err`,这里直接 panic 传播 |
---
## 2. move — 所有权移入线程
### 2.1 为什么必须 move
```rust
let s = String::from("hello");
// ❌ 这样写编译不过:
// thread::spawn(|| {
// println!("{}", s); // s 是局部变量,可能在线程跑完前就被释放了
// });
// ✓ move:所有权给闭包,编译器不再担心生命周期
let val = s.clone();
let handle = thread::spawn(move || {
println!("{}", val);
});
println!("{}", s); // s 还在,因为只移走了 clone 出来的 val
handle.join().unwrap();
```
**move 的决策表:**
| 主线程之后还要用 | 做法 |
| ---------------- | --------------------------------- |
| 还要用 | `clone()` 一份,`move` 移走克隆品 |
| 不用了 | 直接 `move` 移走原值 |
| 多线程共享只读 | 用 `Arc` 替代 `move` |
---
## 3. Arc — 多线程共享一份数据
### 3.1 基础用法
```rust
use std::sync::Arc;
let data = Arc::new(vec![1, 2, 3]);
let handle = thread::spawn(move || {
println!("{:?}", data);
});
handle.join().unwrap();
```
### 3.2 strong_count — 看引用计数变化
```rust
let data = Arc::new(String::from("Hello!"));
let data2 = Arc::clone(&data);
let data3 = Arc::clone(&data);
let count = Arc::strong_count(&data); // 3
let handle = thread::spawn(move || {
println!("子线程1:{:?}", data2);
println!("子线程1 内计数:{}", Arc::strong_count(&data2));
});
let handle2 = thread::spawn(move || {
println!("子线程2:{:?}", data3);
println!("子线程2 内计数:{}", Arc::strong_count(&data3));
});
println!("主线程:{}", count);
handle.join().unwrap();
handle2.join().unwrap();
```
> `Arc` 只解决了"多个线程同时拥有一份数据"。要修改,还得加 `Mutex`。
---
## 4. Arc> — 多个线程读写共享数据
### 4.1 10 线程各加 1(最经典模式)
```rust
use std::sync::{Arc, Mutex};
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let c = Arc::clone(&counter);
handles.push(thread::spawn(move || {
let mut num = c.lock().unwrap(); // 获取锁
*num += 1; // 修改
// num (MutexGuard) 在此 drop → 锁自动释放
}));
}
for h in handles {
h.join().unwrap();
}
println!("结果:{}", counter.lock().unwrap()); // 10
```
**三层组合拆解:**
```
Arc>
│ │ └── 实际数据(整数 0)
│ └────── 互斥锁:保证同一时刻只有一个人能碰数据
└────────── 引用计数:保证多线程能共同拥有这把锁
```
### 4.2 换个起始值,同样套路
```rust
let counter = Arc::new(Mutex::new(5));
let mut arr = vec![];
for _ in 0..10 {
let c = Arc::clone(&counter);
arr.push(thread::spawn(move || {
let mut num = c.lock().unwrap();
*num += 1;
}));
}
for i in arr {
i.join().unwrap();
}
println!("{:?}", counter); // Mutex { data: 15, poisoned: false, .. }
```
---
## 5. mpsc::channel — 线程间发消息
### 5.1 单发单收
```rust
use std::sync::mpsc;
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("子线程的消息");
tx.send(val).unwrap();
// val 已移入 channel,这里不能再用
});
let received = rx.recv().unwrap(); // 阻塞等待
println!("主线程收到:{}", received);
```
### 5.2 多发单收(mpsc 的本意)
```rust
let (tx, rx) = mpsc::channel();
for i in 0..5 {
let tx_clone = tx.clone();
thread::spawn(move || {
tx_clone.send(i).unwrap();
});
}
drop(tx); // ← 必须 drop 原始 tx,否则 rx 永远等不到结束
for received in rx {
println!("收到:{}", received);
}
```
> **为什么必须 `drop(tx)`?** rx 的迭代器只在所有 tx(包括克隆的)都 drop 后才返回 `None`。原始 tx 不用了却不 drop,rx 会永远阻塞。
### 5.3 10 线程发消息求和
```rust
let (sx, rx) = mpsc::channel();
for _ in 0..10 {
let sx_clone = sx.clone();
thread::spawn(move || {
sx_clone.send(1).unwrap();
});
}
drop(sx);
let mut sum = 0;
for _ in 0..10 {
sum += rx.recv().unwrap();
}
println!("{}", sum); // 10
```
---
## 6. 死锁 — 自己制造然后理解它
```rust
use std::sync::{Arc, Mutex};
use std::{thread, time::Duration};
let m1 = Arc::new(Mutex::new(0));
let m2 = Arc::new(Mutex::new(0));
// 线程 A:先拿 m1,再拿 m2
let a1 = Arc::clone(&m1);
let a2 = Arc::clone(&m2);
let h1 = thread::spawn(move || {
let _g1 = a1.lock().unwrap();
println!("A 拿到 m1");
thread::sleep(Duration::from_millis(100));
let _g2 = a2.lock().unwrap(); // 等 m2 → B 正持有 m2 → 死锁
println!("A 拿到 m2");
});
// 线程 B:先拿 m2,再拿 m1
let b1 = Arc::clone(&m1);
let b2 = Arc::clone(&m2);
let h2 = thread::spawn(move || {
let _g2 = b2.lock().unwrap();
println!("B 拿到 m2");
thread::sleep(Duration::from_millis(100));
let _g1 = b1.lock().unwrap(); // 等 m1 → A 正持有 m1 → 死锁
println!("B 拿到 m1");
});
h1.join().unwrap(); // 永远不会返回
h2.join().unwrap();
```
**死锁的本质:**
```
线程 A:持有 m1 → 等待 m2
✗ 互相等
线程 B:持有 m2 → 等待 m1
```
**避免原则:** 所有线程按相同顺序拿锁(如始终先 m1 后 m2)。
---
## 7. AtomicUsize — 简单计数不用锁
```rust
use std::sync::atomic::{AtomicUsize, Ordering};
static COUNTER: AtomicUsize = AtomicUsize::new(0);
fn main() {
let mut handles = vec![];
for _ in 0..10 {
handles.push(thread::spawn(|| {
for _ in 0..1000 {
COUNTER.fetch_add(1, Ordering::SeqCst);
}
}));
}
for h in handles {
h.join().unwrap();
}
println!("结果:{}", COUNTER.load(Ordering::SeqCst)); // 10000
}
```
| 对比 | `Mutex` | `AtomicUsize` |
| ---------- | ---------------------------- | ------------------- |
| 保护范围 | 整个临界区(多条语句) | 单个整数操作 |
| 性能 | 有锁开销 | 无锁,硬件原子指令 |
| 阻塞 | 会阻塞 | 不阻塞 |
| 使用复杂度 | 简单(lock → 改 → 自动释放) | 需要理解 `Ordering` |
> `Ordering::SeqCst` 是最严格的顺序保证,刚开始不用纠结,记住这是"最安全但最慢"的选择就行。
---
## 8. 今日总结
### 8.1 并发选型指南
| 需求 | 方案 |
| ------------ | ------------------------ |
| 只读共享 | `Arc` |
| 读写共享 | `Arc>` |
| 线程间传数据 | `mpsc::channel` |
| 简单计数 | `AtomicUsize` |
| 启动后台任务 | `thread::spawn` + `join` |
### 8.2 心态记录
之前 Rustlings 做 threads 的时候,是照着注释填空,知其然不知其所以然。今天把每个概念拆成最小单元单独跑:
1. 先玩 `spawn` + `join`(不用共享数据)
2. 再加 `move`(理解所有权)
3. 再加 `Arc`(理解多所有者)
4. 再加 `Mutex`(理解互斥)
5. 最后组合 `Arc>`
分开写清楚每个概念在解决什么问题,组合起来就不觉得神秘了。
### 8.3 明天计划
- 继续练并发,加入错误处理(`lock()` 返回的 `Result` 不只用 `unwrap`)
- `RwLock` — 多读单写,读多写少场景比 Mutex 性能更好
- 如果有时间,写一个小的多线程 demo(比如多线程下载器模拟)]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[开始学习]]>
https://kyriechao.github.io/posts/2026/08/0/03-diary
2026-08-03T13:00:00.000Z
>` 共享内存模式]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/0/03-rust-day-8
2026-08-03T00:00:00.000Z
>` —— 共享内存并发
```rust
use std::sync::{Arc, Mutex};
use std::thread;
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let c = Arc::clone(&counter);
handles.push(thread::spawn(move || {
let mut num = c.lock().unwrap();
*num += 1;
}));
}
for h in handles {
h.join().unwrap();
}
println!("{}", *counter.lock().unwrap()); // 10
```
每一步的含义:
| 步骤 | 代码 | 作用 |
| -------- | ------------------------- | ---------------------------------------------------- |
| ① 创建 | `Arc::new(Mutex::new(0))` | 把数据包在 Mutex 里,再包在 Arc 里 |
| ② 克隆 | `Arc::clone(&counter)` | 每个线程拿一份 Arc 的拷贝(引用计数 +1,不拷贝数据) |
| ③ 移入 | `move || { ... }` | 强制闭包获取 Arc 的所有权 |
| ④ 加锁 | `c.lock().unwrap()` | 获取 MutexGuard,阻塞直到拿到锁 |
| ⑤ 修改 | `*num += 1` | 解引用 MutexGuard 后修改内部数据 |
| ⑥ 等线程 | `h.join()` | 主线程等待所有子线程完成 |
### 1.3 锁中毒(Poisoning)
如果线程在持有锁时 panic,锁会"中毒"——后续 `lock()` 返回 `Err(PoisonError)`。
```rust
// 简单粗暴:中毒也 panic
*counter.lock().unwrap() += 1;
// 更稳健:中毒后仍能恢复数据
match counter.lock() {
Ok(mut guard) => *guard += 1,
Err(poisoned) => *poisoned.into_inner() += 1,
}
```
### 1.4 其他并发原语速览
| 原语 | 一句话 | 类比 |
| ---------------------- | -------------------------------- | ------------------------------- |
| `RwLock` | 多读单写锁 | 读写锁,读不互斥、写互斥 |
| `Barrier` | 多个线程在某个点汇合 | 等人齐了一起走 |
| `Condvar` | 条件变量,配合 Mutex 做等待/通知 | `while !ready { wait() }` |
| `OnceLock` | 只写入一次、之后只读的单值容器 | 线程安全的 lazy static |
| `AtomicBool/I32/Usize` | 无锁原子操作 | 简单的计数器/标志位不需要 Mutex |
> 先熟练掌握 `channel` 和 `Arc>` 两个模式,够覆盖 80% 的并发场景。其余用到时再查。
---
## 二、Trait —— 共享行为的抽象
### 2.1 基本语法
```rust
// 定义 trait
trait Summary {
fn summarize(&self) -> String;
// 默认实现
fn summarize_author(&self) -> String {
String::from("(未知作者)")
}
}
// 为类型实现 trait
struct Article {
title: String,
author: String,
content: String,
}
impl Summary for Article {
fn summarize(&self) -> String {
format!("{} —— {}", self.title, self.author)
}
}
// 调用
let a = Article { ... };
println!("{}", a.summarize());
```
> `impl Trait for Type` —— trait 和类型至少有一个必须在本 crate 中定义(**孤儿规则**)。你不能为外部类型实现外部 trait。
### 2.2 Trait 作为参数
```rust
// 写法一:impl Trait 语法糖
fn notify(item: &impl Summary) {
println!("{}", item.summarize());
}
// 写法二:trait bound(等价,更显式)
fn notify(item: &T) {
println!("{}", item.summarize());
}
// 多个 trait bound
fn notify(item: &T) { ... }
// where 子句(参数多、约束多时更可读)
fn some_function(t: &T, u: &U) -> i32
where
T: Display + Clone,
U: Clone + Debug,
{ ... }
```
### 2.3 返回实现了 Trait 的类型
```rust
fn returns_summarizable() -> impl Summary {
Article { ... }
}
```
> `impl Trait` 作返回类型时,函数只能返回**同一种类型**。不能在某些分支返回 `Article`、另一些分支返回 `Tweet`。
### 2.4 常用标准库 Trait
| Trait | 用途 | 获取方式 |
| --------------- | ---------------------- | -------------------------------- |
| `Debug` | 调试打印 `{:?}` | `#[derive(Debug)]` |
| `Clone` | 显式深拷贝 `.clone()` | `#[derive(Clone)]` |
| `Copy` | 隐式按位拷贝(栈数据) | `#[derive(Copy, Clone)]` |
| `PartialEq` | 相等比较 `==` `!=` | `#[derive(PartialEq)]` |
| `Default` | 默认值 | `#[derive(Default)]` |
| `Display` | 面向用户的格式化 `{}` | **手动实现** |
| `Drop` | 离开作用域时执行的清理 | 手动实现 `fn drop(&mut self)` |
| `From` / `Into` | 类型转换 | 手动实现 `From`,`Into` 自动获得 |
| `Iterator` | 迭代器 | 手动实现 `fn next(&mut self)` |
### 2.5 练习——写一个自定义 trait
试着不用 `#[derive]`,手动为你的 `Rectangle` 实现 `PartialEq` 和 `Display`:
```rust
struct Rectangle {
width: u32,
height: u32,
}
// 手动实现 PartialEq
impl PartialEq for Rectangle {
fn eq(&self, other: &Self) -> bool {
self.width == other.width && self.height == other.height
}
}
// 手动实现 Display
impl std::fmt::Display for Rectangle {
fn fmt(&self, f: &mut std::fmt::Formatter) -> std::fmt::Result {
write!(f, "Rectangle({} x {})", self.width, self.height)
}
}
```
---
## 三、今日练习清单
| # | 练习 | 重点 |
| ---- | ------------------------------------------------------------ | ------------------ |
| 1 | 用 `mpsc::channel` 实现:3 个线程各产生 10 个随机数,汇总到主线程求平均值 | channel 消息传递 |
| 2 | 用 `Arc>` 实现:5 个线程同时对同一个 `Vec` 追加元素,最后打印完整列表 | 共享内存 + 锁 |
| 3 | 不用 channel、不用共享内存,只用 `thread::spawn` + `join` 实现:4 个线程各自计算,最后汇总 | 多线程返回值 |
| 4 | 为你的 `Rectangle` 手动实现 `PartialEq`、`Display`、`From<(u32, u32)>` | Trait 实现套路 |
| 5 | 写一个函数 `largest(list: &[T]) -> &T`,找出切片中最大元素的引用 | 泛型 + trait bound |
---
## 四、Day 8 检查点
- [ ] 能用 `channel` 在多线程间传递消息
- [ ] 能用 `Arc>` 安全共享可变数据
- [ ] 理解锁中毒的机制和处理方式
- [ ] 能写出带 trait bound 的泛型函数
- [ ] 能手写 `impl Display for Xxx`(不用 derive)
- [ ] 理解孤儿规则的限制
---
## 五、如果还有时间——再看一眼生命周期
之前 `longest` 能写对,但复杂场景还是会卡。试一下这个结构体标注:
```rust
struct Excerpt<'a> {
part: &'a str, // 要求:Excerpt 实例不能比它引用的 str 活得更久
}
impl<'a> Excerpt<'a> {
// 省略规则自动处理,无需显式标注
fn announce(&self, msg: &str) -> &str {
println!("{}", msg);
self.part
}
}
```
规则回顾——三个省略规则,当编译器能自动推断时就不用写:
1. 每个引用参数都有各自的生命周期
2. 只有一个输入生命周期 → 赋予所有输出
3. `&self` / `&mut self` → self 的生命周期赋予所有输出
只有当三条规则都不满足时,才需要手动标注。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[周六放松]]>
https://kyriechao.github.io/posts/2026/08/0/01-diary
2026-08-01T13:00:00.000Z
b ?不,-1 被转成无符号后变成一个极大的正数(UINT_MAX),所以 a > b
```
> 这是 C 语言里一个常见的坑:有符号和无符号混用时,结果往往违反直觉。
**3. 浮点与整型混用**
等级排序:`long double` > `double` > `float` > 整型(`long long` > `long` > `int` > `short` > `char`)
规则:
- **等级低的向等级高的转**
- 同等级整数内,**无符号吃掉有符号**
```c
int i = 5;
double d = 3.14;
// i + d → i 先转为 double,结果为 double 类型
int si = -10;
unsigned int ui = 5;
// si + ui → si 先转为 unsigned int,结果可能很大
```
### Rust
今天完成了 Rustlings 全部练习,看到 Congratulations 的 Finish line。
具体内容记录在 [Rust Day7 笔记](01-rust-day7.md),要点:
- **生命周期标注**:手写了带生命周期的 `Book<'a>` 结构体及 `impl` 块,能写 `longer_title` 这类多引用返回的方法
- **闭包**:`Fn` / `FnMut` / `FnOnce` 三个 trait 的区别和适用场景
- **迭代器**:`filter` + `map` + `collect` 链式调用、`fold`、`zip`、`next`
- **智能指针**:`Box`(递归类型)、`Rc`(共享所有权)、`RefCell`(内部可变性)、`Arc`(多线程共享)
- **并发**:`Arc>` 模式、`thread::spawn` + `join`、`mpsc::channel` 消息传递
- **宏**:声明宏基础语法(`macro_rules!`),四种宏类型对比
- **Clippy**:常用 lint 规则和处理方式
- **类型转换**:`From` / `TryFrom` / `FromStr` / `AsRef` 的实现套路
能力自评:所有权/借用基本内化,迭代器方法库是目前的短板,过程宏还没碰。
## 思考
(今天没有特别的思考内容)
## 明日计划
1. 继续 Rust 后续课程(Trait / 泛型约束深入,如果课程还没到则自己看 Rust Book §10)
2. 精读 Iterator trait 文档,扩充迭代器方法储备]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/08/0/01-rust-day7
2026-08-01T00:00:00.000Z
),
Nil,
}
impl List {
fn len(&self) -> i32 {
match self {
List::Cons(_, next) => 1 + next.len(),
List::Nil => 0,
}
}
}
struct Book<'a> {
title: &'a str,
author: &'a str,
}
impl<'a> Book<'a> {
fn get_title(&self) -> &str {
self.title
}
fn longer_title<'b>(&self, other: &'a str) -> &'a str {
if self.title.len() > other.len() {
self.title
} else {
other
}
}
}
```
**生命周期知识点:**
| 概念 | 说明 |
| ------------------- | ------------------------------------------------------------ |
| `'a` 语法 | 生命周期参数,标注引用"活多久"。`&'a str` 表示这个引用的有效期至少为 `'a` |
| struct 中的生命周期 | 当 struct 持有引用时,必须标注生命周期:编译器需要保证 struct 实例活得比引用短 |
| impl 中的生命周期 | `impl<'a> Book<'a>` — 在 impl 后声明泛型生命周期,在类型后使用 |
| 省略规则 | `fn get_title(&self) -> &str` 编译器能自动推断,不用显式写 |
| 多引用返回 | `longer_title` 返回的引用可能来自 `self.title` 或 `other`,生命期标注告诉编译器"返回值的生命周期等于较短的那个" |
> **核心直觉:** 生命周期标注不改变代码逻辑,只是在给编译器"画约束线"——"这个引用不能比那个引用活得久"。标注完后编译器帮你检查是否违反了约束。
### 1.2 闭包(Closures)
```rust
fn main() {
// 不可变借用 —— 实现 Fn
let base = 10;
let add_base = |n| base + n;
println!("{}", add_base(5)); // 15
// 可变借用 —— 实现 FnMut
let mut count = 0;
let mut counter = || {
count += 1;
count
};
println!("{}", counter()); // 1
println!("{}", counter()); // 2
// 闭包作为参数 —— Fn trait bound
fn apply_twice(f: F, n: i32) -> i32
where
F: Fn(i32) -> i32,
{
f(f(n))
}
println!("{}", apply_twice(|n| n * 2, 5)); // 20
}
```
| trait | 调用方式 | 捕获方式 | 能多次调用 |
| -------- | ----------- | ---------- | ------------- |
| `Fn` | `&self` | 不可变借用 | ✓ |
| `FnMut` | `&mut self` | 可变借用 | ✓ |
| `FnOnce` | `self` | 转移所有权 | ✗(只能一次) |
### 1.3 迭代器(Iterators)
```rust
let nums = vec![1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
// filter + map + collect
let result: Vec = nums
.iter()
.filter(|&&x| x % 2 == 0)
.map(|&x| x * 3)
.collect();
println!("{:?}", result); // [6, 12, 18, 24, 30]
// fold 累积
let product = nums.iter().fold(1, |acc, &x| acc * x);
println!("{}", product); // 3628800
// zip 并行迭代
let names = vec!["Tom", "Jerry", "Spike"];
let scores = vec![80, 95, 60];
for (name, score) in names.iter().zip(scores.iter()) {
println!("{}:{}", name, score);
}
// 链式查找:第一个大于5的偶数,乘2
let first = nums
.iter()
.filter(|&&x| x % 2 == 0 && x > 5)
.map(|&o| o * 2)
.next()
.unwrap_or(0);
println!("{}", first); // 12
```
### 1.4 智能指针(Smart Pointers)
```rust
use std::{
cell::RefCell,
rc::Rc,
};
// Rc> — 共享所有权
let v = Rc::new(vec![1, 2, 3]);
let v2 = Rc::clone(&v);
let v3 = Rc::clone(&v);
println!("{}", Rc::strong_count(&v)); // 3
// Rc> — 共享 + 内部可变
let num = Rc::new(RefCell::new(5));
let num2 = Rc::clone(&num);
*num.borrow_mut() += 1; // 5 + 1 = 6
*num2.borrow_mut() *= 2; // 6 * 2 = 12
println!("{}", num.borrow()); // 12
// Box 实现递归链表
#[derive(Debug)]
enum List {
Cons(i32, Box),
Nil,
}
let list = Box::new(List::Cons(
1,
Box::new(List::Cons(2, Box::new(List::Cons(3, Box::new(List::Nil))))),
));
println!("{}", list.len()); // 3
```
**三种智能指针对比:**
| 智能指针 | 用途 | 线程安全 | 等价于 |
| ------------ | ---------------- | -------- | ------------------------- |
| `Box` | 堆分配,递归类型 | — | C 的 `malloc`(自动释放) |
| `Rc` | 单线程共享所有权 | ❌ | 非原子的引用计数 |
| `Arc` | 多线程共享所有权 | ✓ | 原子的引用计数 |
| `RefCell` | 运行时借用检查 | ❌ | 编译期检查的"后门" |
| `Mutex` | 多线程互斥访问 | ✓ | 互斥锁 |
| `Cow` | 写时克隆 | — | 懒克隆优化 |
### 1.5 并发(Concurrency)
```rust
use std::{
sync::{Arc, Mutex},
thread,
};
// 10 个线程共享一个计数器,每个 +1
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let c = Arc::clone(&counter);
handles.push(thread::spawn(move || {
*c.lock().unwrap() += 1;
}));
}
for h in handles {
h.join().unwrap();
}
println!("{:?}", counter.lock().unwrap()); // 10
```
**并发三板斧:**
```
Arc>
│ └── 互斥锁:保证同一时刻只有一个线程能修改数据
└────── 原子引用计数:保证多线程共享所有权(Rc 不行!)
```
| 组件 | 作用 |
| --------------- | ------------------------------------------------------- |
| `thread::spawn` | 创建新线程,返回 `JoinHandle` |
| `move` 闭包 | 强制把外部变量所有权移入线程闭包 |
| `Arc::clone` | 给每个线程一份"共享指针的副本"(不拷贝数据) |
| `Mutex::lock()` | 获取锁,返回 `LockResult>` |
| `unwrap()` | 简化错误处理——若其他线程 panic 导致锁中毒,这里也 panic |
| `join()` | 主线程等待子线程完成 |
---
## 2. Rustlings 19~23 练习总结
### 2.1 19_smart_pointers — 智能指针
| 练习题 | 涉及内容 | 关键收获 |
| --------- | --------------------- | ------------------------------------------------------------ |
| `box1.rs` | `Box` 解决递归类型 | Rust 需要在编译期知道类型大小,`Box` 把递归部分放堆上,因为是固定大小的指针 |
| `rc1.rs` | `Rc` 共享所有权 | 太阳系模型:一颗 Sun,8 颗行星通过 `Rc::clone` 共享太阳。`strong_count` 增减可视化 |
| `arc1.rs` | `Arc` 多线程共享 | `Rc` 不实现 `Send`,多线程必须用 `Arc`。8 个线程各持有 `Arc::clone` |
| `cow1.rs` | `Cow` 写时克隆 | `Cow::Borrowed` 不拷贝;`to_mut()` 触发克隆变 `Cow::Owned`。只有需要修改才拷贝 |
### 2.2 20_threads — 线程
| 练习题 | 涉及内容 | 关键收获 |
| ------------- | ------------------------ | ------------------------------------------------------------ |
| `threads1.rs` | `thread::spawn` + `join` | `JoinHandle.join().unwrap()` 等待线程结束并取返回值 |
| `threads2.rs` | `Arc>` | `lock().unwrap()` 获取 `MutexGuard`,解引用后修改。离开作用域自动释放锁 |
| `threads3.rs` | `mpsc::channel` | 消息传递并发。多生产者单消费者:`tx.clone()` 克隆发送端,`rx` 收所有消息 |
> **为什么需要 Mutex?** 如果多个线程直接 `+=1`,会有数据竞争(data race)——读-改-写不是原子操作。Mutex 保证"锁住 → 修改 → 释放"这个序列是互斥的。
### 2.3 21_macros — 宏
| 练习题 | 涉及内容 | 关键收获 |
| ------------ | ----------------- | ------------------------------------------------------------ |
| `macros1.rs` | 宏调用语法 | `my_macro!()` — 声明宏调用必须加 `!` |
| `macros2.rs` | 宏定义顺序 | 宏必须在调用**之前**定义(与函数不同) |
| `macros3.rs` | `#[macro_export]` | 模块内的宏默认私有,加 `#[macro_export]` 导出到 crate root |
| `macros4.rs` | 宏重载 | 同一个宏名可定义多个匹配分支:无参 `()` 和带参 `($val:expr)` |
**声明宏基础语法:**
```rust
macro_rules! 宏名 {
(模式1) => { 展开1 };
(模式2) => { 展开2 };
}
// 模式中常用设计符:
// $var:expr — 表达式
// $var:ty — 类型
// $var:ident — 标识符
// $var:literal — 字面量
// $var:tt — 单个 token tree(最通用)
```
> 说实话 macros 这四道题太简单了,只碰了声明宏的皮毛。过程宏(`#[proc_macro]`)、`#[derive]` 宏、属性宏才是真正强大的部分,但 Rustlings 没涉及。
### 2.4 22_clippy — 代码规范 Lint
| 练习题 | Clippy 规则 | 修正方法 |
| ------------ | ---------------------- | ------------------------------------------------------------ |
| `clippy1.rs` | `approx_constant` | `3.14` → `std::f32::consts::PI` |
| `clippy2.rs` | `if_let` 替代 `unwrap` | `option.unwrap()` → `if let Some(x) = option { ... }` |
| `clippy3.rs` | 多个 lint 综合 | `if let` 替代 `unwrap`;`swap` 替代手动交换;`vec.resize` 替代 `vec![..].resize(0,..)` 等 |
**常用 Clippy 规则速查:**
| Lint 名 | 检测内容 |
| ------------------------- | ------------------------------------------------------------ |
| `clippy::unwrap_used` | 禁止 `unwrap()`(生产代码推荐用 `?` 或 `expect`) |
| `clippy::needless_return` | 函数末尾多余的 `return` |
| `clippy::if_let` | 能用 `if let` 的地方不要 `match` 单分支 |
| `clippy::approx_constant` | 硬编码的数学常量(如 `3.14` 应替换为 `std::f32::consts::PI`) |
| `clippy::manual_swap` | 手动三行交换两个变量,应用 `std::mem::swap` |
> Clippy 就像 Rust 的"代码规范老师"——它不光告诉你哪里不对,还告诉你为什么以及怎么改。生产项目建议配 `cargo clippy -- -D warnings`,把所有警告当错误处理。
### 2.5 23_conversions — 类型转换
| 练习题 | 涉及 trait | 关键收获 |
| ------------------ | --------------------- | ------------------------------------------------------------ |
| `using_as.rs` | `as` 关键字 | `values.len() as f64` — `as` 做基本类型转换。注意:`as` 不检查溢出 |
| `from_into.rs` | `From` + `Into` | 实现 `From<&str> for Person`,`Into` 自动获得。失败时 fallback 到 `Default` |
| `from_str.rs` | `FromStr` | 与 `From` 不同:返回 `Result`,失败带错误信息。实现后可直接 `.parse::()` |
| `try_from_into.rs` | `TryFrom` + `TryInto` | 可能失败的转换。实现了 tuple、数组、slice 三种输入版本的 `TryFrom` |
| `as_ref_mut.rs` | `AsRef` + `AsMut` | `AsRef` 让函数同时接受 `&str` 和 `String`。`AsMut` 同理用于可变引用 |
**转换 trait 选择指南:**
```
值到值的转换:
┌─ 不会失败 ──→ 实现 From
└─ 可能失败 ──→ 实现 TryFrom(自动得 TryInto)
字符串解析:
└── 可能失败 ──→ 实现 FromStr(自动得 .parse())
引用到引用的转换(零成本):
└── 实现 AsRef / AsMut
简单数值转换(不检查):
└── 用 as 关键字
```
> 老实说 conversions 这几题主要就是反复练习 trait 实现的套路,没有特别新的概念。`FromStr` vs `From` 的区别值得记住:一个返回 `Result`,一个返回 `Self`。
---
## 3. 薄弱环节深入
### 3.1 线程与并发 — 补充理解
**`Arc>` 模式的工作流程:**
```rust
use std::sync::{Arc, Mutex};
use std::thread;
let data = Arc::new(Mutex::new(0)); // ① 创建共享数据
let data_clone = Arc::clone(&data); // ② 克隆 Arc(引用计数 +1)
thread::spawn(move || { // ③ move 移入闭包
let mut guard = data_clone.lock().unwrap(); // ④ 获取锁
*guard += 1; // ⑤ 修改数据
}); // ⑥ guard drop → 自动释放锁
```
**Mutex 锁中毒(Poisoning):**
```rust
// 如果一个线程在持有锁时 panic,锁会"中毒"
// lock() 的返回值是 LockResult>
// 中毒时 lock() 返回 Err(PoisonError)
// 简单处理:unwrap() — 中毒也 panic
*counter.lock().unwrap() += 1;
// 更安全的处理:
match counter.lock() {
Ok(mut guard) => *guard += 1,
Err(poisoned) => {
// 锁已中毒,但仍可通过 into_inner() 恢复数据
*poisoned.into_inner() += 1;
}
}
```
**`mpsc::channel`(消息传递并发):**
```rust
use std::sync::mpsc;
use std::thread;
let (tx, rx) = mpsc::channel(); // tx = 发送端, rx = 接收端
let tx1 = tx.clone(); // 多个发送者
thread::spawn(move || {
tx1.send("来自线程1").unwrap(); // 发送消息
});
let tx2 = tx.clone();
thread::spawn(move || {
tx2.send("来自线程2").unwrap();
});
drop(tx); // 原始 tx 也要 drop,否则 rx 会永远等待
for msg in rx { // rx 作为迭代器,直到所有 tx 都 drop
println!("{}", msg);
}
```
> **Go 的哲学是"用通信来共享内存"**,Rust 同时支持两种范式:channel(消息传递)和 `Arc>`(共享内存)。Mutex 更直观但容易死锁,channel 更安全但有时不方便。
### 3.2 Rc + RefCell 的内部原理
```rust
use std::{cell::RefCell, rc::Rc};
// Rc 解决 "谁拥有这块数据" — 引用计数
// RefCell 解决 "不可变引用下怎么修改" — 运行时借用检查
let shared = Rc::new(RefCell::new(vec![1, 2, 3]));
{
let mut v = shared.borrow_mut(); // 运行时检查:有没有其他借用?
v.push(4); // 可变借用,修改数据
} // v drop → 可变借用释放
let v2 = shared.borrow(); // 不可变借用,读取数据
println!("{:?}", v2); // [1, 2, 3, 4]
```
**RefCell 的运行时检查规则(与编译期规则完全对应):**
| 操作 | 成功条件 | 失败结果 |
| -------------- | ------------------------------ | -------- |
| `borrow()` | 当前没有 `borrow_mut()` 持有中 | `panic!` |
| `borrow_mut()` | 当前没有任何 borrow(读或写) | `panic!` |
> **为什么需要 RefCell?** 编译期借用检查是保守的——有时你明知逻辑上安全,但编译器不买账。RefCell 把检查推迟到运行时,给你更大的灵活性,代价是写错会 panic 而不是编译报错。
### 3.3 宏 — 声明宏进阶
Rustlings 教到的最远的地方是多分支宏。补充几个实际场景:
```rust
// vec! 宏的实际实现思路(简化版)
macro_rules! my_vec {
() => { Vec::new() };
($elem:expr; $n:expr) => { // vec![0; 10] → 10 个 0
std::vec::from_elem($elem, $n)
};
($($x:expr),+ $(,)?) => { // vec![1, 2, 3] → 可变参数
{
let mut v = Vec::new();
$(v.push($x);)+
v
}
};
}
// 重复模式语法:
// $($var:expr),* — 零个或多个,逗号分隔
// $($var:expr),+ — 一个或多个,逗号分隔
// $(,)? — 可选的尾随逗号
```
四种宏类型的对比:
| 宏类型 | 定义方式 | 使用方式 | 典型场景 |
| -------- | ------------------------- | ------------------ | ------------------ |
| 声明宏 | `macro_rules!` | `macro!()` | `println!`、`vec!` |
| 派生宏 | `#[proc_macro_derive]` | `#[derive(Debug)]` | 自动实现 trait |
| 属性宏 | `#[proc_macro_attribute]` | `#[route("GET")]` | 代码标注/转换 |
| 函数式宏 | `#[proc_macro]` | `sql!(SELECT ...)` | 自定义语法 |
> Rustlings 只教了声明宏的入门,剩下三种过程宏需要单独深入。
---
## 4. Rustlings 全阶段学习反思
### 4.1 能力自评
| 知识模块 | 自评 | 说明 |
| ---------------------------- | ------------ | ------------------------------------------------------------ |
| 所有权 / 借用 / 生命周期 | 基本会用 | 生命周期标注遇到复杂场景还是会卡 |
| 枚举 / 模式匹配 | 熟练 | `match`、`if let`、`Option`/`Result` 操作顺手 |
| Vec / String / HashMap | 会用 | 常用方法熟悉,Entry API 是亮点 |
| 闭包 | 基本会用 | `Fn`/`FnMut`/`FnOnce` 区别理解,但写 trait bound 时偶尔会忘 |
| 迭代器 | 会用但不熟 | 上百个方法只记住了常用的十几个,遇到新需求经常想不出该用哪个 |
| `Box` / `Rc` / `RefCell` | 会用 | 知道各自用途和限制,组合使用没问题 |
| `Arc` / `Mutex` / 线程 | 了解 | 能写简单多线程程序,但并发模式的积累不够 |
| `From` / `TryFrom` / `AsRef` | 会用 | 懂了套路,缺的是多练 |
| 宏 | 能读懂不会写 | 声明宏基础语法会了,过程宏还没碰 |
| 错误处理 | 会用 | `Result` + `?` 很顺手,自定义错误类型也练过 |
| 测试 | 会用 | `#[test]` + `assert_eq!` 基础够用 |
### 4.2 下一步学习方向
1. **迭代器方法库**:精读 Iterator trait 文档,记住 20~30 个常用方法
2. **并发深入**:`mpsc`、`RwLock`、`Barrier`、`Condvar`、`OnceLock` 等更多并发原语
3. **过程宏**:尝试写一个 `#[derive]` 宏,理解 `syn` + `quote` 工作流
4. **生命周期实战**:多写几个需要显式标注生命周期签名的复杂 struct/fn
5. **实际项目**:用 Rust 写一个小项目(CLI 工具或嵌入式驱动),把碎片知识串起来
---
## 5. Rustlings 全部章节对照表
| 练习 | 《Rust Book》章节 | 完成 |
| --------------- | ----------------- | ---- |
| variables | §3.1 | ✓ |
| functions | §3.3 | ✓ |
| if | §3.5 | ✓ |
| primitive_types | §3.2, §4.3 | ✓ |
| vecs | §8.1 | ✓ |
| move_semantics | §4.1-2 | ✓ |
| structs | §5.1, §5.3 | ✓ |
| enums | §6, §18.3 | ✓ |
| strings | §8.2 | ✓ |
| modules | §7 | ✓ |
| hashmaps | §8.3 | ✓ |
| options | §10.1 | ✓ |
| error_handling | §9 | ✓ |
| generics | §10 | ✓ |
| traits | §10.2 | ✓ |
| lifetimes | §10.3 | ✓ |
| tests | §11.1 | ✓ |
| iterators | §13.2-4 | ✓ |
| smart_pointers | §15, §16.3 | ✓ |
| threads | §16.1-3 | ✓ |
| macros | §20.5 | ✓ |
| clippy | Appendix D | ✓ |
| conversions | n/a | ✓ |
---
## 6. 备忘
- `as` 转换不检查溢出,生产代码中跨类型窄化转换建议用 `TryFrom` 或用 `.try_into()` 后处理 `Result`
- `Rc` 不能跨线程(不实现 `Send`),改用 `Arc`;`RefCell` 也不能跨线程(不实现 `Sync`),改用 `Mutex` 或 `RwLock`
- `Mutex::lock()` 会阻塞当前线程直到获取锁;`try_lock()` 不阻塞,获取不到马上返回 `Err`
- Clippy 默认只 warn,配 `-D warnings` 才能让 lint 阻止编译]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[运算符与迭代器收尾]]>
https://kyriechao.github.io/posts/2026/07/31-diary
2026-07-31T13:00:00.000Z
>`)—
清零、置一、翻转、移位,以及用掩码操作指定位的经典写法。关键口诀:`n &= ~(0x1 << 17)` 清零第 17
位,`n |= 1 << 9` 把第 9 位置一。
- **运算符优先级** — "独眼龙比两只眼的正常人更狠"(单目 > 双目),"算比位逻"(算术 > 比较 > 位 >
逻辑),三目倒数第三,赋值倒数第二,逗号最低。
- **类型转换** — 自动提升(`char → int → long → float → double`)、强制转型语法
`(Type)expr`、宽转窄截断、浮点转整数直接去尾。
### Rust
Rustlings iterators 部分全部做完,笔记见 [Rust/day6.md](30-rust-day5.md)。今天每道题都卡了很久,暴露出
来的问题不是语法,而是**不知道标准库有哪些方法可用**:
- `capitalize_first` — `chars()` + `as_str()` 分割首字母和余下部分
- `(1..=num).product()` — 阶乘一行搞定,卡最久的一个
- `flat_map` — 拍平嵌套迭代器(`&[HashMap<_,_>]` → 一条流)
- `collect()` — 会根据返回值类型自动判断收集成 `Vec`、`String` 还是别的
`map_err` 和 `ok()` + `?` 的配合用法也比昨天熟练了。
## 思考
**核心观点:人并非自主的主体,而是欲望驱动下的被动响应机器。**
---
### 一、什么是"空壳"
"空壳"在这里指:人没有所谓"自主的意志"。你的每一个行动,背后都站着一种欲望。没有欲望作为燃料,人这台机器就不会运转。
---
### 二、两个论据
#### 论据一:食欲——披着生存外衣的欲望
饿的时候,你会为了一口吃的拼命。人们认为这理所当然,因为底层逻辑是"为了生存"。
但换个角度看:你并不是在"选择"进食,你是在被饥饿感**驱使**着进食。你的行为只是一个生理信号的自动响应。
#### 论据二:性欲——剥离生存借口后的纯粹欲望
性欲与生存无关(个体不交配并不会死)。
但当它出现时,人同样会倾尽所有去满足。这说明驱动力不是"生存的必要性",而是**欲望的强度本身**。
> 两个论据的共同结论:人的行为不是理性的自主选择,而是被欲望强度决定的。
---
### 三、为什么"安逸"是关键证据
如果人是自主的,那在安逸的环境中,人应该照样行动。
但事实相反:
安逸 → 懒惰 → 停滞
痛苦 → 欲望 → 行动
人只有在**不舒服**的时候才会动。行动的目的永远指向**消除不舒服**、制造安逸。
这说明:驱动源是负面的(痛苦/欲望),不是正面的(意志/理想)。人的行为是被"推着走",不是"朝着目标走"。
---
### 四、核心模型:欲望循环
```text
欲望无法被满足
│
▼
痛苦(张力状态)
│
▼
改变(行动)
│
▼
满足(欲望被填补)
│
▼
欲望感知度降低(阈值升高)
│
▼
满足度下降
│
▼
痛苦(新的张力)
│
▼
改变 → 满足 → 阈值升高 → ...
```
> 这个循环没有终点。每一次满足都在抬高下一次满足的门槛。
---
### 五、类比:机器
| | 机器 | 人 |
|---|------|-----|
| 能量耗尽 | 停止运转 | — |
| 欲望消失 | — | 停止行动 |
| 加燃料 | 重新运转 | — |
| 新欲望产生 | — | 重新行动 |
| 停止条件 | 零件损坏 | 死亡 |
机器因为燃料耗尽而停,因为加油而动。
人因为欲望满足而停,因为新欲望产生而动。
唯一的停止方式:机器坏掉,或者人死掉。
---
### 六、结论
人没有"想不想被驱动"的选择权——欲望产生的那一刻,驱动就已经发生了。
所谓 **"自由意志"** ,可能只是我们在事后给自己编的理由。
---
## 明日计划
- C 语言:继续跟课堂节奏
- Rust:推进到 smart_pointers
---]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/07/31-rust-day6
2026-07-31T00:00:00.000Z
Rustlings iterators 部分全部做完。今天的题每一道都卡了很久,挫败感很强,但回头看也暴露了知识盲区——不知道某些函数的存在,就不可能想出对应的解法。
---
## 一、首字母大写 — `chars()` 迭代器
```rust
// "hello" -> "Hello"
fn capitalize_first(input: &str) -> String {
let mut ch = input.chars();
match ch.next() {
Some(c) => c.to_uppercase().to_string() + ch.as_str(),
None => String::from(""),
}
}
```
**拆解:**
1. `input.chars()` — 返回字符串的**字符迭代器**,不是字节迭代器
2. `ch.next()` — 消费第一个字符,剩余字符还在 `ch` 里
3. `c.to_uppercase()` — 返回一个 `Uppercase` 迭代器(因为有些字符大写后不止一个字符,如 ß → SS),用 `to_string()` 收成 `String`
4. `ch.as_str()` — 把迭代器剩余部分直接当 `&str` 取出来
5. 拼接 → 首字母大写完成
### 对切片批量应用 — `map` + `collect`
```rust
// ["hello", "world"] -> ["Hello", "World"]
fn capitalize_words_vector(words: &[&str]) -> Vec {
words
.iter()
.map(|n| {
let mut s = n.chars();
match s.next() {
Some(k) => k.to_uppercase().to_string() + s.as_str(),
None => String::from(""),
}
})
.collect()
}
// ["hello", " ", "world"] -> "Hello World"
fn capitalize_words_string(words: &[&str]) -> String {
words
.iter()
.map(|s| {
let mut chars = s.chars();
match chars.next() {
None => String::new(),
Some(f) => f.to_uppercase().to_string() + chars.as_str(),
}
})
.collect()
}
```
> **关键收获:`collect()` 会根据返回类型自动判断收集成什么。** 同样一串 `map` 链,返回值写 `Vec` 就收集成 Vec,写 `String` 就收集成拼接字符串——因为 `String` 也实现了 `FromIterator`。
### `collect()` 类型推断机制
```rust
// 同一个迭代器链,collect 出不同结果:
let v: Vec = words.iter().map(...).collect(); // 返回 Vec
let s: String = words.iter().map(...).collect(); // 返回 String(拼接)
```
| 目标类型 | collect 行为 |
| ------------------- | -------------------------- |
| `Vec` | 每个 `String` push 进 Vec |
| `String` | 把所有 `String` 拼接成一个 |
| `HashMap<_, _>` | 收集键值对 |
| `Result, _>` | 遇到第一个 Err 就停 |
> 编译器通过函数签名里的返回类型倒推 `collect` 该生成什么——这就是 Rust 的类型推断从返回值"反向传播"的能力。
---
## 二、`divide` — 自定义错误枚举
```rust
enum DivisionError {
DivideByZero, // 42 / 0
IntegerOverflow, // i64::MIN / -1 → 结果超出 i64::MAX
NotDivisible, // 5 / 2 = 2.5 不能整除
}
fn divide(a: i64, b: i64) -> Result {
if b == 0 {
Err(DivisionError::DivideByZero)
} else if a == i64::MIN && b == -1 {
Err(DivisionError::IntegerOverflow)
} else if a % b == 0 {
Ok(a / b)
} else {
Err(DivisionError::NotDivisible)
}
}
```
> `i64::MIN / -1` 会溢出,因为 `i64::MIN = -9223372036854775808`,取绝对值后比 `i64::MAX` 大 1,这是有符号整数的经典陷阱。
### 2.1 `ok()` + `?` — Result 转 Option 并短路
```rust
// 期望输出: Ok([1, 11, 1426, 3])
fn result_with_list() -> Option> {
let numbers = [27, 297, 38502, 81];
let mut vec = Vec::new();
for &n in &numbers {
let v = divide(n, 27).ok()? as i32; // Result → Option,Err 时 ? 短路
vec.push(v);
}
Some(vec)
}
```
**`ok()` 做了什么:**
```rust
Result::Ok(v) --ok()--> Some(v)
Result::Err(e) --ok()--> None // 错误信息直接丢弃
```
> 然后 `?` 在 `Option` 上下文中:遇到 `None` 直接 return `None`。一行代码把两件事都干了。
### 2.2 `map` + `map_err` — 保留错误但不中断
```rust
// 期望输出: [Ok(1), Ok(11), Ok(1426), Ok(3)]
fn list_of_results() -> Vec> {
let numbers = [27, 297, 38502, 81];
numbers
.into_iter()
.map(|n| {
divide(n, 27)
.map(|v| v as i32) // Ok 分支:类型转换
.map_err(|_| "division error") // Err 分支:换一个错误信息
})
.collect()
}
```
| 方法 | 作用 |
| --------- | -------------------------------- |
| `map` | 只碰 `Ok` 里的值,`Err` 原样透传 |
| `map_err` | 只碰 `Err` 里的值,`Ok` 原样透传 |
| `ok()` | `Result` → `Option`,丢弃错误 |
---
## 三、`(1..=num).product()` — 阶乘一行版
```rust
fn factorial(num: u64) -> u64 {
(1..=num).product()
}
```
> 这道题卡了最久。知道阶乘就是 `1 * 2 * 3 * … * n`,脑子里想的都是递归或 `fold`,完全不知道标准库自带 `product()`。一行解决后整个人愣住了。
`product()` 对迭代器做连乘——类似 `sum()` 做连加。只用范围和方法调用,没有显式循环、没有中间变量、没有递归。
---
## 四、`filter` + `count` — 统计满足条件的元素
```rust
#[derive(PartialEq)] // 需要 PartialEq 才能用 == 比较
enum Progress {
None,
Some,
Complete,
}
fn count_iterator(map: &HashMap, value: Progress) -> usize {
map.values().filter(|&v| *v == value).count()
}
```
原来 for 循环版 5 行,迭代器版 1 行:`filter` 筛出匹配的,`count` 计数。
---
## 五、`flat_map` — 拍平嵌套结构
### 传统写法(双层 for)
```rust
fn count_collection_for(collection: &[HashMap], value: Progress) -> usize {
let mut count = 0;
for map in collection {
for val in map.values() {
if *val == value {
count += 1;
}
}
}
count
}
```
### 迭代器版 — `flat_map` 把内层"拍平"
```rust
fn count_collection_iterator(collection: &[HashMap], value: Progress) -> usize {
collection
.iter() // 遍历外层 slice
.flat_map(|map| map.values()) // 把每个 map 的 values 拍平成一个流
.filter(|&v| *v == value) // 筛选
.count() // 计数
}
```
**`flat_map` 做了什么:**
```
输入: [{map1}, {map2}, {map3}]
↓ flat_map(|m| m.values())
输出: [v1, v2, v3, v4, v5, ...] ← 所有 map 的 values 连成一条流
```
> `flat_map` 卡住是因为不知道有这个函数。知道之后就简单了:先 `map` 拿到多个 values 迭代器,再 `flat` 把它们拍平。本质上等价于双层 for 循环。
---
## 六、今天踩的坑 & 反思
今天每道题都卡了很久。核心原因不是 Rust 语法难,而是**不知道标准库提供了什么**:
| 卡住的地方 | 原因 | 解决方法 |
| ------------------ | ------------------------------------- | ------------------------- |
| `capitalize_first` | 不知道 `chars()` + `as_str()` 组合 | 查 API |
| `factorial` | 完全不知道 `product()` 存在 | AI 告诉的 |
| `result_with_list` | 知道 `ok()` 但没想到 `?` 可以接在后面 | 多练 |
| `list_of_results` | 知道 `map_err` 但犹豫怎么拼起来 | 多练 |
| `flat_map` | 不知道这个函数 | AI 告诉的 |
| `collect` 返回不同 | 一直以为只能收集成 Vec | 今天理解了 `FromIterator` |
**这种挫败感是正常的。** 迭代器是 Rust 里最"需要积累"的部分——标准库给迭代器实现了上百个方法(`product`、`flat_map`、`filter_map`、`take_while`、`partition`……),多数人都是边查边写,见一个记一个。今天的代码写完,至少这几个方法你不会忘了。
---
## 七、剩余进度
```
✅ iterators §13.2-4 — 今天完成
⬜ smart_pointers §15, §16.3
⬜ threads §16.1-3
⬜ macros §20.5
⬜ clippy Appendix D
⬜ conversions n/a
```
**明天目标:** lifetimes。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[2026-07-30 周四 · Rustlings 收尾]]>
https://kyriechao.github.io/posts/2026/07/30-diary
2026-07-30T13:00:00.000Z
`、`Rc`、`RefCell` 各自解决了什么问题
- `Rc>` 组合实现单线程下的共享可变状态
### C 语言
今天讲运算符,涉及按位运算:
| 运算符 | 含义 | 示例 |
|---|---|---|
| `\|` | 按位或 | `0b0011 \| 0b0101 = 0b0111` |
| `&` | 按位与 | `0b0011 & 0b0101 = 0b0001` |
| `~` | 按位取反 | `~0b0011 = ...11111100`(补码) |
| `^` | 按位异或 | `0b0011 ^ 0b0101 = 0b0110` |
## 明日计划
- C 语言:继续跟课堂,运算符这块偏底层,值得细看
- Rust:推进到 lifetimes]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/07/30-rust-day5
2026-07-30T00:00:00.000Z
Rustlings 测试全部完成,今天集中写代码练习。
---
## 一、Option 补充方法
### 1.1 `filter` — 按条件过滤 Some 值
```rust
fn main() {
let x = Some(5);
let even = x.filter(|n| n % 2 == 0);
println!("{even:?}"); // None — 5 不是偶数
let y = Some(4);
let even = y.filter(|n| n % 2 == 0);
println!("{even:?}"); // Some(4)
}
```
> `filter` 接收一个谓词闭包:若为 `Some` 且条件满足 → 保持不变;否则 → `None`。不会改变内部值,只决定"通过"还是"拦截"。
### 1.2 `transpose` — Option 与 Result 相互翻转
```rust
let x: Option> = Some(Err("bad".to_string()));
let y = x.transpose();
println!("{y:?}"); // Err("bad")
```
| 输入 | `transpose()` 输出 |
| -------------- | ------------------ |
| `Some(Ok(v))` | `Ok(Some(v))` |
| `Some(Err(e))` | `Err(e)` |
| `None` | `Ok(None)` |
> 常见场景:把 `Option>` 翻成 `Result, E>`,方便用 `?` 传播错误。
---
## 二、闭包(Closures)
### 2.1 基础闭包与类型推断
```rust
// 闭包自动推断参数和返回类型
let add = |a, b| a + b;
let x = add(1, 2);
println!("{x}"); // 3
```
> 第一次调用 `add(1, 2)` 时编译器推断出 `a: i32, b: i32 -> i32`。之后类型就锁定了,不能再传 `&str` 之类。
### 2.2 捕获外部变量
```rust
let factor = 2;
let multiply = |n| n * factor; // 不可变借用 factor
println!("{}", multiply(5)); // 10
println!("{}", multiply(10)); // 20 —— 闭包可以多次调用
```
> 这个闭包只借用了 `factor`(不可变引用),实现了 `Fn` trait,可以反复调用。
### 2.3 `FnMut` — 可变借用捕获
```rust
let mut count = 0;
let mut inc = || {
count += 1; // 可变借用 count
count
};
println!("{}", inc()); // 1
println!("{}", inc()); // 2
println!("{}", inc()); // 3
```
> 闭包持有 `&mut count`,每调用一次 +1。这类闭包实现的是 `FnMut` trait。
### 2.4 `move` — 强制所有权转移
```rust
let s = String::from("hello");
let f = move || {
println!("{}", s); // s 的所有权移入闭包
};
f();
// println!("{}", s); // ❌ s 已被移走,编译不通过
```
> **纠正一个常见误区:** `move` 关键字表示"按值捕获"(把所有权拿进来),但闭包**仍然可以多次调用**。只有实现了 `FnOnce` 的闭包才只能调用一次。这里 `println!` 只是借用了 `s`,所以 `f` 实现的是 `Fn`,可以反复调用。
| trait | 调用方式 | 典型场景 |
| -------- | ----------------------- | ------------------------- |
| `Fn` | `&self`,可多次调用 | 只读捕获 |
| `FnMut` | `&mut self`,可多次调用 | 修改捕获的变量 |
| `FnOnce` | `self`,只能调一次 | 消费捕获的值(如 `drop`) |
---
## 三、迭代器(Iterators)
### 3.1 手动迭代 — `next()`
```rust
let v = vec![1, 2, 3];
let mut iter = v.iter();
println!("{:?}", iter.next()); // Some(1)
println!("{:?}", iter.next()); // Some(2)
println!("{:?}", iter.next()); // Some(3)
println!("{:?}", iter.next()); // None —— 迭代结束
```
### 3.2 常用消费者(Consumers)
```rust
let sum: i32 = v.iter().sum(); // 求和
let count = v.iter().count(); // 计数
let collected: Vec = v.iter().copied().collect(); // 收集到 Vec
```
> `copied()` 把 `&i32` 转成 `i32`(对 `Copy` 类型适用),然后 `collect()` 收进 `Vec`。
### 3.3 `filter` + `map` — 经典组合
```rust
let v2 = vec![1, 2, 3, 4, 5];
let result: Vec = v2
.iter()
.filter(|&&x| x % 2 == 0) // 保留偶数
.map(|&x| x * 2) // 翻倍
.collect();
println!("{result:?}"); // [4, 8]
```
> **注意双重引用 `&&x`:** `v2.iter()` 产生 `&i32`,`filter` 再借一次变成 `&&i32`,所以需要 `&&x` 来解两层引用,或者直接用 `|x| **x % 2 == 0`。
### 3.4 `fold` — 累积归约
```rust
let sum = v2.iter().fold(0, |acc, &x| acc + x);
println!("{}", sum); // 15
```
| 方法 | 输入 | 输出 |
| --------------- | -------------------------- | ------------ |
| `fold(init, f)` | 迭代器 + 初始值 + 累积函数 | 单值 |
| 等价于 | 循环 `acc = f(acc, item)` | 最终累积结果 |
### 3.5 `zip` — 并行迭代两个集合
```rust
let names = vec!["Alice", "Bob"];
let scores = vec![85, 90];
for (name, score) in names.iter().zip(scores.iter()) {
println!("{} {}", name, score);
}
// Alice 85
// Bob 90
```
> 两个迭代器按位置配对,较短的耗尽时停止。
---
## 四、智能指针
### 4.1 `Box` — 堆分配
```rust
use std::{cell::RefCell, rc::Rc};
enum List {
Cons(i32, Box),
Nil,
}
fn main() {
let b = Box::new(5);
println!("{b}"); // 5
// let list = List::Cons(1, Box::new(List::Cons(2, Box::new(List::Nil))));
// println!("{list:?}");
}
```
> Rust 要求编译期知道每个类型的大小。`List` 是递归的,编译器算不出大小,所以用 `Box` 把递归部分放堆上——`Box` 是指针,大小固定。
### 4.2 `Rc` — 引用计数(单线程共享所有权)
```rust
let data = Rc::new(String::from("hello"));
let data2 = Rc::clone(&data);
println!("引用计数: {}", Rc::strong_count(&data)); // 2
println!("{}", data2); // hello
```
> `Rc::clone` 不深拷贝数据,只增加引用计数。`Rc` **不是线程安全**的(没有 `Send`/`Sync`),多线程场景用 `Arc`。
### 4.3 `RefCell` — 内部可变性(运行时借用检查)
```rust
let data = RefCell::new(5);
{
let mut ref_mut = data.borrow_mut();
*ref_mut += 1;
} // ref_mut 在此 drop,释放可变借用
println!("{}", data.borrow()); // 6
```
| 对比 | `&mut T`(编译期) | `RefCell`(运行时) |
| -------- | ------------------ | ---------------------- |
| 检查时机 | 编译期 | 运行时 |
| 违规后果 | 编译错误 | **panic** |
| 灵活性 | 受限于借用规则 | 可在不可变上下文中修改 |
> **关键规则:** 同一作用域内只能有一个 `borrow_mut()`,或者多个 `borrow()`,不能同时——这和 `&mut` / `&` 的规则一样,只不过从编译期挪到了运行时。
### 4.4 `Rc>` — 组合拳:共享 + 可变
```rust
let data = Rc::new(RefCell::new(5));
let data2 = Rc::clone(&data);
*data2.borrow_mut() += 1; // 通过 data2 修改内部值
println!("{}", data.borrow()); // 6 —— data 也看到了变化
println!("{:?}", data2); // RefCell { value: 6 }
```
> `Rc` 允许多个所有者,`RefCell` 允许在不可变引用下修改内部值。组合起来就是**多个所有者都可以修改同一块数据**——类似于单线程下的共享可变状态。
---
## 五、本日小结
| 知识点 | 掌握程度 | 说明 |
| ---------------------------------- | -------- | -------------------------------- |
| `Option::filter` | 会用 | 条件过滤 Some,不满足转 None |
| `Option::transpose` | 会用 | Option ↔ Result
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[日志]]>
https://kyriechao.github.io/posts/2026/07/29-diary
2026-07-29T00:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/07/29-rust-day4
2026-07-29T00:00:00.000Z
5 勺,22:00 之后 -> 0 勺(被吃光了)
// 如果 hour_of_day > 23(非法时间),返回 None
fn maybe_ice_cream(hour_of_day: u16) -> Option {
match hour_of_day {
hour if hour < 22 => Some(5),
hour if hour >= 22 && hour < 24 => Some(0),
_ => None,
}
}
fn main() {
// You can optionally experiment here.
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn raw_value() {
// 用 unwrap() 取出 Option 里包裹的值
let ice_creams = maybe_ice_cream(12).unwrap();
assert_eq!(ice_creams, 5); // Don't change this line.
}
#[test]
fn check_ice_cream() {
assert_eq!(maybe_ice_cream(0), Some(5));
assert_eq!(maybe_ice_cream(9), Some(5));
assert_eq!(maybe_ice_cream(18), Some(5));
assert_eq!(maybe_ice_cream(22), Some(0));
assert_eq!(maybe_ice_cream(23), Some(0));
assert_eq!(maybe_ice_cream(24), None);
assert_eq!(maybe_ice_cream(25), None);
}
}
```
> 今天就做了一道 Rustlings 题。Options 概念学完了,但练习题还没做完。
---
## 二、自定义练习:模拟用户查询
### 2.1 User 结构体与查找
```rust
struct User {
id: u32,
name: String,
age: Option, // 年龄可能未填写
email: Option, // 邮箱可能未填写
}
fn find_user_by_id(id: u32) -> Option {
// 模拟数据库查询——查不到返回 None
if id == 1 {
Some(User {
id: 1,
name: "Alice".to_string(),
age: Some(25),
email: Some("alice@example.com".to_string()),
})
} else if id == 2 {
Some(User {
id: 2,
name: "Bob".to_string(),
age: None,
email: None,
})
} else {
None
}
}
```
> 这里 `age` 和 `email` 都用 `Option` 表示"可有可无"的字段——这正是 Rust 没有 `null` 的替代方案。
### 2.2 从邮箱提取域名 — `and_then` + `split`
```rust
fn get_user_email_domain(user: &User) -> Option {
// 从 email 里提取 @ 后面的部分
// 例如 "alice@example.com" -> "example.com"
// 如果 email 是 None,返回 None
user.email
.as_ref() // Option<&String>(借用,不转移所有权)
.and_then(|email| email.split("@").nth(1).map(|o| o.to_string()))
}
```
**链式调用拆解:**
1. `user.email.as_ref()` → 得到 `Option<&String>`,避免把 `email` 移出 `user`
2. `and_then(...)` → 如果 `None`,短路返回 `None`;否则用闭包处理内部值
3. `split("@").nth(1)` → 按 `@` 分割,取第 2 段(索引 1),返回 `Option<&str>`
4. `.map(|o| o.to_string())` → 将 `&str` 转为 `String`
### 2.3 年龄段判断 — `match` + 守卫
```rust
fn get_user_age_group(user: &User) -> String {
match user.age {
Some(age) if age < 18 => String::from("未成年"),
Some(age) if age >= 18 && age < 60 => String::from("成年人"),
Some(_) => String::from("老年人"), // age >= 60
None => String::from("未知"),
}
}
```
> **改进点:** 去掉了原版冗余的 `Some(_) | None` 分支——三条 `Some` 守卫已经覆盖了所有年龄值,`None` 单独兜底即可。
### 2.4 调用层 — `if let` 解包
```rust
fn main() {
let user1 = find_user_by_id(1);
let user2 = find_user_by_id(2);
let user3 = find_user_by_id(99);
// 打印 user1 的邮箱域名
if let Some(u) = &user1 {
println!("邮箱域名: {:?}", get_user_email_domain(u));
}
// 打印各用户的年龄段
if let Some(u) = &user1 {
println!("user1 年龄段: {}", get_user_age_group(u));
}
if let Some(u) = &user2 {
println!("user2 年龄段: {}", get_user_age_group(u));
}
if let Some(u) = &user3 {
println!("user3 年龄段: {}", get_user_age_group(u));
} else {
println!("user3 未找到");
}
}
```
> `if let Some(u) = &user` 的 `&` 是借用的关键——`find_user_by_id` 返回 `Option`,所有权还在 `user1` 身上,用 `&` 借用来匹配就不会把值移走。
---
## 三、Option 转 Result — 配置读取
### 3.1 核心函数
```rust
fn get_config_value(key: &str) -> Option {
// 模拟从配置里读取键值对
let config = vec![("name", "Alice"), ("age", "25"), ("email", "")];
config
.iter()
.find(|(k, _)| *k == key) // 找到第一个匹配的元组,返回 Option<&&(&str, &str)>
.map(|(_, v)| v.to_string()) // 取出值并转为 String
}
fn parse_age(s: &str) -> Result {
s.parse().map_err(|_| format!("'{}' 不是有效年龄", s))
}
```
### 3.2 `get_user_age` — `?` + 组合子版
```rust
fn get_user_age() -> Result {
// 1. 获取 age 配置,若为 None -> Err
// 2. 若为空字符串 -> Err
// 3. 否则调用 parse_age 解析
//
// 要求:尽量用 ? 和组合子,减少 match 嵌套
let age_str = get_config_value("age").ok_or("缺少 age 配置")?;
if age_str.is_empty() {
return Err(String::from("age 不能为空"));
}
parse_age(&age_str)
}
```
**改进说明(对比原版):**
| 原版 `if let` | 改进版 `ok_or` + `?` |
| ------------------ | ----------------------------------------------- |
| 4 行 + 嵌套 else | 1 行,链式语义 |
| 手动处理 None 分支 | `ok_or` 把 `Option` 转成 `Result`,`?` 自动短路 |
> `ok_or` 的用法:`Option → Result`,`None` 时变成你指定的 `Err`。配上 `?`,None 时直接 return Err,Some 时自动 unwrap。
### 3.3 调用
```rust
fn main() {
match get_user_age() {
Ok(age) => println!("用户年龄: {}", age),
Err(e) => println!("错误: {}", e),
}
}
```
---
## 四、`?` 运算符链式调用 — 数据库查询模拟
```rust
struct Database;
struct Connection;
fn connect_db() -> Option { Some(Database) }
fn get_conn(db: &Database) -> Option { Some(Connection) }
fn query_user(conn: &Connection, id: u32) -> Option { Some("Alice".to_string()) }
fn get_username(user_id: u32) -> Option {
let db = connect_db()?;
let conn = get_conn(&db)?;
let user = query_user(&conn, user_id)?;
Some(user.to_uppercase())
}
```
> 注释掉的那一大段 `if db.is_none()` + `unwrap()` 就是这四个 `?` 的**手动展开版**。`?` 的本质:遇到 `None` 就提前 return,本质是语法糖,但相比手动判断可读性提升巨大。
---
## 五、本日小结
| 知识点 | 掌握程度 | 说明 |
| ---------------------- | -------- | ---------------------------------- |
| `Option` 概念 | 已学完 | 替代 null,表达"值可有可无" |
| `unwrap()` | 会用 | 测试或已知 Some 时取值,panic 风险 |
| `if let Some(x) = ...` | 会用 | 只关心 Some 分支时的简洁写法 |
| `match` + 守卫 | 会用 | 配合 `if` 条件做精细匹配 |
| `.as_ref()` | 会用 | 借用 Option 内部值,不转移所有权 |
| `.and_then()` | 会用 | Option 链式处理,None 自动短路 |
| `ok_or()` + `?` | 会用 | Option → Result 转换 |
| `?` 运算符 | 会用 | 链式调用,自动传播 None/Err |
| `Result` | 初识 | 配合 Option 做错误处理 |
**明天目标:** Options 剩余练习题收尾,推进到 lifetimes。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[日志]]>
https://kyriechao.github.io/posts/2026/07/28-diary
2026-07-28T00:00:00.000Z
Rust,优先保证课堂内容吃透
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/07/28-rust-day3
2026-07-28T00:00:00.000Z
对应章节:Variables(§3.1)、Functions(§3.3)、If(§3.5)
**题目:** Mary 买苹果,每个苹果 2 rustbucks。如果购买数量超过 40 个,则每个苹果降至 1 rustbuck。编写函数计算总价。
```rust
fn calculate_price_of_apples(n: i32) -> i32 {
if n > 40 {
n
} else {
n * 2
}
}
fn main() {}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn verify_test() {
assert_eq!(calculate_price_of_apples(35), 70);
assert_eq!(calculate_price_of_apples(40), 80);
assert_eq!(calculate_price_of_apples(41), 41);
assert_eq!(calculate_price_of_apples(65), 65);
}
}
```
**关键知识点:**
| 知识点 | 说明 |
| ----------------------------- | ------------------------------------------------------ |
| `fn 函数名(参数) -> 返回类型` | Rust 函数定义语法,`->` 后跟返回值类型 |
| `if/else` 是**表达式** | 可以直接返回值,不需要 `return` 关键字(当然也可以用) |
| 表达式末尾不加分号 | `n` 和 `n * 2` 后面没有 `;`,表示这是返回值 |
| `i32` | 32 位有符号整数,Rust 默认整数类型 |
| `#[test]` | 属性宏,标记测试函数 |
| `assert_eq!` | 断言宏,左右两值相等则测试通过 |
---
## 2. 练习二:字符串、Vec、枚举与模式匹配
> 对应章节:Strings(§8.2)、Vecs(§8.1)、Move Semantics(§4.1-2)、Modules(§7)、Enums(§6)
**题目:** 实现 `transformer` 函数,输入字符串和命令的元组列表,根据命令对字符串做三种操作之一:转大写、去首尾空格、追加 N 个 "bar"。
```rust
enum Command {
Uppercase,
Trim,
Append(usize), // 枚举成员可以携带数据!
}
mod my_module {
use super::Command;
pub fn transformer(input: Vec<(String, Command)>) -> Vec {
let mut results = Vec::new();
for eve in input {
let trans = match eve.1 {
Command::Uppercase => eve.0.to_uppercase(),
Command::Trim => eve.0.trim().to_string(),
Command::Append(n) => {
let mut s = eve.0.clone();
s.push_str(&"bar".repeat(n));
s
}
};
results.push(trans);
}
results
}
}
fn main() {}
#[cfg(test)]
mod tests {
use super::Command;
use crate::my_module::transformer; // 从模块中导入函数
#[test]
fn it_works() {
let input = vec![
("hello".to_string(), Command::Uppercase),
(" all roads lead to rome! ".to_string(), Command::Trim),
("foo".to_string(), Command::Append(1)),
("bar".to_string(), Command::Append(5)),
];
let output = transformer(input);
assert_eq!(
output,
[
"HELLO",
"all roads lead to rome!",
"foobar",
"barbarbarbarbarbar",
]
);
}
}
```
**关键知识点:**
| 知识点 | 说明 |
| ------------------------ | ------------------------------------------------------------ |
| `enum` 成员可携带数据 | `Append(usize)` 表示该成员包含一个 `usize` 类型的值 |
| `match` 模式匹配 | Rust 的 match 是**穷尽**的,所有枚举成员都必须处理 |
| `String` vs `&str` | `String` 是拥有所有权的堆分配字符串,`&str` 是借用的字符串切片 |
| `to_uppercase()` | 返回新的 `String`,原字符串不变 |
| `trim()` | 返回 `&str` 切片(不拷贝数据),需要 `to_string()` 转为 `String` |
| `"bar".repeat(n)` | 将 "bar" 重复 n 次,返回 `String` |
| `mod` / `pub` / `use` | Rust 模块系统三件套——定义模块、公开函数、导入路径 |
| `clone()` | 显式克隆数据,获得独立所有权(String 不实现 Copy) |
| 元组 `(String, Command)` | 用 `.0`、`.1` 按索引访问元组元素 |
> Rust 核心概念——**所有权(Ownership)**:`eve.0` 是 `String` 类型,直接使用会转移所有权。因此 `Append` 分支中用 `eve.0.clone()` 克隆了一份数据,避免所有权转移后原变量失效。
---
## 3. 练习三:HashMap 与结构体
> 对应章节:HashMaps(§8.3)、Structs(§5.1)
**题目:** 给定足球比赛结果(每行 `"队伍1,队伍2,进球1,进球2"`),构建计分表,记录每支球队的总进球数和总失球数。
```rust
use std::collections::HashMap;
#[derive(Default)] // 自动实现 Default trait,方便构造默认值
struct TeamScores {
goals_scored: u8,
goals_conceded: u8,
}
fn build_scores_table(results: &str) -> HashMap<&str, TeamScores> {
let mut scores = HashMap::<&str, TeamScores>::new();
for line in results.lines() {
let mut split_iterator = line.split(',');
let team_1_name = split_iterator.next().unwrap();
let team_2_name = split_iterator.next().unwrap();
let team_1_score: u8 = split_iterator.next().unwrap().parse().unwrap();
let team_2_score: u8 = split_iterator.next().unwrap().parse().unwrap();
let g1 = TeamScores { goals_scored: team_1_score, goals_conceded: team_2_score };
let g2 = TeamScores { goals_scored: team_2_score, goals_conceded: team_1_score };
scores
.entry(team_1_name)
.and_modify(|m| {
m.goals_scored += team_1_score;
m.goals_conceded += team_2_score;
})
.or_insert(g1);
scores
.entry(team_2_name)
.and_modify(|m| {
m.goals_scored += team_2_score;
m.goals_conceded += team_1_score;
})
.or_insert(g2);
}
scores
}
fn main() {}
#[cfg(test)]
mod tests {
use super::*;
const RESULTS: &str = "England,France,4,2
France,Italy,3,1
Poland,Spain,2,0
Germany,England,2,1
England,Spain,1,0";
#[test]
fn build_scores() {
let scores = build_scores_table(RESULTS);
assert!(
["England", "France", "Germany", "Italy", "Poland", "Spain"]
.into_iter()
.all(|team_name| scores.contains_key(team_name))
);
}
#[test]
fn validate_team_score_1() {
let scores = build_scores_table(RESULTS);
let team = scores.get("England").unwrap();
assert_eq!(team.goals_scored, 6);
assert_eq!(team.goals_conceded, 4);
}
#[test]
fn validate_team_score_2() {
let scores = build_scores_table(RESULTS);
let team = scores.get("Spain").unwrap();
assert_eq!(team.goals_scored, 0);
assert_eq!(team.goals_conceded, 3);
}
}
```
**关键知识点:**
| 知识点 | 说明 |
| ---------------------------------- | ------------------------------------------------------------ |
| `HashMap` | 键值对集合,键(Key)唯一 |
| `#[derive(Default)]` | 自动实现 `Default` trait,结构体字段取各自类型的默认值(`u8` 默认为 0) |
| `struct` 结构体 | 自定义复合数据类型,`TeamScores { goals_scored, goals_conceded }` |
| **Entry API** | Rust HashMap 的招牌操作,一行搞定"存在则修改,不存在则插入" |
| `entry().and_modify().or_insert()` | 链式调用:先找 key,找到就执行 `and_modify` 的闭包,找不到就插入 `or_insert` 的值 |
| `split(',')` | 按逗号切分字符串,返回迭代器 |
| `parse::()` | 将 `&str` 解析为 `u8`,返回 `Result`,这里用 `unwrap()` 简单处理 |
| `lines()` | 将字符串按换行符切分,返回每行的迭代器 |
| `&str` 作为 HashMap 的 Key | `&str` 是借用,要注意生命周期——这里 key 借用的数据(`RESULTS` 常量)在整个程序运行期间都存在,所以安全 |
**Entry API 工作流程:**
```
scores.entry(team_1_name) // ① 查找 key,返回 Entry 枚举(Occupied 或 Vacant)
.and_modify(|m| { // ② 如果 Occupied(已存在),修改已有值
m.goals_scored += ...;
})
.or_insert(g1); // ③ 如果 Vacant(不存在),插入新值 g1
```
> `and_modify` 返回的还是 `Entry`,所以可以继续链式调用 `or_insert`。
---
## 4. 练习四:HashMap 与枚举作为键
> 对应章节:HashMaps(§8.3)、Enums(§6)
**题目:** 水果篮用 HashMap 表示(水果类型 → 数量)。篮中已有 Apple(4)、Mango(2)、Lychee(5)。补充缺失的水果种类(Banana、Pineapple),每种至少 1 个,总数要超过 11。**不能修改已有水果的数量。**
```rust
use std::collections::HashMap;
#[derive(Hash, PartialEq, Eq, Debug)] // 枚举作为 HashMap Key 必须实现这些 trait
enum Fruit {
Apple,
Banana,
Mango,
Lychee,
Pineapple,
}
fn fruit_basket(basket: &mut HashMap) {
let fruit_kinds = [
Fruit::Apple,
Fruit::Banana,
Fruit::Mango,
Fruit::Lychee,
Fruit::Pineapple,
];
for fruit in fruit_kinds {
basket.entry(fruit).or_insert(1); // 不存在就插入 1,存在则什么也不做
}
}
fn main() {}
#[cfg(test)]
mod tests {
use super::*;
fn get_fruit_basket() -> HashMap {
let content = [(Fruit::Apple, 4), (Fruit::Mango, 2), (Fruit::Lychee, 5)];
HashMap::from_iter(content)
}
#[test]
fn test_given_fruits_are_not_modified() {
let mut basket = get_fruit_basket();
fruit_basket(&mut basket);
assert_eq!(*basket.get(&Fruit::Apple).unwrap(), 4);
assert_eq!(*basket.get(&Fruit::Mango).unwrap(), 2);
assert_eq!(*basket.get(&Fruit::Lychee).unwrap(), 5);
}
#[test]
fn at_least_five_types_of_fruits() {
let mut basket = get_fruit_basket();
fruit_basket(&mut basket);
assert!(basket.len() >= 5);
}
#[test]
fn greater_than_eleven_fruits() {
let mut basket = get_fruit_basket();
fruit_basket(&mut basket);
let count = basket.values().sum::();
assert!(count > 11);
}
}
```
**关键知识点:**
| 知识点 | 说明 |
| ------------------------------ | ------------------------------------------------------------ |
| 枚举作为 HashMap Key | 必须实现 `Hash` + `PartialEq` + `Eq` trait(`#[derive]` 一键搞定) |
| `&mut` 可变借用 | 函数参数 `basket: &mut HashMap` 表示借用可修改的引用 |
| `entry().or_insert(1)` | 最简用法:key 存在就不动,不存在就插入 1 |
| `#[derive]` 属性宏 | 自动为自定义类型实现标准 trait(`Debug`、`Clone`、`Hash`、`Default` 等) |
| `HashMap::from_iter()` | 从迭代器构造 HashMap |
| `basket.values().sum::()` | 消费 values 迭代器,求和。`::` 是 turbofish 语法指定类型 |
---
## 5. 核心知识点总结
### 5.1 `if/else` 是表达式
```rust
// Rust:if 直接返回值
let price = if n > 40 { n } else { n * 2 };
// C 语言等效写法(三目运算符):
// int price = n > 40 ? n : n * 2;
```
### 5.2 `match` 模式匹配
```rust
match value {
Command::Uppercase => /* 处理逻辑 */,
Command::Trim => /* 处理逻辑 */,
Command::Append(n) => /* n 绑定到内部数据 */,
}
// match 必须穷尽所有可能(exhaustive),否则编译报错
```
### 5.3 所有权(Ownership)基础
| 类型 | 特性 |
| ----------------------------------------------- | ------------------------------------------------- |
| `i32`、`u8`、`bool`、`char` 等基本类型 | 实现了 `Copy` trait,赋值时自动复制,原变量仍可用 |
| `String`、`Vec`、`HashMap` 等堆分配类型 | 未实现 `Copy`,赋值时**转移所有权**,原变量失效 |
| `&T`(引用) | **借用**,不转移所有权,原变量仍可用 |
```rust
let a = 42;
let b = a; // a 是 i32,实现了 Copy,所以 a 仍然可用
let s1 = String::from("hello");
let s2 = s1; // s1 所有权转移给 s2,s1 不再可用!
// println!("{}", s1); // ❌ 编译错误:s1 已被移动
```
### 5.4 HashMap Entry API
```rust
// 模式一:存在则修改,不存在则插入
map.entry(key)
.and_modify(|v| *v += 1)
.or_insert(0);
// 模式二:只保证键存在(不存在就插入默认值)
map.entry(key).or_insert(default_value);
// 模式三:存在就返回可变引用,不存在就插入并返回
let v = map.entry(key).or_insert_with(|| expensive_computation());
```
### 5.5 模块系统速查
```rust
mod my_module { // 定义模块
pub fn public_fn() {} // pub = 公开
fn private_fn() {} // 默认私有
}
use crate::my_module::public_fn; // 导入(绝对路径)
use super::SomeType; // 导入父模块的类型
use std::collections::HashMap; // 导入标准库类型
```
---
## 6. Rustlings 练习与《Rust Book》章节对照
| 练习 | 《Rust Book》章节 |
| --------------- | ----------------- |
| variables | §3.1 |
| functions | §3.3 |
| if | §3.5 |
| primitive_types | §3.2, §4.3 |
| vecs | §8.1 |
| move_semantics | §4.1-2 |
| structs | §5.1, §5.3 |
| enums | §6, §18.3 |
| strings | §8.2 |
| modules | §7 |
| hashmaps | §8.3 |
| options | §10.1 |
| error_handling | §9 |
| generics | §10 |
| traits | §10.2 |
| lifetimes | §10.3 |
| tests | §11.1 |
| iterators | §13.2-4 |
| smart_pointers | §15, §16.3 |
| threads | §16.1-3 |
| macros | §20.5 |
| clippy | Appendix D |
| conversions | n/a |
---
## 7. 学习进度
当前进度:已完成变量、函数、条件判断、基本类型、Vec、移动语义、结构体、枚举、字符串、模块、HashMap,**正在做 options 相关练习**。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[日志]]>
https://kyriechao.github.io/posts/2026/07/27-diary
2026-07-27T00:00:00.000Z
- Rustlings 实战:用已学语法刷题
- 尝试第 3 题(自引用结构体)的索引方案:用 usize 范围替代 &str]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划]]>
https://kyriechao.github.io/posts/2026/07/27-rust-day2
2026-07-27T00:00:00.000Z
Rust 默认不可变的设计哲学:编译期就能确定哪些值会变、哪些不会,从而做更精确的借用检查。这跟函数式编程的"不可变数据"理念一致。
---
## 三、基本数据类型
```rust
fn main(){
let tup:(i32,f64,bool) = (21, 160.0, true);
let arr = [1,2,3,4,5];
println!("年龄:{}",tup.0);
println!("身高:{}",tup.1);
println!("是学生么:{}",tup.2);
println!("数组的第3个元素:{}",arr[2]);
println!("数组越界:{}",arr[10]);
}
```
越界访问的编译期警告:
```
error: this operation will panic at runtime
index out of bounds: the length is 5 but the index is 10
```
### 知识点
#### 标量类型(Scalar Types)
| 类型 | 示例 | 说明 |
| ---- | ------------------ | ------------------------------------------------------------ |
| 整数 | `i8` `u32` `isize` | 有符号 `i` / 无符号 `u`,位宽 8/16/32/64/128,`size` 跟平台指针同宽 |
| 浮点 | `f32` `f64` | 默认 `f64`(IEEE 754) |
| 布尔 | `bool` | `true` / `false` |
| 字符 | `char` | 4 字节,存 Unicode 标量值(不是 ASCII) |
#### 复合类型
**元组(Tuple)**:固定长度,每个位置类型可不同,用 `.索引` 访问。
```rust
let tup: (i32, f64, bool) = (21, 160.0, true);
println!("{}", tup.0); // 21
// 也可解构:let (age, height, is_student) = tup;
```
**数组(Array)**:固定长度,所有元素同类型,分配在**栈**上。
```rust
let arr: [i32; 5] = [1, 2, 3, 4, 5];
let arr2 = [0; 100]; // 100 个 0
```
数组越界:Rust 在**运行时**做边界检查,越界会 **panic**(而不是像 C 那样读到脏数据)。这是安全性的体现——宁愿崩溃也不允许内存不安全操作。
> 变长数组用 `Vec`(第 11 课),在堆上分配。
---
## 四、函数
```rust
// 课堂代码
fn main(){
say_hello();
let result = add(5, 3);
println!("5 + 3 = {}", result);
}
fn say_hello() {
println!("Hello, world!");
}
fn add(a: i32, b: i32) -> i32 {
a + b
}
```
```rust
// 作业:multiply / is_even / calculate
fn main(){
println!("3*5 = {}", multiply(3, 5));
println!("Is 4 even? {}", is_even(4));
println!("Calculate (3+5)*2 = {}", calculate(3,5));
}
fn multiply(a: i32, b: i32) -> i32 {
a * b
}
fn is_even(n: i32) -> bool {
n % 2 == 0
}
fn calculate(a:i32,b:i32)->i32{
(a+b)*2
}
```
### 知识点——语句 vs 表达式
这是 Rust 非常核心的概念:
| 概念 | 特点 | 示例 |
| ------------------------ | ----------------------------------- | ----------------------------------- |
| **语句(Statement)** | 执行操作,**不返回值**,以 `;` 结尾 | `let x = 5;` |
| **表达式(Expression)** | 计算并**返回值**,不以 `;` 结尾 | `a + b`、`if true { 1 } else { 0 }` |
```rust
fn add(a: i32, b: i32) -> i32 {
a + b // 表达式,不加分号 = 返回值
// 等价于 return a + b;
}
fn add_wrong(a: i32, b: i32) -> i32 {
a + b; // 加了分号 → 语句 → 返回 () → 类型不匹配!
}
```
> `return` 关键字用于**提前返回**,最后一个表达式的值是默认返回值(更符合 Rust 惯用风格)。
### 函数签名
```rust
fn 函数名(参数: 类型) -> 返回类型 { 函数体 }
```
- 参数**必须**标注类型(不支持类型推断)。
- `->` 后面是返回类型,若函数无返回值则可省略(实际返回 `()`,即 unit 类型)。
---
## 五、控制流
运行结果存档:
```
年龄为20,状态为成年
n = 10
n = 9
...
n = 1
1到100的和为5050
```
### 知识点
#### `if` 是表达式
```rust
let status = if age >= 18 {
"成年"
} else {
"未成年"
}; // 注意这里有分号,因为这是 let 语句
// 两个分支必须返回相同类型
```
与 C/Java 不同,Rust 中 `if` 可以有返回值。三元运算 `x ? a : b` 在 Rust 中直接用 `if` 表达即可。
#### 三种循环
| 循环 | 语法 | 适用场景 |
| ------- | -------------------------- | ------------------------------------ |
| `loop` | `loop { ... }` | 无限循环,需手动 `break`;可带返回值 |
| `while` | `while cond { ... }` | 条件循环 |
| `for` | `for item in iter { ... }` | 遍历集合(最常用、最安全) |
```rust
// loop 带返回值
let result = loop {
counter += 1;
if counter == 10 {
break counter * 2; // break 后面跟值 = loop 的返回值
}
}; // result = 20
```
> 能用 `for` 就不要用 `while` + 手动索引——编译器会对 `for` 做更多优化,且消除了越界风险。
---
## 六、所有权(Ownership)—— Rust 最核心的概念
### 6.1 Move 语义
```rust
// Move 报错实验
// error[E0382]: borrow of moved value: `s`
// move occurs because `s` has type `String`, which does not implement the `Copy` trait
```
修复:使用 `.clone()` 做深拷贝
```rust
fn main() {
let s = String::from("test");
let t = s.clone();
println!("s:{} t:{}", s, t);
}
```
### 知识点——所有权三规则
1. Rust 中每一个值都有一个**所有者(Owner)**。
2. 同一时刻**只能有一个所有者**。
3. 当所有者离开作用域,值会被**自动释放**(调用 `drop`)。
```rust
let s1 = String::from("hello");
let s2 = s1; // s1 的所有权转移给了 s2(Move)
// println!("{}", s1); // 编译错误!s1 已经失效
```
### 栈上数据 vs 堆上数据——Move 与 Copy 的本质区别
这就是你表中"从背规则到理解栈/堆差异"的关键:
| 数据位置 | 特性 | 赋值行为 | 实现了 |
| -------------------------------------------- | -------------------------- | -------------------------------- | ------------- |
| **栈**(整数、布尔、char、元组含 Copy 类型) | 大小编译期确定,拷贝成本低 | `let b = a;` 后 `a` 仍然可用 | `Copy` trait |
| **堆**(String、Vec 等) | 大小运行时确定,拷贝成本高 | `let b = a;` 后 `a` 失效(Move) | 未实现 `Copy` |
```rust
let x = 5;
let y = x; // Copy,x 仍可用
println!("{}", x); // OK
let s1 = String::from("hello");
let s2 = s1; // Move,s1 失效
// println!("{}", s1); // error[E0382]
```
**为什么堆数据不自动 Copy?**——`String` 内部是一个指针指向堆内存。如果自动 Copy 指针(浅拷贝),两个变量指向同一块堆内存,离开作用域时会发生**双重释放(Double Free)**。Rust 用 Move 语义从根本上杜绝了这个问题。
---
## 七、引用与借用(References & Borrowing)
报错存档:
```
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
```
### 知识点——引用规则
| 引用类型 | 写法 | 权限 | 同时存在数量 |
| ---------- | -------- | -------- | :----------------: |
| 不可变引用 | `&T` | 只读 | 无限制 |
| 可变引用 | `&mut T` | 可读可写 | **同时只能有一个** |
**核心规则(两条):**
1. 在任意给定时间,**要么**只能有一个可变引用,**要么**只能有任意数量的不可变引用,两者不能同时存在。
2. 引用必须始终有效(生命周期保证,见后文)。
```rust
let mut s = String::from("hello");
let r1 = &s; // 不可变引用,OK
let r2 = &s; // 不可变引用,OK
// let r3 = &mut s; // 错误!已有不可变引用存在
println!("{} {}", r1, r2); // r1, r2 最后使用位置
// 此后 r1, r2 不再使用,可以创建可变引用了
let r3 = &mut s; // OK,因为 r1, r2 已经"失效"
```
> 这条规则在编译期杜绝了**数据竞争(Data Race)**——两个指针同时访问同一数据、其中一个是写操作。不需要 GC,不需要锁,编译期就保证了线程安全的前提条件。
---
## 八、结构体(Struct)
```rust
struct Rentangle {
width: u32,
height: u32,
}
fn area(r:&Rentangle) -> u32{
r.height * r.width
}
fn main() {
let r1 = Rentangle{
width:10,
height:20,
};
let r2 = Rentangle{
width:10,
height:10,
};
println!("{}",area(&r1));
println!("{}",area(&r2));
}
```
### 知识点
#### 三种结构体
```rust
// 1. 具名字段结构体(最常用)
struct User {
name: String,
age: u32,
}
// 2. 元组结构体(字段无名称,通过索引访问)
struct Color(u8, u8, u8);
let black = Color(0, 0, 0);
println!("{}", black.0);
// 3. 单元结构体(无字段,用作标记类型)
struct AlwaysEqual;
```
#### `impl` 块——给结构体添加方法
```rust
impl Rentangle {
fn area(&self) -> u32 {
self.width * self.height
}
fn can_hold(&self, other: &Rentangle) -> bool {
self.width > other.width && self.height > other.height
}
// 关联函数(没有 self,相当于静态方法)
fn square(size: u32) -> Rentangle {
Rentangle { width: size, height: size }
}
}
// 调用
let r = Rentangle { width: 10, height: 20 };
r.area(); // 方法调用
Rentangle::square(5); // 关联函数调用
```
> `&self` 是 `self: &Self` 的语法糖。`self` 的所有权形式分三种:`&self`(不可变借用)、`&mut self`(可变借用)、`self`(获取所有权,极少用)。
---
## 九、枚举与模式匹配(Enum & Pattern Matching)
```rust
enum Shape {
Retangle { width: f64, height: f64 },
Cricle(f64),
Triangle(f64, f64, f64),
}
fn calculate_area(s: &Shape) -> f64 {
match s {
Shape::Cricle(r) =>{
3.14*r*r
},
Shape::Retangle { width, height } =>{
width * height
},
Shape::Triangle(a, b,c) =>{
let p = (a + b + c) / 2.0;
(p * (p - a) * (p - b) * (p - c)).sqrt()
},
}
}
fn main() {
let s1 = Shape::Cricle(4.0);
let s2 = Shape::Retangle { width: 10.0, height: 20.0 };
let s3 = Shape::Triangle(3.0, 4.0, 5.0);
println!("{}",calculate_area(&s1));
println!("{}",calculate_area(&s2));
println!("{}",calculate_area(&s3));
let n :Option = Some(5);
if let Some(5) = n {
println!("is 5");
}
}
```
### 知识点
#### `match` 的穷尽性
编译器强制你处理所有可能的枚举变体,否则编译报错。这是 Rust 消除空指针/未处理分支的关键机制。
#### `Option`——Rust 没有 null
```rust
enum Option {
Some(T), // 有值
None, // 无值
}
```
`Option` 被自动引入作用域(无需 `use`),变体 `Some` 和 `None` 也可直接使用。任何可能"没有值"的情况都用 `Option` 表达,编译期强制处理,避免了 null 引起的运行时崩溃。
#### `if let`——简洁的单分支 match
```rust
// match 写法
match n {
Some(5) => println!("is 5"),
_ => (), // 什么都不做
}
// if let 写法(更简洁)
if let Some(5) = n {
println!("is 5");
}
```
`if let` 是 `match` 的语法糖,当你只关心一个分支时使用。还可以加 `else`:
```rust
if let Some(x) = n {
println!("值为 {}", x);
} else {
println!("没有值");
}
```
---
## 十、错误处理
```rust
use std::io;
fn divide(f1: f64, f2: f64) -> Result {
if f2 == 0.0 {
Err("除数不能为零".to_string())
} else {
Ok(f1 / f2)
}
}
fn divide_err(f1: f64, f2: f64) -> Result {
if f2 == 0.0 {
Err(io::Error::new(io::ErrorKind::InvalidInput, "不能除以零"))?
}
Ok(f1 / f2)
}
fn main() -> Result<(), Box> {
let r = divide(4.0, 0.0);
match r {
Ok(f) => println!("{}", f),
Err(s) => println!("{}", s),
}
let result = divide_err(10.0, 2.0)?;
println!("divide_err 计算结果: {}", result);
let _result2 = divide_err(4.0, 0.0)?;
Ok(())
}
```
### 补做练习:`parse_and_double`(验证 `?` 理解)
```rust
fn parse_number(s: &str) -> Result {
let o = s.parse::();
match o {
Ok(v) => Ok(v),
Err(_) => Err("无法解析:{s}".to_string()),
}
}
fn parse_and_double(s: &str) -> Result {
let o = parse_number(s)?;
Ok(o*2)
}
fn main() {
match parse_and_double("10") {
Ok(n) => println!("结果: {}", n),
Err(e) => println!("错误: {}", e),
}
match parse_and_double("abc") {
Ok(n) => println!("结果: {}", n),
Err(e) => println!("错误: {}", e),
}
}
```
### 知识点
#### `Result`——可恢复错误
```rust
enum Result {
Ok(T), // 成功,包含返回值
Err(E), // 失败,包含错误信息
}
```
#### 三种处理方式对比
| 方式 | 语法 | 行为 | 适用场景 |
| ----------------------- | ----------------------------------------- | --------------------------------- | ------------------------------ |
| `match` | `match r { Ok(v) => ..., Err(e) => ... }` | 分支处理 | 需要针对不同结果做不同逻辑 |
| `unwrap()` / `expect()` | `r.expect("msg")` | 成功取值,失败 **panic** | 原型阶段、测试、确定不会失败时 |
| `?` 运算符 | `r?` | 成功取值,失败**提前 return Err** | 传播错误的惯用写法 |
#### `?` 运算符展开机制
```rust
let value = some_result?;
// 等价于:
let value = match some_result {
Ok(v) => v,
Err(e) => return Err(e.into()), // .into() 会把错误类型转为调用者声明的错误类型
};
```
**前提条件**:使用 `?` 的函数返回类型必须是 `Result` 或 `Option`,且错误类型要兼容。
#### `Box` 的作用
在 `main` 返回 `Result<(), Box>` 时,`?` 可以把任意类型的错误转为 `Box`(因为所有标准错误类型都实现了 `Error` trait)。`Box` 相当于"能装任何错误类型的盒子",牺牲了一点运行时性能换取便利。
- `Box` → 堆上分配(因为 trait 对象大小编译期不确定)
- `dyn Error` → 动态分发的 Error trait 对象
- 具体原理在 Trait 章节会深入讲
---
## 十一、集合类型(一):Vector
```rust
fn sum_vec(v: &Vec) -> i32 {
let mut sum = 0;
for i in v {
sum += i;
}
return sum;
}
fn remove_even(v: &mut Vec) {
let mut i = 0;
while i < v.len() {
if v[i] % 2 == 0 {
v.remove(i);
} else {
i += 1;
}
}
}
fn remove_even_to(v: &mut Vec) {
v.retain(|&x| x % 2 != 0);
}
fn main() {
let mut v1 = vec![10, 20, 30, 40, 50];
let mut v2 = vec![10, 20, 30, 40, 50];
for i in &v1 { print!("{} ", i); }
println!();
for i in &v2 { print!("{} ", i); }
println!();
println!("{}", sum_vec(&v1));
remove_even(&mut v1);
for i in &v1 { println!("{}", i); }
remove_even_to(&mut v2);
for i in &v2 { print!("{} ", i); }
// 编译错误实验
let mut v = vec![1,2,3];
for i in &v{
v.push(*i); // 同时持有不可变引用和可变引用 → 编译报错
}
}
```
报错存档:
```
error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutable
```
### 知识点
#### `Vec` 基础操作
```rust
let mut v: Vec = Vec::new(); // 创建空 Vec
let v2 = vec![1, 2, 3]; // vec! 宏创建
v.push(4); // 追加元素
let last = v.pop(); // 弹出最后一个元素,返回 Option
let third = v[2]; // 索引访问(越界会 panic)
let third = v.get(2); // 返回 Option<&T>(越界返回 None)
```
#### 删除元素的三种方式及借用规则
你在代码中对 `for` 循环中同时读写 Vec 的实验,恰好验证了借用规则:**在不可变引用的生命周期内,不能同时存在可变引用**。`for i in &v` 对 `v` 创建了不可变引用,循环体内不能再 `push` 或 `remove`。
#### `remove` vs `retain`
- `remove(index)` — 删除指定索引元素,后续元素前移,O(n)。
- `retain(|&x| condition)` — 保留满足条件的元素,一次遍历完成,更高效也是 Rust 惯用风格。
---
## 十二、集合类型(二):HashMap
```rust
fn get_age(map: &HashMap, name: &str) -> Option {
for (key, value) in map {
if key == (name) {
return Some(*value);
}
}
None
}
fn main() {
let mut scores = HashMap::new();
scores.insert(String::from("Tom"), 10);
scores.insert(String::from("Mike"), 21);
scores.insert(String::from("Hong"), 30);
for (key, value) in &scores {
println!("{} {}", key, value);
}
let m = get_age(&scores, "Mike");
if let Some(age) = m {
println!("存在 {}",age);
} else {
println!("不存在");
}
*scores.entry(String::from("Mike")).or_insert(0) += 10;
for (key, value) in &scores {
println!("{} {}", key, value);
}
}
```
### 知识点
#### `HashMap` 基础
```rust
use std::collections::HashMap;
let mut map = HashMap::new();
map.insert(key, value); // 插入或覆盖
let v = map.get(&key); // 返回 Option<&V>
map.remove(&key); // 删除
// 遍历
for (k, v) in &map { ... }
```
#### `entry` API——HashMap 的核心技巧
```rust
*scores.entry(String::from("Mike")).or_insert(0) += 10;
```
拆解这一步:
| 步骤 | 方法/操作 | 作用 |
| ---- | --------------- | ------------------------------------------------------- |
| 1 | `.entry(key)` | 获取 `key` 对应的 `Entry` 枚举(`Occupied` / `Vacant`) |
| 2 | `.or_insert(0)` | 如果不存在就插入 `0`,返回 `&mut V`(可变引用) |
| 3 | `*... += 10` | 解引用后原地修改值 |
```rust
// entry 的三种处理方式
map.entry(key).or_insert(default); // 不存在时插入默认值
map.entry(key).and_modify(|v| *v += 1).or_insert(1); // 存在则修改,不存在则插入
```
> `entry` API 只做一次哈希查找,比"先 `get` 检查再 `insert`"高效且更符合 Rust 所有权模型。
#### HashMap 与所有权
```rust
map.insert(String::from("Tom"), 10);
// String 的所有权被移入 HashMap
// 此后不能再使用原来的 String 变量
```
对于实现了 `Copy` 的类型(如 `i32`),值会被拷贝而非移动。所以你的代码中 `10`、`21` 这些值插入后仍可使用。
---
## 十三、字符串深入
```rust
fn greet(name: &str) {
println!("你好,{name}");
}
fn main() {
let s1 = String::from("hello");
let s2 = "World";
greet(&s1);
greet(s2);
let s3 = String::from("Rust");
let s4 = String::from("很好");
let s5 = format!("{} {}", s3, s4);
println!("{s5}");
println!("{} {}", s3, s4);
let s6 = String::from("安全地获取第一个字符。").chars().nth(0);
if let Some(ch) = s6 {
println!("{}", ch);
} else {
println!("取值失败.");
}
}
```
### 知识点
#### `String` vs `&str`
| 类型 | 存储位置 | 可变性 | 所有权 | 用途 |
| -------- | ------------------ | :----: | -------- | ---------------------------------- |
| `String` | 堆上分配 | 可变 | 拥有数据 | 需要修改、动态构建的字符串 |
| `&str` | 指向已有数据的引用 | 不可变 | 借用 | 只读访问字符串数据(函数参数首选) |
```rust
let s = String::from("hello"); // String,堆上分配
let slice: &str = &s; // &str,借用 String 的内容
let literal: &str = "hello"; // &str,字面量直接嵌入二进制
```
**函数参数选 `&str` 的好处**——调用者既可以传 `&String`(自动解引用强制转换,Deref Coercion),也可以传 `&str` 字面量,最灵活。
#### `format!` 宏——不获取所有权的拼接
```rust
let s5 = format!("{} {}", s3, s4);
println!("{} {}", s3, s4); // s3, s4 依然可用!
```
`format!` 只借用参数,不取所有权。对比 `+` 拼接会消耗左侧 String 的所有权:
```rust
let s = s1 + &s2; // s1 所有权被消耗,s1 不可再用
```
#### 访问字符串中的字符
```rust
// 不能直接索引:s[0] ❌(因为 UTF-8 字节不等同于字符)
s.chars().nth(0); // ✅ 返回 Option,遍历 Unicode 标量
```
Rust 不允许 `s[0]` 直接索引,因为 UTF-8 编码下一个字符可能占 1-4 个字节,`s[0]` 拿到的是字节而非完整字符。`.chars()` 和 `.bytes()` 分别按字符和字节迭代,语义明确。
---
## 十四、生命周期(Lifetime)
闭卷测试通过的代码:
```rust
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}
```
### 知识点
#### 为什么需要生命周期标注?
考虑下面这个函数(编译不通过):
```rust
fn longest(x: &str, y: &str) -> &str {
if x.len() > y.len() { x } else { y }
}
```
编译器不知道返回值借用了 `x` 还是 `y`,无法推断返回引用的有效期。**生命周期标注不会改变引用的实际存活时间**,只是告诉编译器多个引用之间的关系。
#### 生命周期语法
```rust
&'a T // 带生命周期标注的引用
fn<'a> // 声明生命周期参数(类似泛型声明)
```
`'a` 读作"生命周期 a",命名惯例使用短小写字母(`'a`、`'b`、`'c`)。
#### 三条生命周期省略规则(方便记忆)
编译器在以下三种情况下可以自动推断生命周期,不需要手动标注:
1. 每个引用参数都有各自的生命周期:`fn foo(x: &T)` → `fn foo<'a>(x: &'a T)`
2. 如果只有一个输入生命周期参数,它被赋予所有输出生命周期
3. 如果有多个输入参数,但其中一个是 `&self` 或 `&mut self`,则 `self` 的生命周期赋予所有输出
**当三条规则都不满足时,必须手动标注。**
你的 `longest` 有两个输入引用、没有 `self`,不符合第 2、3 条,所以必须标注。
---
## 十五、`?` 手动展开
```rust
// 初版(有编译错误)
fn combine_manual() -> Result {
let a = step1();
match a {
Ok(k) => k,
Err(e) => return Err(e),
};
let b = step2();
match b {
Ok(k) => k,
Err(e) => return Err(e),
};
}
```
### `?` 展开的完整对应
```rust
// 使用 ? 的版本
fn combine() -> Result {
let a = step1()?;
let b = step2()?;
Ok(a + b)
}
// 手动展开(修复后)
fn combine_manual() -> Result {
let a = match step1() {
Ok(k) => k,
Err(e) => return Err(e),
};
let b = match step2() {
Ok(k) => k,
Err(e) => return Err(e),
};
Ok(a + b)
}
```
**注意点:**
- `match` 分支后不加分号(它是一个表达式)。
- `let a = match { ... };` 整个 `let` 语句最后要加分号。
- `?` 展开时还会调用 `.into()` 做错误类型转换(这个在 Trait 章节会理解得更透彻)。
---
## 十六、知识汇总
| 概念 | 状态 | 说明 |
| ----------------------------- | :--: | -------------------------------------------- |
| 所有权三规则 | ✅ | 一个所有者、Move 语义、离开作用域自动释放 |
| Move vs Copy | ✅ | 关键区别在于栈数据(Copy)vs 堆数据(Move) |
| 引用与借用规则 | ✅ | 同时只能有多个不可变引用 OR 一个可变引用 |
| 生命周期标注 `'a` | ✅ | 能写出 `longest` 函数 |
| `?` 展开机制 | ✅ | 理解是 `match + return Err` 的语法糖 |
| `match` / `if let` / `Option` | ✅ | 穷尽性检查,消除 null |
| `Result` 三种处理方式 | ✅ | `match` / `expect` / `?` |
| `Vec` 增删查改 | ✅ | `push` / `pop` / `get` / `remove` / `retain` |
| `HashMap` entry API | ✅ | 一次哈希查找完成"存在则改、不存在则插" |
| Trait / 泛型约束 | ❌ | 尚未触及(下一课内容) |
| `Box` 原理 | ⚠️ | 知道用法,Trait 对象和动态分发原理待深入 |
| `impl` 块与关联函数 | ⚠️ | 会用,但面向对象风格的更多模式待补充 |
---
## 十七、课后练习
1. 编写一个函数 `fibonacci(n: u32) -> u64`,返回第 n 个斐波那契数(提示:用 `match` 或 `if` 处理 n=0, n=1 的基础情况)。
2. 用 `impl` 为你的 `Rentangle` 结构体添加 `area` 和 `can_hold` 方法(不用外部函数),体会 `self` 引用的用法。
3. 实现一个函数 `first_word(s: &str) -> &str`,返回字符串的第一个单词(空格分隔),并用不同输入测试生命周期是否正常工作。
4. 用 `HashMap` 实现一个简单的词频统计器:给定一段话,统计每个单词出现的次数(提示:用 `split_whitespace()` + `entry` API)。
5. (选做)阅读 `std::option::Option` 和 `std::result::Result` 的官方文档,看看它们分别有哪些常用方法(`map`、`and_then`、`unwrap_or` 等),尝试在你的代码中替换掉部分 `match`。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[日志]]>
https://kyriechao.github.io/posts/2026/07/25-diary
2026-07-25T00:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Rust 学习计划:3 个月从语法入门到 CLI 实战]]>
https://kyriechao.github.io/posts/2026/07/25-rust-day1
2026-07-25T00:00:00.000Z
后续示例以 Linux 环境为准。
---
## 三、第一个程序:Hello World
### 3.1 手动创建
```shell
mkdir hello_world
cd hello_world
```
新建 `main.rs`:
```rust
fn main() {
println!("Hello World");
}
```
**代码解析:**
- `fn main()` — 程序的入口函数。每个 Rust 可执行程序必须有 `main` 函数。
- `println!` — 这是一个**宏(Macro)**,不是普通函数。宏名后带 `!` 是 Rust 的命名约定。`println!` 会将文本输出到标准输出并自动换行。
- `"Hello World"` — 字符串字面量,类型是 `&str`(字符串切片,后面会详细讲)。
- 每行语句以 `;` 结尾。
### 3.2 编译运行
```shell
rustc main.rs
./main
```
输出:
```
Hello World
```
`rustc` 直接编译单个文件,适合简单场景。正式项目使用 Cargo 管理。
---
## 四、Hello Cargo
### 4.1 创建 Cargo 项目
```shell
cargo new hello_cargo
cd hello_cargo
```
生成的文件结构:
```
hello_cargo/
├── src/
│ └── main.rs # 程序入口
├── Cargo.toml # 项目元数据和依赖配置
└── .gitignore # Git 忽略规则(自动生成)
```
### 4.2 Cargo.toml 结构
```toml
[package]
name = "hello_cargo"
version = "0.1.0"
edition = "2024"
[dependencies]
```
| 字段 | 说明 |
| ---------------- | ------------------------------------------------------------ |
| `[package]` | 包元数据段 |
| `name` | 包名(创建时指定) |
| `version` | 版本号,遵循语义化版本(SemVer) |
| `edition` | Rust 版本代号(2015 / 2018 / 2021 / 2024),影响语言某些特性的默认行为 |
| `[dependencies]` | 项目依赖列表,每行一个 crate 名称和版本约束 |
### 4.3 Cargo 常用命令
```shell
# 编译项目(debug 模式,未优化,包含调试信息)
cargo build
# 编译并运行
cargo run
# 仅检查代码能否通过编译(不生成可执行文件,速度更快)
cargo check
# 编译为 release 模式(优化过,适合发布)
cargo build --release
```
| 命令 | 生成可执行文件 | 速度 | 适用场景 |
| ----------------------- | :------------: | :--: | ------------------ |
| `cargo build` | 是 | 慢 | 需要运行调试 |
| `cargo run` | 是 | 慢 | 编译后立即运行 |
| `cargo check` | 否 | 快 | 开发中反复检查语法 |
| `cargo build --release` | 是 | 最慢 | 正式发布 |
编译产物位于 `target/` 目录:
- debug 模式:`target/debug/`
- release 模式:`target/release/`
### 4.4 Cargo.lock
首次 `cargo build` 会生成 `Cargo.lock`,记录依赖的**精确版本号**(包括间接依赖),确保同一项目在不同机器上编译结果一致。
- 你永远不需要手动编辑这个文件,Cargo 会自动管理。
- 对于可执行程序,建议将 `Cargo.lock` 纳入版本控制(Git);对于库项目则无需提交。
---
## 五、猜数字游戏
本节通过一个完整示例,逐步引入 Rust 的核心概念。
### 5.1 处理用户输入
```rust
use std::io; // 将 io 模块引入当前作用域
fn main() {
println!("Guess the number!");
println!("Please input your guess.");
let mut guess = String::new(); // 创建可变 String 变量,初始为空
io::stdin() // 获取标准输入句柄
.read_line(&mut guess) // 读取一行到 guess,&mut 表示可变引用
.expect("Failed to read line"); // 如果读取失败则崩溃并打印此信息
println!("You guessed: {guess}"); // {} 是占位符,会替换为变量值
}
```
**知识点梳理:**
#### `use` 语句
将模块/类型引入当前作用域,避免写完整路径。类似于 Python 的 `from ... import`。
```rust
use std::io; // 现在可以直接写 io::stdin()
// 如果不写 use,则需要写 std::io::stdin()
```
本次用到 `std::io` 标准库中的输入/输出功能。
#### `let` 与可变性(Mutability)
```rust
let x = 5; // 不可变绑定(默认)
let mut y = 5; // 可变绑定,允许修改
```
Rust 中变量**默认不可变**。这是安全性设计的重要一环——你不需要担心某个值在你不注意时被修改。需要修改时必须显式声明 `mut`。
#### `String::new()` — 关联函数
`String` 是标准库提供的**可增长、UTF-8 编码**的字符串类型。`::new` 中的 `new` 是 `String` 类型的**关联函数(Associated Function)**——类似于其他语言中的"静态方法",它不作用于某个实例,而是作用于类型本身。`new` 是 Rust 中创建新实例的惯用命名,这里用于创建一个空字符串。
#### `&mut guess` — 可变引用
```rust
read_line(&mut guess)
```
- `&` 表示**引用(Reference)**,允许函数访问数据而不获取所有权(Ownership)。
- `&mut` 表示**可变引用**,被引用方可以修改所指向的数据。
- `read_line` 需要可变引用,因为它要向 `guess` 中追加用户输入的内容。
> 所有权和引用是 Rust 最核心的安全机制,后续课程会详细展开。
#### `Result` 枚举与 `expect`
```rust
io::stdin().read_line(&mut guess).expect("Failed to read line");
```
`read_line` 的返回类型是 `Result`,这是一个**枚举(Enum)**,有两个变体:
```rust
enum Result {
Ok(T), // 成功时包含返回值(这里是读取的字节数)
Err(E), // 失败时包含错误信息
}
```
`expect` 方法:
- 如果 `Result` 是 `Ok`,返回其中的值。
- 如果 `Result` 是 `Err`,程序**崩溃**并打印你传入的错误信息。
> 实际项目中更常用 `?` 运算符或 `match` 来优雅地处理错误,而不是直接 `expect`。后续课程会讲。
#### `println!` 占位符
```rust
println!("You guessed: {guess}");
```
`{}` 是占位符(与 C 的 `printf` 不同,Rust 无需指定 `%d`、`%s` 等格式),会自动根据类型格式化。多个值用逗号分隔:
```rust
println!("x = {}, y = {}", x, y);
```
---
### 5.2 生成秘密数字
Rust 标准库不包含随机数功能,需要引入第三方 crate:`rand`。
**步骤 1:添加依赖**
编辑 `Cargo.toml`:
```toml
[dependencies]
rand = "0.8.5"
```
`"0.8.5"` 是语义化版本约束,表示 `>= 0.8.5 且 < 0.9.0` 的版本均兼容。你也可以写 `"0.8"` 或使用更精确的约束如 `"^0.8.5"`。
当你下次执行 `cargo build` 时,Cargo 会自动:
1. 从 [crates.io](https://crates.io) 下载 `rand` 及其所有依赖。
2. 编译所有依赖。
3. 更新 `Cargo.lock` 锁定精确版本。
**步骤 2:使用 rand**
```rust
use std::io;
use rand::Rng; // 引入 Rng trait(包含 gen_range 等方法)
fn main() {
println!("Guess the number!");
let secret_number = rand::thread_rng().gen_range(1..=100);
// thread_rng():获取当前线程的随机数生成器
// gen_range(1..=100):生成 1 到 100(闭区间,含100)之间的随机数
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
}
```
**知识点:**
- `rand::thread_rng()` — 返回当前线程的**线程局部**随机数生成器,使用 CSPRNG(密码安全伪随机数生成器)。
- `gen_range(1..=100)` — `1..=100` 是**闭区间**范围(含 100),对应的半开区间写法是 `1..101`。
- `Rng` 是一个 **trait**(类似其他语言中的接口),`gen_range` 方法定义在 `Rng` trait 中,必须先 `use rand::Rng` 才能调用。
> Cargo.lock 确保任何人拉取你的项目后运行 `cargo build` 都会得到完全相同的依赖版本,从 `Cargo.toml` 的宽松版本号回到 `Cargo.lock` 的精确版本号。这个机制保证了可重现构建(Reproducible Build)。
---
### 5.3 比较数字
```rust
use std::cmp::Ordering; // 引入 Ordering 枚举
use std::io;
use rand::Rng;
fn main() {
println!("Guess the number!");
let secret_number = rand::thread_rng().gen_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = guess // shadowing:新建同名变量,类型从 String 转为 u32
.trim() // 去除首尾空白字符(包括换行符 \n)
.parse() // 将字符串解析为指定类型(由 : u32 类型注解决定)
.expect("Please type a number!");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) { // cmp 返回 Ordering 枚举值
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}
```
#### 你初次尝试编译会遇到的类型错误
```
error[E0308]: mismatched types
expected reference `&String`
found reference `&{integer}`
```
`guess`(String)和 `secret_number`(i32 / u32 等整数类型)类型不同,Rust 不允许直接比较。所以我们需要做类型转换。
#### 遮蔽(Shadowing)
```rust
let mut guess = String::new(); // 第一次声明:String 类型
// ... 读取输入 ...
let guess: u32 = guess // 第二次声明:u32 类型,遮蔽了前面的 guess
.trim()
.parse()
.expect("Please type a number!");
```
遮蔽让你可以**重用变量名**,同时改变其类型和可变性。这与 `mut` 不同:
| 特性 | `mut` | 遮蔽 |
| -------------- | -------- | -------------------------------- |
| 能否改变类型 | 否 | 是 |
| 赋值后是否可变 | 是 | 取决于新声明的 `let` / `let mut` |
| 旧值 | 直接修改 | 旧值被"隐藏",底层数据可能仍存在 |
> 遮蔽是 Rust 的惯用写法,尤其适合类型转换场景——与其发明 `guess_str` 这样的变量名,不如直接用 `let` 覆盖。
#### `trim()` 与 `parse()`
- `trim()` — 返回 `&str`,去除字符串首尾的空白字符(空格、制表符、换行符等)。这里用来去掉用户按回车时产生的 `\n`。
- `parse()` — 返回 `Result`。目标类型 `T` 由左侧的**类型注解** `: u32` 决定(Rust 的类型推断是双向的)。
#### `match` 表达式
```rust
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
```
`match` 由**分支(Arm)** 组成,每个分支:`模式 => 表达式`。
**关键特性:**
- **穷尽性(Exhaustiveness)**:必须覆盖所有可能的分支,否则编译报错。这里 `Ordering` 恰好有 `Less`、`Greater`、`Equal` 三个变体,全部处理了。
- `cmp` 是值的比较方法,返回 `Ordering` 枚举:
```rust
enum Ordering {
Less,
Equal,
Greater,
}
```
---
### 5.4 循环与退出
```rust
use std::cmp::Ordering;
use std::io;
use rand::Rng;
fn main() {
println!("Guess the number!");
let secret_number = rand::thread_rng().gen_range(1..=100);
println!("The secret number is: {secret_number}");
loop { // 无限循环
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = guess.trim().parse().expect("Please type a number!");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break; // 猜对后跳出循环
}
}
}
}
```
**`loop` 循环:**
- `loop` 创建无限循环,等价于 `while true`,但 Rust 编译器知道 `loop` 至少会执行一次。
- 可使用 `break` 退出循环,`continue` 跳到下一次迭代。
- `loop` 可以带返回值(将值放在 `break` 后面),这是 Rust 独有的特性:
```rust
let result = loop {
// ...
break 42; // loop 的返回值
};
```
---
### 5.5 处理无效输入
当前的程序,如果用户输入非数字(如 "abc"),`parse().expect()` 会导致程序崩溃。我们希望忽略无效输入,让用户继续猜:
```rust
// 将原来的
let guess: u32 = guess.trim().parse().expect("Please type a number!");
// 改为 match 处理 Result
let guess: u32 = match guess.trim().parse() {
Ok(num) => num, // 解析成功,将数值绑定到 num,作为 match 表达式的值
Err(_) => continue, // 解析失败,忽略本次输入,进入下一次循环
};
```
**知识点:**
- 这里用 `match` 优雅地处理了 `Result` 的两种可能,替代了粗暴的 `expect` 崩溃。
- `Err(_)` 中的 `_` 是**通配符**,表示"匹配任意错误值,但我不关心它的内容"。
- `continue` 跳回循环开头,让用户重新输入。
---
### 5.6 完整代码
```rust
use std::cmp::Ordering;
use std::io;
use rand::Rng;
fn main() {
println!("Guess the number!");
let secret_number = rand::thread_rng().gen_range(1..=100);
loop {
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}
```
(正式发布时可将打印 `secret_number` 那行删除,否则游戏就没有意义了。)
---
## 六、本节知识点汇总
| 概念 | 简要说明 |
| ----------------------------- | ----------------------------------------- |
| `rustup` / `rustc` / `cargo` | 工具链管理器 / 编译器 / 包管理器+构建系统 |
| `fn main()` | 程序入口 |
| `println!` | 宏(带 `!`),格式化输出并换行 |
| `let` / `let mut` | 变量绑定,默认不可变 |
| `use` | 将模块/类型引入作用域 |
| `String` / `&str` | 可增长字符串 / 字符串切片 |
| `String::new()` | 关联函数(静态方法),创建空字符串 |
| `&mut guess` | 可变引用,被引用方可以修改数据 |
| `Result` | 枚举:`Ok(T)` 成功 / `Err(E)` 失败 |
| `expect(msg)` | `Result` 的方法,成功取值、失败崩溃 |
| `match` | 模式匹配,穷尽性检查 |
| 遮蔽(Shadowing) | 用 `let` 重新声明同名变量,可改变类型 |
| `trim()` | 去除首尾空白 |
| `parse()` | 字符串解析为目标类型,返回 `Result` |
| `loop` / `break` / `continue` | 无限循环 / 退出 / 下一次迭代 |
| `Cargo.toml` / `Cargo.lock` | 项目配置 / 依赖精确版本锁定 |
| `edition` | Rust 语言版本代号(2015/2018/2021/2024) |
| Crate | Rust 的包单元(库/可执行文件) |
| Trait | 定义共享行为的接口,如 `Rng` |
---
## 七、课后练习
1. 修改猜数字游戏的数字范围为 `1..=1000`,观察程序行为变化。
2. 试着把 `println!("You guessed: {guess}");` 中的 `{guess}` 改为 `{}`,将 `guess` 作为第二个参数传入,体会位置参数写法。
3. 在循环中加入一个计数器,记录用户猜了几次才猜中,并在猜中后打印出来。
4. 尝试用 `cargo build --release` 编译项目,比较 `target/debug/` 和 `target/release/` 中可执行文件的大小差异。
5. (选做)查看 `cargo doc --open` 命令的效果——它会为你的项目及其依赖生成 HTML 文档并在浏览器中打开。]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[阶段一:培训]]>
https://kyriechao.github.io/posts/2026/07/24-phase1
2026-07-24T02:00:00.000Z
**时间范围**:2026 年 7 月 — 2027 年 6 月(12 个月)
> **两段式**:上半年(7-12 月)完成机构培训,下半年(1-6 月)实习 + 毕业。
---
## 当前起点
- 在北京昌平,机构培训刚开始
- 培训机构有四阶段路线:Linux C → 嵌入式应用 → MCU → Linux 驱动
- 2026 年 12 月底培训结束,2027 年 6 月学校毕业
- 长期愿景见 [总纲](./24-plan)
---
## 上半场:培训期(2026.07 — 2026.12,6 个月)
> 目标是**跟上每一节课,每一行代码都自己敲一遍**。6 个月很紧,不存在"后面再补"。
### 1. Linux C 语言与数据结构(约 7-8 月)
| 模块 | 内容 | 自检 |
|------|------|------|
| Linux 基本命令 | 文件操作、用户管理、网络管理、权限 | 不用查资料能完成日常操作 |
| C 语言基础 | 变量、运算符、控制语句、函数 | 徒手写无语法错误 |
| C 语言核心 | 数组、指针、结构体、联合体 | 能解释"指针的指针"和应用场景 |
| 数据结构 | 顺序表、链表、栈、队列、树 | 能手写每种结构的增删改查 |
**检验标准**:给你一个 C 编程题(如实现字符串库函数、链表逆序),不查资料能写对。
### 2. 嵌入式应用开发(约 9-10 月)
| 模块 | 内容 | 自检 |
|------|------|------|
| UNIX 环境编程 | 文件 IO、进程、线程、信号、IPC、网络编程 | 能写一个并发网络服务器 |
| 阶段项目 | UDP 多媒体组播系统 | **这是简历上第一个项目,认真做** |
| C++ | 封装、继承、多态、智能指针、STL | 能读懂 C++ 项目代码 |
| QT | 信号与槽、常用组件 | 能搭一个带 UI 的小工具 |
**检验标准**:组播项目能跑通,且能给别人讲清楚架构和数据流。
### 3. MCU 开发:裸机与 RTOS(约 11 月)
| 模块 | 内容 | 自检 |
|------|------|------|
| ARM 体系结构 | 寄存器、中断向量、时钟树 | 能对着芯片手册查寄存器 |
| 外设驱动 | GPIO、LED、USART、I2C、SPI | 手写驱动,不靠 HAL 生成 |
| 项目 | 物联网数据采集器 | **简历上第二个项目** |
**检验标准**:传感器数据能采集到并通过串口打印出来。
### 4. Linux 内核驱动开发(约 12 月)
| 模块 | 内容 | 自检 |
|------|------|------|
| 构建嵌入式 Linux | Uboot、Kernel、BuildRoot | 能自己编译出一个能跑的系统 |
| 内核编程 | 模块、调试、链表、文件操作 | 能写一个简单的内核模块 |
| 设备驱动 | 字符设备驱动框架 | 能写一个 LED 的字符驱动 |
| 面试突击 | 常见面试题、项目梳理 | —— |
**检验标准**:能讲清楚"用户态程序怎么调用到驱动"这条链路。
### 培训期总产出
- [ ] UDP 多媒体组播系统(可写进简历)
- [ ] 物联网数据采集器(可写进简历)
- [ ] 一个简单的 Linux 字符驱动
- [ ] 每天一行不落地敲完所有课堂代码
---
## 下半场:实习期(2027.01 — 2027.06,6 个月)
> 培训结束后的核心任务:**找到一份嵌入式实习,积累真实的工程经验**。
### 实习目标
| 优先级 | 目标 | 说明 |
|------|------|------|
| P0 | 找到一份嵌入式相关实习 | 优先单片机/驱动方向,QT 上位机也可作为保底 |
| P1 | 实习期间至少参与一个完整的产品/项目开发 | 哪怕只负责一个小模块,完整跟下来 |
| P2 | 确认自己更偏好"应用层"还是"底层" | 这个几乎只能靠实习来验证 |
### 找实习时间线
| 时间 | 动作 |
|------|------|
| 12 月下旬 | 整理简历,两个培训项目写清楚,附 GitHub 链接 |
| 1 月初 | 开始投递,同学/老师/机构的内推渠道优先 |
| 1-2 月 | 面试 + 入职 |
| 3-6 月 | 实习 + 毕业设计/论文 |
### 简历项目包装要点
1. **UDP 多媒体组播系统**:强调 socket 编程、并发模型、协议设计
2. **物联网数据采集器**:强调外设驱动、传感器通信、数据上报逻辑
3. 每个项目用"解决了什么问题 → 用了什么技术 → 达到了什么效果"的三段式描述
---
## 技术扩展(全年)
> 培训期课程已经很满,扩展只跟 1 个。
| 方向 | 深度 | 方式 |
|------|------|------|
| 智能硬件 | 了解 | 碎片时间看开源硬件项目(ESP32、树莓派),理解设计思路 |
AI 工程化、机器人、云端系统 **本阶段不碰**。
---
## 长期创造 — Kria 语言
> 培训期不动,放到实习稳定之后(3-4 月再用空闲时间启动)。
**目标不变**:产出一份 A4 篇幅的设计动机文档,回答三个问题:
1. Kria 解决什么问题?
2. 现有语言哪里不够用?
3. 如果只做一个差异特性,是什么?
---
## 认知建设
> 培训期节奏紧,目标压低,只读 2 本(半年一本)。
| 领域 | 任务 | 最低标准 |
|------|------|----------|
| 技术之外 | 读 1 本自己最感兴趣的领域(历史/经济/哲学/心理 任选) | 能复述核心观点 |
| 职业相关 | 读 1 本软件工程或嵌入式行业的经典书(如《程序员修炼之道》或《嵌入式系统设计》) | 有 5 条可用到实习中的收获 |
---
## 财富建设
| 项目 | 内容 |
|------|------|
| **记账** | 坚持到 12 月底,看培训期间总共花了多少钱 |
| **储蓄** | 实习工资的第一件事:存 20%,剩下的当生活费 |
| **学习** | 有空读 1 本理财入门书,没空先放一放 |
---
## 身体系统
> 培训期每天坐着上课,身体更容易出问题,这两个反而要守住。
| 习惯 | 标准 | 验收 |
|------|------|------|
| 固定睡眠 | 23:30 前躺下,7:00 前起 | 连续 28 天达标 |
| 每周运动 | 每次 ≥20 分钟,每周 ≥2 次 | 强度降低,频率守住 |
**培训期运动降级到每周 2 次、每次 20 分钟**——时间太紧,保持住"动"的习惯就行,别断。
---
## 社会连接
| 阶段 | 动作 |
|------|------|
| 培训期 | 加同学的微信、进技术群;GitHub 上把课堂练习整理成仓库 |
| 实习期 | 第一篇文章可以写"从培训到实习:嵌入式入门的真实感受";主动请同事吃饭请教问题 |
---
## 记录系统
| 形式 | 频率 | 最低标准 |
|------|------|----------|
| 日志 | 每天 | 今天学了什么 / 遇到什么坑 / 明天学什么(三行即可) |
| 复盘 | 每月 | 对着本文档逐项打分,偏差在哪里 |
| 学期总结 | 12 月底 | 培训期回顾 + 简历整理 |
| 年度总结 | 6 月底 | 阶段一整体回顾,制定阶段二 |
---
## 里程碑节点
| 时间 | 节点 | 内容 |
|------|------|------|
| 2026.08 | M1 · 上轨 | 日志习惯连续 30 天,C 语言 + 数据结构收尾 |
| 2026.10 | M2 · 深入 | UNIX 编程学完,组播项目完成,系统编程能力初具 |
| 2026.12 | M3 · 培训结业 | MCU + 驱动学完,简历整理完毕,开始投递 |
| 2027.03 | M4 · 实习中 | 实习在岗,Kria 设计动机动笔,写第一篇技术文章 |
| 2027.06 | M5 · 毕业 | 实习/试用期结束,毕业,阶段一总结,制定阶段二 |
---
## 不做清单(阶段一特供版)
- ❌ 培训期不自学课外技术——课上内容消化完已经是 100% 负荷
- ❌ 不跟同学比进度——按自己的节奏来,培训的目标是"学会了"不是"学完了"
- ❌ 实习不挑活——哪怕是写文档、调 UI 也是工程经验
- ❌ Kria 培训期不碰
- ❌ 不借钱投资 / 不碰杠杆
---
*下次审视:2026 年 8 月底(M1 节点)*
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[个人计划]]>
https://kyriechao.github.io/posts/2026/07/24-plan
2026-07-24T00:00:00.000Z
**本文定位**:5-10 年大方向总纲。具体执行计划见阶段性子文档(阶段一、阶段二……)。
**现状**:北京昌平,学习嵌入式方向。
---
## 1. 职业主线
| 项目 | 内容 |
|------|------|
| **方向** | 嵌入式系统工程师 |
| **目标** | 软硬件结合的系统能力 |
---
## 2. 技术扩展
以嵌入式为核心,向外延伸:
| 方向 | 说明 |
|------|------|
| 智能硬件 | 传感器、边缘计算、低功耗设计 |
| AI 工程化 | 模型部署、端侧推理、嵌入式 AI |
| 机器人 | 运动控制、ROS、机电一体化 |
| 云端系统 | 设备管理、数据通道、云边协同 |
---
## 3. 长期创造
### 3.1 Kria 语言
> 探索程序设计思想与系统设计思想,在软硬件结合场景中验证。
| 阶段 | 内容 |
|------|------|
| 1. 设计 | 完善语言设计文档,明确要解决的问题 |
| 2. 实现 | 解释器 / 编译器原型 |
| 3. 融合 | 探索软硬件结合场景 |
| 4. 应用 | 在实际项目中试用并迭代 |
### 3.2 个人技术品牌
- 技术博客 / 笔记输出
- 开源项目维护
- 社区分享与演讲
---
## 4. 认知建设
持续阅读,建立跨领域认知框架:
| 领域 | 目的 |
|------|------|
| 历史 | 理解社会变化规律 |
| 经济 | 理解资源流动逻辑 |
| 哲学 | 建立个人价值体系 |
| 心理学 | 理解人类行为模式 |
---
## 5. 财富建设
**目标**:建立长期资产,通过能力与认知积累财富。
**学习路径**:
- 个人财务管理
- 投资基础
- 企业分析
- 宏观经济
**原则**:不追求赌博式收益,靠能力和认知积累。
---
## 6. 身体系统
**目标**:保持长期高性能身体状态。
**习惯**:
- 固定睡眠时间
- 每周规律运动
- 控制体脂率
- 定期体检
---
## 7. 社会连接
- 开源项目参与
- 技术社区建设
- 同行交流合作
---
## 8. 记录系统
| 形式 | 频率 | 目的 |
|------|------|------|
| 日志 | 每日 | 捕捉当天思考与进展 |
| 复盘 | 每月 | 回顾得失,调整方向 |
| 年度总结 | 每年 | 对照计划,校准长期目标 |
---
## 不做清单
- ❌ 不追逐短期热点
- ❌ 不同时深入超过 3 个技术方向
- ❌ 不为了焦虑而学习
- ❌ 不用理论替代实践
## 阶段文档
- [阶段一:培训](./24-phase1.md)
## 下一步:阶段划分(预告)
> 后续将创建阶段性子文档,每个阶段包含:
> - 时间范围(如 2026.07 — 2027.07)
> - 阶段重点(从上方 8 个板块中选出当期聚焦项)
> - 可衡量指标
> - 阶段复盘节点
*大方向每年审视一次,阶段计划每季度微调。*
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Failure 框架指南]]>
https://kyriechao.github.io/posts/2026/03/2/26-operations-and-appendix
2026-03-26T04:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Failure 框架指南]]>
https://kyriechao.github.io/posts/2026/03/2/26-functional-result
2026-03-26T03:00:00.000Z
`,把失败当作“数据”来传递和组合。
## 2. 🔗 Result 链式操作
`Result` 封装了 `Success` 和 `Fail` 两种状态:
- `Result.ok(data)`:成功
- `Result.fail(code)` / `Result.fail(business)`:失败
```java
Result result = Result.ok("data")
.peek(s -> log.info("处理成功: {}", s)) // 成功副作用,不改变结果
.map(String::toUpperCase) // 成功值映射
.flatMap(s -> Result.ok(s + "_PROCESSED")) // 成功值映射到新的 Result
.recover(fail -> "DEFAULT_VALUE") // 失败降级:把 Fail 变成 Success 值
.peekError(fail -> log.warn("处理失败: {}", fail)) // 失败副作用
.fold( // 双路映射:把成功/失败都映射到同一类型
success -> "最终成功:" + success,
fail -> "最终失败:" + fail.getMessage()
);
```
补充说明:
- `recover(...)` 的 lambda 需要返回的是 `T`(解包后的值),如果你想返回 `Result`,请用 `recoverWith(...)`。
- `fold(...)` 返回的是 `Result`,不是直接 `R`(仍然保持“结果容器”的一致性)。
常用小技巧:
- “把失败变成默认值”:`recover(...)`
- “把成功值加一层校验”:`filter(predicate, code)`
```java
Result age = Result.ok(16)
.filter(a -> a >= 18, Code.AGE_INVALID, "未成年");
```
## 3. 🧰 Results 工具类全览
`Results` 适合做“批量/集合/副作用”相关的操作(静态工具方法)。
- **`tryOf()`**:捕获旧代码的异常并转为 Result。
```java
Result res = Results.tryOf(() -> dao.get(), Code.DB_ERR, "查询用户失败");
```
- **`tryRun()`**:把 `Runnable` 包装成 `Result`。
- **`fromOptional()`**:Optional 转 Result。
- **`sequence()`**:`List>` → `Result>`(fail-fast:有一个失败就返回失败)。
- **`sequenceAll()`**:全量收集版 sequence(失败会聚合成 `MultiBusiness`)。
- **`traverse()`**:先 map 再 sequence(fail-fast)。
- **`traverseAll()`**:全量收集版 traverse。
- **`partition()`**:同时拿到 successes 与 failures(更像“统计报表”)。
- **`fold()` (针对列表)**:对 `List>` 做归约(Reduce)。
- **`tap()` / `tapAsync()`**:对 Result 做“非破坏性”副作用(日志、埋点、异步通知等)。
```java
Result r = Results.tryOf(() -> dao.get(), Code.DB_ERR);
r = Results.tap(r, it -> log.info("当前结果: success={}, fail={}", it.isSuccess(), it.isFail()));
r = Results.tapAsync(r, it -> metrics.record(it));
```
## 4. 🌊 与 Java Stream API 集成
```java
Result> res = Result.ok(List.of("a", "b"));
res.stream().forEach(System.out::println); // 如果是 Fail,stream 会为空,不会报 NPE
```
## 5. 🧪 常见落地范式(推荐)
### 5.1 外部调用聚合(fail-fast)
当你有多个外部依赖,任意一个失败就直接失败:
```java
Result user = Results.tryOf(() -> userRepo.find(id), Code.DB_ERR);
Result order = Results.tryOf(() -> orderRepo.latest(id), Code.DB_ERR);
Result> all = Results.sequence(
user.map(u -> (Object) u),
order.map(o -> (Object) o)
);
```
### 5.2 外部调用聚合(全量收集)
当你希望“尽可能多拿到信息,同时把失败集中返回”:
```java
Result> users = Results.traverseAll(ids, uid ->
Results.tryOf(() -> userRepo.find(uid), Code.DB_ERR)
);
```
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Failure 框架指南]]>
https://kyriechao.github.io/posts/2026/03/2/26-declarative-validation
2026-03-26T02:00:00.000Z
create(@FailFastBody UserDTO dto) {
return ApiResponse.success("ok");
}
```
---
## 2. 🎭 `@Scene`:同一套 DTO 的“场景复用”
很多接口会复用 DTO,但不同场景的约束不同:
- CREATE:用户名/密码必填
- UPDATE:id 必填,其它字段可选
用法是“字段上标 `@Scene`,方法上用 `@Validate(scene=...)` 指定当前场景”:
```java
public class UserDTO {
@Scene(Scenario.UPDATE)
@NotNull
private Long id;
@Scene({Scenario.CREATE, Scenario.UPDATE})
@NotBlank
private String username;
}
@Validate(scene = Scenario.UPDATE)
public void update(@RequestBody UserDTO dto) { }
```
实现语义(很重要):
- `@Scene` 只影响 JSR-303 这部分的 violation 过滤
- 自定义 Validator 是否执行,仍由 `@Validate` 控制
---
## 3. 🛑 `@SkipValidation`:某个参数不参与校验
当方法上有 `@Validate` 时,切面会收集“可校验参数”。如果你希望某个参数完全跳过(例如某个包装对象、或者你就是不想校验它),用 `@SkipValidation`:
```java
@Validate
public void doSomething(UserDTO user, @SkipValidation HttpServletRequest request) { }
```
---
## 4. 🔍 Scope:集合/嵌套对象校验 + 精确路径
校验集合时,最值钱的是“路径精确到第几个元素的哪个字段”,例如:
- `[0].name`
- `users[2].address.city`
### 4.1 List 集合校验(推荐 PathEntry 写法)
```java
Failure.strict()
.notNull(users, ResponseCode.VALIDATION_ERROR_400, "用户列表不能为空")
.forEach(users, scope -> {
PathEntry name = scope.field(UserDTO::getUsername).as("name");
PathEntry email = scope.fieldEntry(UserDTO::getEmail);
PathEntry age = scope.fieldEntry(UserDTO::getAge);
scope.notBlank(name, ResponseCode.VALIDATION_ERROR_400)
.email(email, ResponseCode.VALIDATION_ERROR_400)
.positive(age, ResponseCode.VALIDATION_ERROR_400)
.done();
})
.failAll();
```
为什么要这么写?
- `field(getter)` 解析 getter 名称在 Java 里不可靠(会回退到默认 `"field"`),所以推荐用 `.as("name")` 显式指定展示名
- `fieldEntry(getter)` 直接返回 `PathEntry`,适合不需要改名的字段
### 4.2 Map 校验与 nested(思路相同)
- `forEachEntry(...)` 用于 Map 的 value 校验(路径会带上 key)
- `nested(...)` 用于对象嵌套(路径会自动追加子字段)
---
## 5. 🧬 TypedValidator:一个校验器处理多种类型
当你有多个 DTO/Command,希望统一用一个校验入口,但不同类型规则不同,推荐 `TypedValidator`:
```java
public class MyValidator extends TypedValidator {
@Override
protected void registerValidators() {
register(CreateCmd.class, (cmd, ctx) ->
Failure.with(ctx)
.notBlank(cmd.getName(), Code.NAME_EMPTY)
.verify()
);
register(UpdateCmd.class, (cmd, ctx) ->
Failure.with(ctx)
.notNull(cmd.getId(), Code.ID_EMPTY)
.verify()
);
}
}
```
这里用 `.verify()` 而不是 `.fail()`:
- `.verify()` 只把错误写入 `ctx`
- 是否抛错、抛一个还是抛多个,由外层 `@Validate(fast=...)` 统一决定
---
## 6. 🧾 `@FailFastBody`:可选 RequestBody(避免 400)
`@FailFastBody` 语义上等同 `@RequestBody`,但支持 `required=false`:
```java
@PostMapping("/search")
public ApiResponse search(@FailFastBody(required = false) QueryDTO dto) {
if (dto == null) {
return ApiResponse.success("no body");
}
return ApiResponse.success(dto);
}
```
---
## 7. 🧯 统一异常处理与日志定位(IDE 可点击跳转)
失败时会返回统一 JSON,且日志中会带上 `(SomeClass.java:34)` 这种可点击定位信息,排查体验非常好。
TraceId 说明:
- 默认关闭(`fail-fast.trace-id.enabled=false`):响应体不返回 `traceId`
- 显式开启(`enabled=true`):响应体/响应头/MDC 按配置生效
---
## 8. 🧩 OpenAPI(Swagger)集成
如果你需要让 Swagger UI 展示统一错误结构,可以引入 `failure-openapi-springdoc-starter` 相关模块进行增强。
注意事项:
- Springdoc 与 Spring Boot 的版本要匹配,避免传递依赖引入不兼容的 Boot 版本导致启动异常。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Failure 框架指南]]>
https://kyriechao.github.io/posts/2026/03/2/26-programmatic-validation
2026-03-26T01:00:00.000Z
s.startsWith("A"), ErrorCode.MUST_START_WITH_A)
.fail();
```
- **控制流:`when()` 与 `resume()` 状态开关**:
你可以通过 `when(boolean)` 动态开启或关闭后续的校验逻辑:
```java
Failure.begin()
.when(user.isVip()) // 如果不是 VIP,后续校验将被忽略
.notNull(user.getVipLevel(), Code.VIP_LEVEL_REQUIRED)
.resume() // 恢复全量校验模式
.notBlank(user.getUsername(), Code.NAME_BLANK)
.fail();
```
### 2.1 常用方法速查(字符串)
如果你在写“用户注册/登录”一类的校验,这些会非常常见:
- `notBlank(str)` / `blank(str)`
- `lengthBetween(str, min, max)`
- `match(str, regex)`
- `email(email)`
- `startsWith/endsWith/contains`
示例(完全符合当前代码实现):
```java
Failure.begin()
.notBlank(email, Code.EMAIL_EMPTY)
.email(email, Code.EMAIL_INVALID)
.lengthBetween(password, 8, 32, Code.PASSWORD_LENGTH)
.fail();
```
## 3. 🚦 短路逻辑控制
在 `strict()` 模式下,有时你希望某个关键错误发生后**局部短路**:
```java
Failure.strict()
.notNull(user, Code.USER_NULL)
.stopOnFail() // 如果 user 是 null,立刻停下,防止下面的 getUsername 报 NPE!
.notBlank(user.getUsername(), Code.NAME_BLANK)
.resume() // 恢复全量收集模式
.failAll();
```
同时支持组合条件:`.or(chain -> chain.notNull(a).notNull(b))` 满足其一即可。
## 4. 🧳 延迟计算 (defer)
如果你需要在校验链中执行一些耗时的数据库查询,可以使用 `defer`,它只在前面的校验都通过时才会执行:
```java
Failure.begin()
.notBlank(user.getUsername(), Code.NAME_BLANK)
.defer(() -> userService.findByUsername(user.getUsername()) == null, Code.USER_EXISTS)
.fail();
```
## 5. 🧩 上下文复用与终结方法对比
在普通的 Service/Controller 中,你通常会使用 `.fail()`(快速失败)或 `.failAll()`(全量收集)来**直接抛出异常**。
但当你编写被 AOP 切面托管的自定义校验器时,你需要复用切面传进来的上下文:
- **`Failure.with(ctx)`**:基于现有的 `ValidationContext` 启动校验,继承外层的收集模式(fast/strict)。
- **`verify()` vs `fail()`**:
- `.fail() / .failAll()`:**立即抛出** `Business / MultiBusiness` 异常,中断当前线程。
- `.verify()`:**不抛出异常**,它仅仅是将错误写入 `ctx` 并触发监控埋点。异常抛出的动作将由外层的 `@Validate` 切面统一接管。
```java
// 在自定义校验器中
public void validate(User user, ValidationContext ctx) {
Failure.with(ctx) // 复用上下文
.notBlank(user.getName(), Code.NAME_EMPTY)
.verify(); // 仅记录错误,不抛出异常
}
```
### 5.1 如何选 verify / fail(一句话)
- 你自己写的业务流程里:选 `fail()/failAll()`(立刻抛错,控制流清晰)。
- 你写的是被 `@Validate` 触发的校验器:选 `verify()`(把“抛错权”交给切面统一处理)。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Failure 框架指南]]>
https://kyriechao.github.io/posts/2026/03/2/26-quick-start
2026-03-26T00:00:00.000Z
io.github.kyriechao
failure-spring-boot-starter
1.1.1
```
如果你还没有引入参数校验依赖,建议同时引入:
```xml
org.springframework.boot
spring-boot-starter-validation
```
---
## 3. ⚙️ 自动配置会帮你做什么
引入 Starter 后,自动配置类会把关键能力装配进 Spring 容器(无需手工注册):
- `@Validate` 的 AOP 切面:统一触发 JSR-303 + 自定义 Validator
- `@FailFastBody` 的参数解析增强:支持 “可选 body”
- 默认异常处理:统一输出 JSON(`Business / MultiBusiness / JSR-303` 异常都会被处理)
---
## 4. 🧪 第一个可运行示例(编程式 vs 声明式)
下面给你一套“对照组”,看完你就能分清两种使用方式:
### 4.1 编程式:Service 里链式校验(推荐用于复杂业务规则)
```java
Failure.begin()
.notBlank(dto.getName(), Code.NAME_EMPTY)
.positive(dto.getAge(), Code.AGE_INVALID)
.fail(); // 触发抛错(fail-fast)
```
如果你希望一次性返回多个错误(全量收集):
```java
Failure.strict()
.notBlank(dto.getName(), Code.NAME_EMPTY)
.positive(dto.getAge(), Code.AGE_INVALID)
.failAll();
```
### 4.2 声明式:Controller/Service 方法上 `@Validate`
```java
@PostMapping("/users")
@Validate(scene = Scenario.CREATE, fast = false)
public ApiResponse create(@FailFastBody UserDTO dto) {
return ApiResponse.success("ok");
}
```
它会做两件事:
1) 先走 `jakarta.validation`(DTO 上的 `@NotNull/@NotBlank/...`)
2) 再走你指定的自定义校验器(`FastValidator` / `TypedValidator`)
---
## 5. 📤 失败时会返回什么
失败时默认会返回统一 JSON(字段可能会随 verbose/trace-id 配置有所变化):
```json
{
"code": 400,
"message": "参数校验失败",
"description": "参数校验失败",
"errors": [
{
"path": "name",
"code": 400,
"rejected": "",
"detail": "不能为空",
"message": "参数校验失败"
}
],
"timestamp": "2026-03-26 15:17:59"
}
```
---
## 6. 🧾 TraceId(默认关闭,按需开启)
如果你希望前端拿到 `traceId` 用于反查日志,可以开启:
```yaml
fail-fast:
trace-id:
enabled: true
header-name: X-Trace-Id
response-header: true
response-header-name: X-Trace-Id
mdc-enabled: true
mdc-key: traceId
generate-if-missing: true
```
如果你显式关闭:
```yaml
fail-fast:
trace-id:
enabled: false
```
则异常响应体将不返回 `traceId` 字段(“关掉就是彻底没有”)。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[数学笔记:傅里叶变换基础]]>
https://kyriechao.github.io/posts/2026/03/1/12-math-notes
2026-03-12T00:00:00.000Z
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Java 零基础入门:从 Hello World 到核心语法]]>
https://kyriechao.github.io/posts/2026/03/1/11-java-operators-and-control-flow
2026-03-11T00:00:00.000Z
💡 注意:
> - 整数相除结果仍是整数(小数部分直接丢弃)。
> - `++x`(先加后用) vs `x++`(先用后加):
```java
int a = 5;
int b = a++; // b = 5, a = 6
int c = ++a; // a = 7, c = 7
```
---
### 1.2 赋值运算符
将右边的值赋给左边的变量:
| 运算符 | 等价写法 | 说明 |
|--------|----------------|--------------|
| `=` | `x = 5` | 基本赋值 |
| `+=` | `x = x + 5` | 加后赋值 |
| `-=` | `x = x - 5` | 减后赋值 |
| `*=` | `x = x * 5` | 乘后赋值 |
| `/=` | `x = x / 5` | 除后赋值 |
| `%=` | `x = x % 5` | 取余后赋值 |
```java
int count = 10;
count += 3; // 相当于 count = count + 3 → 13
```
---
### 1.3 比较运算符
用于比较两个值,**结果总是 `boolean`(true/false)**:
| 运算符 | 含义 | 示例 |
|--------|----------|------------------|
| `==` | 等于 | `5 == 5 → true` |
| `!=` | 不等于 | `5 != 3 → true` |
| `>` | 大于 | `5 > 3 → true` |
| `<` | 小于 | `5 < 3 → false` |
| `>=` | 大于等于 | `5 >= 5 → true` |
| `<=` | 小于等于 | `5 <= 3 → false` |
> ⚠️ **重要区别:`==` 对基本类型 vs 引用类型**
>
> - **基本类型**:比较的是**值**
> ```java
> int a = 100;
> int b = 100;
> System.out.println(a == b); // true
> ```
> - **引用类型(如 String)**:比较的是**内存地址**(是否同一个对象)
> ```java
> String s1 = new String("hello");
> String s2 = new String("hello");
> System.out.println(s1 == s2); // false(不同对象)
> System.out.println(s1.equals(s2)); // true(内容相同)
> ```
> ✅ **记住:比较字符串内容请用 `.equals()`,不是 `==`!**
---
### 1.4 逻辑运算符
用于组合多个布尔表达式:
| 运算符 | 名称 | 特性 | 示例 |
|--------|------------|--------------------|-------------------------|
| `&&` | 逻辑与 | **短路**:左为 false 则不计算右边 | `(x > 0) && (y < 10)` |
| `\|\|` | 逻辑或 | **短路**:左为 true 则不计算右边 | `(x == null) || x.isEmpty()` |
| `!` | 逻辑非 | 取反 | `!(age < 18)` |
> 💡 **短路特性实战:避免空指针**
>
> ```java
> String str = null;
> // 如果 str 是 null,str.length() 会抛异常!
> // 但用 && 可以安全判断:
> if (str != null && str.length() > 0) {
> System.out.println("非空字符串");
> }
> // 因为 str != null 为 false,右边根本不会执行!
> ```
---
### 1.5 位运算符(简要了解)
操作二进制位,常用于底层开发或性能优化(初学者知道即可):
| 运算符 | 说明 | 示例(假设 a=5(101), b=3(011)) |
|--------|------------|----------------------------------|
| `&` | 按位与 | `a & b → 1`(001) |
| `\|` | 按位或 | `a \| b → 7`(111) |
| `^` | 按位异或 | `a ^ b → 6`(110) |
| `~` | 按位取反 | `~a → -6`(补码表示) |
| `<<` | 左移 | `a << 1 → 10`(相当于 ×2) |
| `>>` | 右移(带符号)| `a >> 1 → 2`(相当于 ÷2) |
| `>>>` | 无符号右移 | 忽略符号位,高位补 0 |
> 📌 初学可跳过,面试或系统编程时再深入。
---
### 1.6 三元运算符(条件运算符)
简洁的 `if-else` 写法:
```java
// 语法:条件 ? 表达式1 : 表达式2
String result = (score >= 60) ? "及格" : "不及格";
```
> 💡 **示例:判断奇偶数**
>
> ```java
> int num = 7;
> String parity = (num % 2 == 0) ? "偶数" : "奇数";
> System.out.println(num + " 是 " + parity); // 7 是 奇数
> ```
> ✅ 优点:代码简短
> ❌ 缺点:嵌套多层会难读(建议只用于简单判断)
---
好的!以下是 **“流程控制(Control Flow)”** 的完整 Markdown 内容,从 **第 2 节开始编号**(即 `## 2. 流程控制`),风格与你第一篇完全一致:零基础友好、代码清晰、带实用提示和常见坑点。
你可以直接复制粘贴到你的第二篇教程中。
---
## 2. 流程控制(Control Flow)
程序默认从上到下逐行执行。但现实中的逻辑往往需要**根据条件跳过某些代码**,或**重复执行一段操作**——这就是流程控制的作用。
Java 提供了三种主要的流程控制结构:**条件判断**(if / switch)、**循环**(for / while / do-while)。
---
### 2.1 条件语句:`if` / `else if` / `else`
根据布尔表达式的真假决定是否执行某段代码。
```java
int age = 20;
if (age < 13) {
System.out.println("儿童");
} else if (age < 18) {
System.out.println("青少年");
} else {
System.out.println("成年人");
}
// 输出:成年人
```
> ✅ **最佳实践**:
> - 条件尽量简单,复杂逻辑可提取为变量提高可读性:
> ```java
> boolean isTeenager = age >= 13 && age < 18;
> if (isTeenager) {
> System.out.println("青少年");
> }
> ```
> - 避免深层嵌套,尽早 `return` 或使用卫语句(guard clause)。
---
### 2.2 多分支选择:`switch`
当需要根据**一个变量的多个可能值**做不同处理时,用 `switch` 更清晰。
#### 传统写法(适用于所有 Java 版本)
```java
char grade = 'B';
switch (grade) {
case 'A':
System.out.println("优秀");
break; // 必须加!否则会“穿透”到下一个 case
case 'B':
System.out.println("良好");
break;
case 'C':
System.out.println("及格");
break;
default:
System.out.println("未知等级");
}
// 输出:良好
```
> ⚠️ **注意**:
> - `case` 后只能是**常量**(字面量或 `final` 变量)。
> - 忘记写 `break` 会导致 **fall-through(穿透)**,通常是个 bug!
#### Java 14+ 新语法(更安全简洁,可选了解)
```java
// 使用 -> 代替 break,自动跳出
switch (grade) {
case 'A' -> System.out.println("优秀");
case 'B' -> System.out.println("良好");
case 'C' -> System.out.println("及格");
default -> System.out.println("未知等级");
}
```
> 💡 **支持的类型**:`byte`/`short`/`int`/`char`、`String`、枚举(`enum`)
> (不支持 `long`、`float`、`double`、`boolean`)
---
### 2.3 循环语句
#### 2.3.1 `for` 循环(已知循环次数时首选)
```java
// 打印 1 到 5
for (int i = 1; i <= 5; i++) {
System.out.println("第 " + i + " 次");
}
```
- **初始化**:`int i = 1`(只执行一次)
- **条件判断**:`i <= 5`(每次循环前检查)
- **更新操作**:`i++`(每次循环后执行)
> 💡 小技巧:想倒序?`for (int i = 5; i >= 1; i--)`
#### 2.3.2 增强 `for` 循环(遍历数组或集合)
```java
int[] numbers = {10, 20, 30};
for (int num : numbers) {
System.out.println(num);
}
// 输出:10 20 30
```
> ✅ 优点:代码简洁,不易出错
> ❌ 缺点:无法获取索引,不能修改原数组元素(但可读)
#### 2.3.3 `while` 循环(条件为真时重复)
```java
int count = 3;
while (count > 0) {
System.out.println("倒计时:" + count);
count--;
}
// 输出:倒计时:3 → 2 → 1
```
> ⚠️ **小心死循环**!确保循环体内有改变条件的语句。
#### 2.3.4 `do-while` 循环(至少执行一次)
```java
import java.util.Scanner;
Scanner sc = new Scanner(System.in);
int input;
do {
System.out.print("请输入一个正数: ");
input = sc.nextInt();
} while (input <= 0);
System.out.println("你输入的是: " + input);
```
> ✅ 适用场景:菜单选择、用户输入验证等需要**先执行再判断**的情况。
---
### 2.4 控制循环:`break` 与 `continue`
- `break`:**立即退出整个循环**
- `continue`:**跳过本次循环剩余代码,进入下一次**
```java
for (int i = 1; i <= 5; i++) {
if (i == 3) {
continue; // 跳过 i=3
}
if (i == 5) {
break; // 到 i=5 时退出循环
}
System.out.println(i);
}
// 输出:1 2 4
```
> 💡 **标签(label)跳转**(高级用法,了解即可):
> ```java
> outer: for (int i = 0; i < 3; i++) {
> for (int j = 0; j < 3; j++) {
> if (i == 1 && j == 1) {
> break outer; // 跳出外层循环
> }
> System.out.println(i + "," + j);
> }
> }
> ```
---
### 2.5 常见误区与调试技巧
| 问题 | 错误示例 | 正确做法 |
|------|--------|-------------------------|
| 忘记大括号 | `if (x > 0) System.out.println("正"); x++;` | 虽然一行不会错但是加了更清楚 `{}` |
| `==` 比较字符串 | `if (str == "hello")` | 用 `str.equals("hello")` |
| 数组越界 | `for (int i=0; i<=arr.length; i++)` | 条件应为 `i < arr.length` |
| 死循环 | `while (true) { ... }`(无退出条件) | 确保有 `break` 或条件变化 |
> 🔍 **调试建议**:在循环中打印变量值,观察变化过程。
---]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Python 数据分析入门:Pandas 实战]]>
https://kyriechao.github.io/posts/2026/03/1/11-python-data-analysis
2026-03-11T00:00:00.000Z
25]
print(older_than_25)
```
### 3. 数据统计
Pandas 提供了丰富的统计方法:
```python
print(f"平均年龄: {df['Age'].mean()}")
print(f"最大年龄: {df['Age'].max()}")
```
## 进阶技巧:分组与聚合
```python
# 按城市分组并计算平均年龄(示例数据量太小,仅作演示)
grouped = df.groupby('City')['Age'].mean()
```
## 结语
Pandas 的功能远不止于此。配合 Matplotlib 或 Seaborn,你还可以轻松画出精美的图表。
> **提示**: 在处理大型数据集时,注意内存的使用情况。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Next.js 14 实战系列 (二):深入理解路由与布局]]>
https://kyriechao.github.io/posts/2026/03/1/10-nextjs-tutorial-2
2026-03-10T00:00:00.000Z
关于我们;
}
```
现在访问 `/about`,Next.js 会自动渲染这个组件。这就是**文件系统路由**的魔力。
## 2. 动态路由
如果我们需要为每篇博客文章生成一个页面,比如 `/posts/1`、`/posts/2`,就需要用到动态路由。
创建 `app/posts/[id]/page.tsx`:
```tsx
export default function Post({ params }: { params: { id: string } }) {
return Post ID: {params.id}
;
}
```
## 3. 嵌套布局 (Nested Layouts)
Next.js 允许你为特定的路由段定义布局。例如,你可以为博客部分创建一个侧边栏布局,而不影响首页。
```tsx
// app/blog/layout.tsx
export default function BlogLayout({
children,
}: {
children: React.ReactNode
}) {
return (
{children}
)
}
```
### 总结
- `page.tsx` 定义路由的 UI。
- `layout.tsx` 定义共享 UI。
- `[folderName]` 创建动态路由段。
掌握这些规则,你就能构建出复杂的应用结构了。下一章我们将讨论数据获取 (Data Fetching)。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Next.js 14 实战系列 (一):从零开始搭建博客]]>
https://kyriechao.github.io/posts/2026/03/0/09-nextjs-tutorial-1
2026-03-09T00:00:00.000Z
Hello, Next.js 14!
);
}
```
运行 `npm run dev`,打开浏览器访问 `http://localhost:3000`,你应该能看到我们的新页面了。
---
下一篇文章中,我们将学习如何添加 Markdown 支持来渲染博客文章。敬请期待!
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Java 零基础入门:从 Hello World 到核心语法]]>
https://kyriechao.github.io/posts/2026/03/0/10-java-basics
2026-03-09T00:00:00.000Z
不跳过任何基础,从最简单的 `System.out.println` 讲起,带你真正理解输开发中必备的知识。
## 1. 环境准备
首先,确保你已经安装了 Java 8 或更高版本。
```bash
java --version
# java 17.0.16 2025-07-15 LTS
```
## 2. 创建项目
使用 `javac` 编译你的第一个 Java 程序:
用JetBrains IDEA创建一个Java项目(first-demo),并创建一个名为`Main.java`的文件。
```
first-demo/
├── src
│ └── Main.java # 入口类
└── out/ # 编译输出(自动创建)
```
## 3. 编写代码
```java
public class Main {
public static void main(String[] args) {
System.out.println("Hello, Java!");
}
}
```
## 4. 编译与运行
- 可以点击JetBrains IDEA的Current File 打印台即可出现Hello, Java!
- 也可以使用命令行编译和运行:
```bash
# 编译
javac src/Main.java -d out
# 运行
java -cp out Main
```
## 5. 运行结果
```
Hello, Java!
```
## 6. 数据类型与变量
Java 是**强类型语言**,每个变量必须先声明类型。数据类型分为**基本类型**(8种)和**引用类型**(数组、类、接口等)。
### 6.1 完整示例
```java
import java.util.Arrays;
public class Main {
public static void main(String[] args) {
// 整数类型(从小到大)
byte score = 90; // 8 bit -128 ~ 127
short height = 170; // 16 bit -32768 ~ 32767
int age = 25; // 32 bit ±21 亿(最常用)
long population = 1_000_000L; // 64 bit ±9×10¹⁸
// 浮点类型
float weight = 68.5f; // 32 bit,必须加 f
double price = 19.99; // 64 bit(默认,精度更高)
// 字符与布尔
char grade = 'A'; // 16 bit,单引号,存一个字符
boolean isStudent = true; // true 或 false
// 引用类型
String name = "Alice"; // 字符串,双引号,final class
int[] arr = {1, 2, 3, 4, 5}; // 数组,引用类型
// 特殊表示法
int bin = 0b1010; // 二进制(0b 开头)
int hex = 0xFF; // 十六进制(0x 开头)
double pi = 3.141_592_653; // 下划线分隔,提升可读性
String emoji = "\uD83D\uDE04"; // Unicode 表情 😄
char chinese = '中'; // 支持中文
// var 类型推断(Java 10+)
var message = "Hello"; // 编译器推断为 String
// 打印输出
System.out.println("Score: " + score);
System.out.println("Height: " + height);
System.out.println("Age: " + age);
System.out.println("Population: " + population);
System.out.println("Weight: " + weight);
System.out.println("Price: " + price);
System.out.println("Grade: " + grade);
System.out.println("Is Student: " + isStudent);
System.out.println("Name: " + name);
System.out.println("Array: " + Arrays.toString(arr)); // 注意这里
System.out.println("Binary 0b1010 = " + bin);
System.out.println("Hex 0xFF = " + hex);
System.out.println("Pi = " + pi);
System.out.println("Emoji: " + emoji);
System.out.println("Chinese: " + chinese);
System.out.println("Var: " + message);
}
}
```
### 6.2 关键点总结
| 类型 | 大小 | 范围/说明 | 注意 |
| :-------- | :----- | :------------- | :------------ |
| `byte` | 8 bit | -128 ~ 127 | 文件流、节省内存 |
| `short` | 16 bit | -32768 ~ 32767 | 很少用 |
| `int` | 32 bit | ±21亿 | 整数默认类型 |
| `long` | 64 bit | 很大 | 赋值加 `L` |
| `float` | 32 bit | 6~7位精度 | 赋值加 `f` |
| `double` | 64 bit | 15~16位精度 | 浮点默认类型 |
| `char` | 16 bit | 0 ~ 65535 | 单引号,存 Unicode |
| `boolean` | 1 bit | true/false | 不能转整数 |
### 6.3 常见坑
```java
// ❌ 错误:整数默认是 int,超出范围要加 L
long big = 3000000000; // 编译错误!30亿超过 int 范围
long big = 3000000000L; // ✅ 正确
// ❌ 错误:浮点默认是 double,不能直接赋给 float
float f = 3.14; // 编译错误!
float f = 3.14f; // ✅ 正确
// ❌ 错误:char 用双引号
char c = "A"; // 编译错误!String 不能赋给 char
char c = 'A'; // ✅ 正确
// ⚠️ 注意:数组直接打印是地址
System.out.println(arr); // [I@6d06d69c(地址)
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5] ✅
```
## 7. 类型转换
### 7.1 自动转换(小 → 大)
```java
byte b = 10;
int i = b; // ✅ 自动转,没问题
double d = i; // ✅ 自动转,没问题
```
### 7.2 强制转换(大 → 小)
```java
double d = 3.99;
int i = (int) d; // ✅ 强制转,i = 3(小数直接丢掉!)
int big = 130;
byte small = (byte) big; // ⚠️ 溢出!结果是 -126
```
### 7.3 字符串与其他类型互转
```java
// 任意类型 → String
String s1 = String.valueOf(123); // "123"
String s2 = 123 + ""; // "123"(偷懒写法)
// String → 数字
int num = Integer.parseInt("123"); // 123
double d = Double.parseDouble("3.14"); // 3.14
// 注意:格式不对会抛异常
int error = Integer.parseInt("abc"); // ❌ NumberFormatException
```
## 8. 常量与命名规范
```java
// 常量:final 修饰,全大写,单词间下划线分隔
final double PI = 3.14159;
final int MAX_SIZE = 100;
// 变量命名:小驼峰
int studentAge = 20;
String userName = "Tom";
// 类名:大驼峰(Main, StudentInfo)
// 方法名:小驼峰(getName, printInfo)
// 包名:全小写(com.example.demo)
```]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[重读《黑客与画家》有感]]>
https://kyriechao.github.io/posts/2026/03/0/08-hackers-and-painters
2026-03-08T00:00:00.000Z
黑客与画家的共同之处,在于他们都是创作者。与科学家不同,科学家的目的是发现真理,而黑客的目的是创造美好的事物。
这一点我深有同感。编程不仅仅是逻辑的堆砌,更是结构与美学的构建。优雅的代码就像一幅构图精巧的画作,不仅功能完善,而且易于理解和维护。
## 关于财富
PG 在书中关于财富的定义也非常深刻:**财富不是金钱,财富是我们需要的东西**(食物、衣服、房子、汽车、假期等)。金钱只是交换财富的媒介。
要创造财富,你需要做两件事:
1. **可测量性** (Measurement):你的贡献可以被量化。
2. **可放大性** (Leverage):你的工作成果可以被放大(例如通过软件服务千万人)。
## 结语
这本书不仅适合程序员阅读,也适合所有对创业、设计和思考感兴趣的人。它鼓励我们去创造、去打破常规、去追求卓越。
如果你还没有读过,强烈推荐!
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Markdown 功能展示与富文本示例]]>
https://kyriechao.github.io/posts/2026/03/0/08-markdown-demo
2026-03-08T00:00:00.000Z
这是一个引用块。
>
> 支持多行引用。
## 代码高亮
支持多种语言的语法高亮:
```python
def hello_world():
print("Hello, World!")
return True
if __name__ == "__main__":
hello_world()
```
```javascript
const greet = (name) => {
console.log(`Hello, ${name}!`);
};
greet('Kyrie');
```
## 列表展示
### 无序列表
- 项目一
- 项目二
- 子项目 A
- 子项目 B
### 有序列表
1. 第一步
2. 第二步
3. 第三步
### 任务列表
- [x] 已完成任务
- [ ] 待办任务
- [ ] 进行中...
## 表格示例
| 姓名 | 角色 | 技能 |
|:-----|:-----:|-----:|
| Kyrie | 开发者 | Ruby, Python |
| User | 访客 | 阅读, 评论 |
## 提示块 (Notices)
Next.js 博客使用 HTML/Tailwind 替代了 Jekyll 的 Kramdown 语法:
Primary Notice
这是一个主要提示块。
Warning Notice
这是一个警告提示块。
Danger Notice
这是一个危险/错误提示块。
## 按钮链接
## 图片与媒体
你可以在文章中插入图片:

## 数学公式
启用 MathJax 后,你可以编写 LaTeX 公式:
行内公式:$E = mc^2$
块级公式:
$$
\sum_{i=1}^n i = \frac{n(n+1)}{2}
$$
## 结语
这就是迁移到 Next.js 后的一些核心功能展示。快去尝试写一篇属于你的文章吧!
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[我的 2026 高效工作流分享]]>
https://kyriechao.github.io/posts/2026/03/0/08-productivity-workflow
2026-03-08T00:00:00.000Z
Trae 不仅仅是一个代码编辑器,它更像是一个智能编程助手。
### 主要优势
1. **智能补全**:AI 能够根据上下文准确预测我想要写的代码。
2. **自然语言指令**:我可以直接告诉它“帮我创建一个 React 组件”,它就能自动生成代码。
3. **集成终端**:无需离开编辑器即可运行命令。
## 结语
工具只是辅助,核心还是在于坚持和执行。找到适合自己的工作流,并不断优化它,才能真正提高效率。
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
<![CDATA[Tailwind CSS 实用技巧分享]]>
https://kyriechao.github.io/posts/2026/03/0/08-tailwind-tips
2026-03-08T00:00:00.000Z
自动适配暗黑模式的标题
```
## 总结
Tailwind CSS 极大地提高了前端开发的效率,一旦习惯了这种写法,你就很难回去了。希望这些小技巧对你有帮助!
]]>
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao
Kyrie Chao
chao893760@163.com
https://github.com/KyrieChao